很多做海外 B 端业务的朋友,在获客阶段最头疼的问题,往往不是找不到人,而是筛选成本太高。大家习惯在 LinkedIn 或各类名录里手动搜索,再逐个点开 Profile,查看对方的职位、公司规模和背景…
当开发者在2026年面对Qwen3这类模型时,本地部署的核心在于JSON输出的可靠性。针对Qwen3 35B A3B这款混合专家模型,或者Qwen3 27B这种虽然运行较慢但推理能力更强的稠密模型,若…
AI 芯片的功耗正以惊人的速度增长,从 H100 的 700W 到预计 2026 年 Rubin 架构可能达到的 2.3kW,数据中心的散热挑战日益严峻。但散热瓶颈的根源或非风扇或液冷本身,而是隐藏在…
进行模型对比测试时,一个常被忽视的现象是:许多人在给模型打分时,表面上扮演着"裁判"角色,内心却更像在寻求认同的"用户"。我们往往假定自己的判断是客观中立的,但人类评价(Human Evaluatio…
Tokenizer 看似只是将文本切割为若干片段,但在编写具体代码之前,必须先确定文本切分的精确粒度。神经网络的底层运算是线性代数,它无法直接理解人类语言中的“单词”概念,所能接收和处理的数据形式仅限…
用 Electron 打造实时翻译工具时,发现其在处理每秒数十字的音频流时,翻译延迟高达两秒,完全无法满足会议或视频内容的实时需求。直到 macOS 26 推出多套原生框架后,我才意识到 Apple …
在近期关于 《Rideshare Simulator》 的爆料中,一名参与开发的前主职指责游戏公司将他替换为 ChatGPT,并宣称所有乘客配音均由 AI 生成。尽管 Saber 的 CEO Matt…
在 ElevenLabs 这样的 AI 原生公司中,业务流程的效率瓶颈往往出现在后端,而不是前端的推理速度。当组织规模扩张时,如果计费流程仍需人工介入,就说明底层逻辑存在重复和冗余。核心问题在于将 A…
在企业环境中推广 Rust 语言时,最棘手的环节通常是新成员面对编译器报错时的困惑。对于习惯了 Go 或 Java 的程序员来说,Rust 的借用检查器表现得异常严格,即使处理基础的变量所有权移动或生…
用编码 Agent 协作时,最让人头疼的往往不是代码本身,而是信息传递。一个 Agent 发现某段逻辑需要和同事确认,不能自己完成一轮沟通:它先通知人,人再去找同事;同事把问题交给自己的 Agent,…
在日请求量达到百万级的场景中,直接使用千亿参数的大模型会面临两个核心问题:第一是每次 Token 的成本过高,第二是推理延迟无法满足高并发需求。尽管在基准测试中这些模型表现优异,但实际部署后的成本和性…
在 Hacker News 上曝光后,有人提起隐私担忧,让我花时间 inspecting Claude Code。出于 privacy reasons,我并不是为了评测功能而钻进去,而是想搞清楚:当一…
Gitar 通过自动化代码修复,将 Code Review 的流程从繁琐的挑错转变为直接提交补丁。这种转变得益于 AI 对代码上下文的深度理解,它不再仅仅指出问题,而是能生成具体的修复方案。 Gita…
企业数字化转型时,常见的误区之一是试图用固定的逻辑判断去穷尽所有业务场景,最终导致审批配置如天书般晦难,一旦需求微变便需全部推翻重来。但在流程中引入 LLM,其真正价值并不在于替代 if else 的…
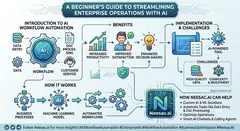
Substack 的官方“导入”功能在一时方便后,却转化为后续维护的“鸡肋”。一旦内容导入完成,原站更新就必须手动复制粘贴到 Substack 后台,尤其是那些跨平台同步需求强烈的用户,每日重复性操作…