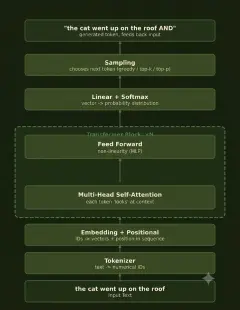
学习 Transformer 时,不少人会选择直接调用 HuggingFace 的 API,或者用 PyTorch 堆叠几层 。开发效率确实很高,但也很容易让人产生一种错觉:好像"我已经懂了"。可一旦…
AI 编程工具普及后,一种容易被忽略的错觉开始出现:代码只要顺利执行,开发者便把它当成了已经掌握知识。问题在 PR 评审和团队协作中尤其明显,有人用“AI 说这么写就行”结束讨论,效率看似提高了,决定…
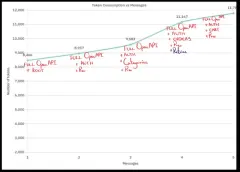
在构建 API Agent 时,一个常见的问题是 OpenAPI 规范文件体积过大,导致大模型上下文迅速膨胀,模型被大量无关信息干扰,产生幻觉并编造不存在的端点。 开发自动 API 测试原型时,我也遇…
利用大语言模型推导黎曼 zeta 函数零点分布下限这类复杂命题时,若只靠日常的自然语言问答,模型很容易落入语义模糊的泥潭,产出看似工整实则逻辑断裂的证明。想要在高级数学科研里规避这种幻觉,必须跳出单纯…
在 Midjourney v6 或 Stable Diffusion 3 这类生成模型中,过度使用情感强化词汇(如 "deep" , "epic" , "courage" )会导致输出跌入同一套“震撼…
使用 Reddit API 发布帖子后,即使 API 返回 URL 且页面能正常打开,也无法确认帖子已成功对外公开。登录发帖账号时,帖子可能仍然完整显示,但实际只有发帖人可见,其他用户无法查看。这种情…

在 X86 架构笔记本上通过 Ollama 部署 Llama 3.1 8B 和 Mistral NeMo 12B 两个 4 bit 量化模型时,实际测试发现推理速度并非唯一关键指标—— 内存分配和温度…
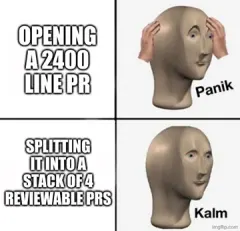
GitHub 静默上线了 Stacked PR 功能,目标直指那种改动几十个文件、Diff 长到让人直接点 Approve 的巨型合并请求。这种超长 PR 一直是代码评审的痛点,即便有 AI 辅助,漏…
利用 LLM 进行跨语言重构或迁移时,开发者习惯于以编译通过和基础测试全绿作为完工标志。然而,这种表象极具误导性。有案例显示,某个函数在 AI 移植后潜伏了 140 个 Bug,但配套的测试套件依然全…
Source Foundry 刚刚完成了一次 4 亿美金的融资,背后主导的是 Situational Awareness。这笔资金在当前收紧的硬件投资环境下无疑引人注目,但对于一个在开发者与硬件领域几…
当代许多“高级开发”流程中,遇到代码报错时,开发者常会将错误日志发送给 AI 模型,直接复制 AI 生成的修复代码并执行。这种模式在简单逻辑上可能高效,但在复杂项目中往往成为进度拖累的隐患。因为 AI…
有时我们写邮件或文档时,只输入“帮我写个项目进度更新”,结果 AI 输出的全是客套又空洞的废话,改起来比自己写还要费时,效率几乎为零。真正高效的操作路径应该是:提供具…
在部署 AI Agent 时,开发者常会误将 Benchmark 排行榜视为唯一选择依据。然而,实际应用场景中,模型的「跑分」与「效率」并不完全对应。以复杂代码重构任务为例,我将 Claude Opu…
代码库复盘揭示了三类无效检查,其共性是断言的预期值随被测逻辑同步变化,导致测试在逻辑错误时依然返回 PASS。 第一类是逻辑副本验证。在编写格里高利历闰年判断 的验证器时,若直接在内部复制一份与被测代…