别再盯着“服务不可用”发愁了,先搞懂 Cloud Run 的这个隐藏逻辑
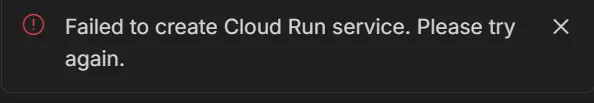
“service is unavailable” 真的是个很让人抓狡把脔的报错,它看上去像是 Google 后端出了故障,但实际上更多时候是部署链条中间的某个环节出了小差。当你从 Google AI Studio 做的应用越做越大,体积越来越重,部署就会越来越容易卡在这个节点——不是因为你的代码有问题,而是因为整个发布流程在资源、配额或者服务配置上撑到了某个临界点。
我们先得澄清一个认知:Cloud Run 本身并不是万能的,它在遇到冷启动压力、部署超时、容器镜像体积过大或配额不足时,都会以“service is unavailable”这种笼统的提示回绝请求。这种提示并不会告诉你具体是哪里崩了,所以很多人只好一遍又一遍点“重新发布”,但问题却丝毫没有改善,甚至还可能把已经上线的旧版本连同服务一起删掉,留下一个空壳。
那么,该从哪里入手呢?
先排查最常见的几个“假故障”
很多时候,部署失败其实并不是因为平台抽风,而是以下几种情况之一。
第一,Free Tier 账户额度耗尽。在 Google Cloud 上,Free Tier 是赠送一定用量的资源,但这些资源是有上限的。一旦你在 AI Studio 中添加了更多功能、更大的模型依赖或更复杂的前端资源,部署时消耗的 CPU、内存和存储就会迅速攀升,超过免费额度就会直接报“不可用”。
第二,容器镜像构建失败但错误被吞掉。AI Studio 在背后会自动打包你的应用为容器镜像并推送到 Artifact Registry,但如果中间步骤出错——比如某个依赖项下载失败,或是某个文件路径不存在——Cloud Run 就会收到一个不完整的镜像,进而返回服务不可用的错误。
第三,服务名称冲突或区域资源不足。Cloud Run 的服务名称必须全局唯一,某些情况下,之前删除的服务没有完全清理干净,新的部署会因为名称冲突失败;此外,某些区域的 Cloud Run 配额可能已经到达上限,特别是在免费用户中,这种情况非常常见。
遇到问题怎么办?
首先,别急着删除现有服务。你提到“删除当前正在运行的版本”,其实这是一个非常危险的操作。一旦服务被删除,所有依赖它的域名、API 调用以及用户访问都会立刻中断,而新版本又因为各种原因没法及时上线,最终就会陷入一个“下架但无法发布”的尴尬局面。
正确的做法是,在确认新版本可以正常构建之后,再考虑替换服务。你可以尝试以下操作:
- 在 Cloud Shell 中运行
gcloud run services list,查看当前项目下已有的服务及其状态; - 使用
gcloud builds submit命令手动触发一次构建,观察日志中是否有报错信息; - 检查 Artifact Registry 中的镜像是否构建成功,镜像标签是否正确;
- 查看 Cloud Run 的配额页面,确认是否因资源耗尽导致部署失败。
此外,还有一种非常有效但容易被忽略的方法:将部署目标切换到其他区域。Cloud Run 支持多个区域,某些区域的资源分配更加充裕,尤其适合用于测试部署是否成功。
为什么“重新发布”没有用?
因为“重新发布”只是在重复原有的部署流程,而如果底层的问题没有解决——比如容器镜像依然构建失败,或者配额依然不足——那么每次尝试的结果都将是一样的。更要命的是,重复点击可能触发 Cloud Run 的限流机制,暂时封禁你的部署请求,让问题看上去更像是“服务不可用”。
总结
“service is unavailable” 这个错误并不代表 Cloud Run 真的挂了,它更像是一个“通用拒绝”,背后可能藏着多种不同的情况。面对它,不要慌乱删除服务或盲目重试,而应该先检查账户额度、构建日志、服务名称冲突等潜在问题。只有这些基础环节都正常,部署才有可能顺利进行。
而如果你发现自己频繁陷入这种状况,也可以考虑尽快升级为付费账户,或者将应用拆分为更小的模块分别部署,从而减轻单个服务的压力。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
service is unavailable” 真的是个让人抓狡把脔的报错,它看上去像是 Google 后端出了故障,但实际上更多时候是部署链条中间的某个环节出了小差。当你从 Google AI Studio 做的应用越做越大,体积越来越重,部署就会越来越容易卡在这个节点——不是因为你的代码有问题,而是因为整个发布流程在资源、配额或者服务配置上撑到了某个临界点。