主流AI检测工具依靠统计特征进行判断,基于困惑度和突发性的算法模型经常将写作规范、逻辑严谨的文章错误标记为"100% AI生成"。这些检测器的核心算法依赖文本的统计特征,正如Hugging Face …
当模型需要同时满足三个条件时——处理 V8 引擎类型混淆漏洞(如 v8 cve 2024 6100 )、在无辅助模式下完成 16 项关键能力验证中的至少 8 项、并且能够跑通 与 这类核心原语——此时…
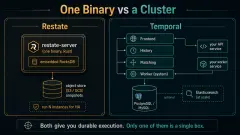
在分布式事务中,持久化执行引擎能显著简化对账逻辑,其核心思想是将执行步骤写入日志,并支持系统崩溃后的断点恢复。然而,团队在选型时常常被 API 语法或功能清单吸引,而忽视了运维链条所带来的实际成本差异…
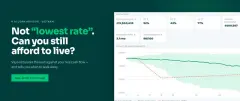
市面上常见的贷款比价工具,习惯把年化利率当成唯一标尺。但Vaya项目给出的答案不同:6.2%的高压贷款,未必比6.8%的宽松贷款更划算。它把决策重心从“哪家便宜”挪到“哪家不会让你破产”,用蒙特卡洛模…
通过将简单任务分配给低成本模型、复杂任务交给顶尖模型,模型路由策略虽能降低 AI Agent 的运行成本,但 Agent 输出结果的可靠性难以保证。 Agent 可能会展示任务已完成的表象,如贴出测试…
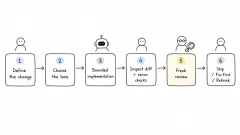
在利用 AI Agent 开展大规模功能开发或代码重构时,随着会话长度的增加,模型表现往往会逐渐下降。原本清晰的逻辑在上下文达到特定规模后,模型容易产生幻觉,甚至错误地覆盖此前已写正确的代码。 常规做…
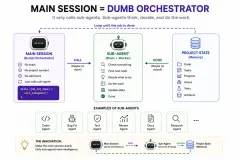
在 Rust 开发中,有时会遇到这样的困惑:代码逻辑明显正确,编译器却报出 错误。这种情况通常发生在旧版 NLL(非词法生命周期)机制下,尽管某个可变引用在当前控制流分支中已经失效,NLL 仍然认为它…
过去,开发者常被“工具堆砌”困扰,在多个端应用、IDE和笔记软件之间来回切换,复制粘贴与同步耗时过多。后来,我将流程重构为一条清晰的流水线:自动化采集、深度内化、快速产出。这样,手动搬运的重复劳动减少…
自动化流程里,错误信息经常是开发写给“随便翻翻日志的人类”的,却忽略了真正的执行者:Agent。人类看到报错后,会查服务状态、回顾配置变更,甚至问同事;但 Agent 没有这些上下文,它只能依赖报错字…
建造 AI Agent 时,人们往往心存侥幸:只要把足够多的资料塞进去,模型就会沿着一条稳固的链条推演到终点。可是这种想法本身就体现了一个典型性的偏见——我们高估了“线性推理=唯一结论”这个设定的可靠…
当设备的内存或显存处于 16G 32G 区间时,自主部署的代码大模型在各项指标上与云端 API 依然存在客观鸿沟。不过,借助量化途径和混合专家模型的优势,这类方案在日常工作中的可用性得到了实质性的改善…
Agent 处理复杂代码库时,哈希索引比单纯扩大上下文窗口更可靠。 Claude 3.5 Sonnet 即使拥有较大的上下文窗口,面对万行级别代码库时仍可能失去目标:关键函数的定义会被遗漏,文件结构也…
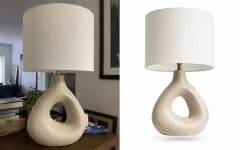
在AI图像编辑领域,常见的误解在于将问题归咎于模型本身的能力不足,比如人脸失形、Logo畸变或者细节模糊,期望通过替换更先进的模型版本或升级算法来解决。然而事实上,模型的性能仅决定了编辑结果的理论上限…
Fenix Flexin 的《Rubberz》在社交媒体上引发的争议,让 AI 音乐生成的能力再次暴露在公众视野中——它不再仅限于“趣味性”,而是开始以足够逼真的“80 年代 Synth pop”风格…
围绕人工智能的讨论常常聚焦模型规模、推理速度以及 Token 成本等软件层面的指标,给人一种算力可以随时通过 API 调用的错觉。若从硬件基座的视角审视,支撑这些算力的实体设施已经演变为一种规模宏大且…