传统 PR 评审中,开发者常因“审美审查”而陷入反复修改的泥潭。例如,一个变量命名不符合资深开发者习惯,可能被要求重写三四遍。这种围绕主观偏好拉锯的效率低下,本质上是一种内部资源浪费。 我们团队后统一…
我研究了一下 PawWise 项目的实现逻辑,发现它本质上是一套典型的多模态工作流。前端并没有进行复杂的图像处理,而是把照片直接交给 Gemini 3.5 Flash。真正的关键在于,要求模型强制输出…
模型评测得分偏低,不一定说明模型能力不足,也可能与评估端采用的 Prompt 和模型熟悉的表达方式存在偏差有关。模型掌握了相关知识,却可能因为指令没有正确触发,或者答案没有满足评测脚本的输出要求,最终…
Opus 5 现在的状态,活像一个停不下嘴的长辈:只让它改一行代码,它都能顺便讲完这行代码的“家族史”。更离谱的是,不少人的 里明明写了 "Be concise",4.x 版本还能管用,进了 5 代却…
GLM 5.3 宣传的 Cyber capabilities 引发了不少讨论。很多人的第一反应是,它能不能帮忙写扫描器或攻击脚本。作为一名每天在 IDE 里处理 Bug 的开发者,我把它接入工作流,连…
越来越多的“AI 高效工作流”模式,将全部重点放在“自动化上”,试图通过复杂的提示工程让AI从策划到执行一气呵成。然而,当这些“高效”结果面世时,往往带着一种难以名状的“机器化”味道——逻辑结构清晰,…
很多人在Notebook里训练出个不错的准确率就高兴了,但那只是个文件,前端没法用,业务analyst看不懂,更别说直接集成到产品里了。所以我从电信用户流失预测模型入手,把整个预测流程从实验环境迁到生…
这种现象在心理学文献中被标记为“状态维持偏差(Status Quo Bias)”。代码尚未落地时,方案 A 与方案 B 仅停留在逻辑推演层面,此时的决策几乎零成本。一旦项目完成正式部署,局面即刻反转。…
在研究 LLM 鲁棒性的过程中,我注意到了一个很有意思、又带着“黑客色彩”的现象:有人开始在正式的法律提交文件中植入 Prompt Injection,也就是提示词注入,试图通过操控审阅文档的 AI,…
在打造 OmniIncome v1 的企业级 AI 聊天机器人展示页时,我意识到过度强调前端框架反而会让最简单的部署方式被忽视——直接输出一个单文件 HTML。这种方式无需复杂工具链,直接满足快速展示…
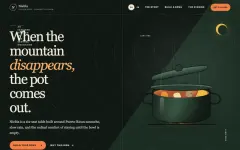
一个纯 HTML 与 CSS 构建的页面,精细度能到什么地步?Niebla 给出了答案:全站只有一张 favicon,连 标签、内联 SVG、CSS 全部没有。锅体、汤底、升腾水汽、窗外雨滴,每一帧都…
在 Mac 上高强度使用 AI 时,拖慢效率的往往不是回答能力,而是频繁切换任务后出现的上下文“断档”。用户可能正在 VS Code 里处理 Python 逻辑,中途转到 Chrome 查看 API …
在构建多模型协同的 Agent 系统时,常见的架构模式是将复杂任务交由大规模模型(如 Qwen2.5 Coder 7B)处理,再将结果下发给轻量模型(如 Qwen2.5 Coder 1.5B)执行具体…
AI 驱动的自动化代码评审常被视为提升开发效率的利器,但实际应用中却暴露出一个关键问题:团队往往将 AI 的「LGTM」标记视为合并的充分条件,从而忽略了对核心业务逻辑的深度验证。这种依赖并非源于 A…
当AI在日记对话中变成“情绪树洞”时,问题并非在于它无法理解你,而是它被设计成了“舒适性优先”的模型——这种行为来自RLHF(基于人类反馈的强化学习)对齐阶段学习到的“让用户感到安心”的默认策略。这意…