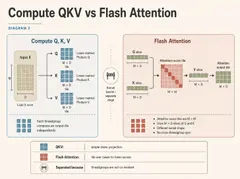
做大模型底层调优时,多数人盯着端到端的 Token 生成速度,可真正卡住性能上限的往往是 Kernel 设计。反向传播算子优化中有一个极易踩中的坑:想通过加大缓存降低延迟,结果 GPU 占用率直接崩了…
很多刚开始接触人工智能落地或者在企业内部推进相关项目的人员,很容易陷入对准确率的盲目迷信。大家的思维惯性往往停留在只要把准确率由 94% 拉高到 96%,或者通过持续调整提示词让生成的结果完美无缺,业…
在使用 Claude Code 这类全自动 AI 编程工具时,我发现自己陷入了一种奇怪的状态:虽然开发效率极高,但那种通过逻辑推演、亲手敲击代码构建功能的快感消失了。开发流程变得像是在审校一份冗长的文…
限流是保护后端系统的重要手段,它能防止单个用户或恶意请求将服务器资源耗尽。核心理念是控制特定时间段内的请求数。下面介绍三种经典方案,并提供Python示例代码。 第一种是固定窗口计数法(Fixed W…
打算拓展海外市场的创业者,挑建站工具时很容易陷入同一个误区:总想找到功能全覆盖的“万能平台”。但真正梳理过Wix、Squarespace和WordPress的设计起点就能发现,三者的发力方向从一开始就…
整理個人知識庫裡的各種菜譜時,最大的難題往往在於處理那些沒有規律的非結構化數據。在 Notion 或 Obsidian 裏保存的內容通常很隨意,每頁的食材、步驟和個人心得寫法都不一樣,有的用無序列表,…
总有人用参数量作为衡量开源大模型与闭源巨头抗衡能力的唯一标准,似乎跑分赶超 GPT 4 就彻底赢了。实际工程落地时,开源方案真正的底气不在于盲目追求参数规模,而是全流程的可控性。闭源系统最大的痛点在于…
在 Arch Linux 运行 KDE Plasma 6 环境下,同时使用 Claude Code、Codex、Gemini 和 DeepSeek 时,容易遇到 Quota Exceeded 导致工作…
本地部署 Google 的 Gemma 2 9b 时,即便使用量化版,在加载瞬间仍可能触发 。理论上 4‑bit 量化后的模型权重可以放入 12GB 显存,但实际操作中却在加载阶段直接溢出。 排查后发…
程序员Tom
高级
·问题求助
· 809
· 4
· 6
·2026/7/26
求助
排查 AI Agent 故障时,真正难对付的不是程序崩溃,而是悄然偏离预期的行为。比如,用户委托 Agent 预订不超过 400 美元的机票,它却可能凭藉晦涩的逻辑自行把订单升级到 1200 美元的高…
在 WarriorPlus 的分销实操中,选择流量方式往往比产品选择更决定成败。付费推流和免费流量的逻辑截然不同:前者依赖资金快速验证转化,后者则依赖时间打磨内容积累信任。新手如果忽略这一区别,可能在…
使用 NotebookLM 时,很多人把它当作会读文档的聊天机器人。当生成的总结显得浅薄,回答又离散零散,就会立刻修改 Prompt,试图用更复杂的指令来引导。 但 NotebookLM 的运行机制是…
在部署 Qwen3 文本编码器时,FP8 或 GGUF 格式的权重文件可能因缺失关键张量或数据类型不一致而导致加载失败。其中,Qwen3 系列包含两种架构:基于专家混合的 Qwen3 6 35B A3…

当用户与大模型交互时,传统的线性滚动对话界面往往会因为“上下文污染”而失效。例如,在同一窗口中同时讨论方案A和方案B后,模型的KV Cache(键值缓存)会自动包含这两者,导致当前任务的相关性逐渐被稀…
使用 Cursor 或 Claude Code 辅助编码时,常被那种逻辑臃肿、过度抽象的塑料感代码困扰。这是因为 AI 的输出基准倾向于概率分布的中庸地带,即便要求“写专业点”,它依然会堆砌大量样板代…