在处理复杂数据层级时,隐藏子记录常成为潜伏的性能杀手。我在 GSoC 第九周的代码实现中遇到了这个问题:递归处理标记为“隐藏”的子项时,若方式不当,数据库查询会退化为经典的 N+1 问题,导致接口响应…
在流式语音 AI 场景中,如果使用 OpenTelemetry 的自动注入机制,追踪的 Span 会在生成器创建时立即终止,导致无法捕获完整的音频流处理过程。这意味着传统追踪无法准确反映真实的 首音频…
面对AI市场上各家厂商给出的海量免费调用额度,与其纠结于每个月 20 美元的套餐订阅费,不如把手头已有的免费服务通过工作流串起来。与其盲目追求一个全能型的大模型,不如依照具体的工作环节把不同的特色模型…
多 Agent 协作最麻烦的地方,通常不是流程逻辑本身,而是性能出现异常后很难定位。单独调用一次 LLM 并不复杂,可进入 Swarm 模式后,多个 Agent 会并行执行,其中一个请求超时后悄悄 f…
在华为云 ModelArts 平台上执行机器学习工作流时,Notebook 实例能够持续保持已安装的库,而 Training Job 在每一次启动时都会基于系统提供的镜像重新创建环境。由于缺少对依赖的…
创业者阿杰
中级
·问题求助
· 245
· 4
· 8
·2026/7/27
求助
自由职业者常将 ChatGPT 用作搜索引擎或文案润色工具,忽略其在行政运营环节的潜力。实际工作中,沟通协调、需求拆解、报价谈判等碎片化任务常占据大量精力,若处理不当不仅影响效率,还可能损害专业形象。…
在开发或研究大型语言模型时,开发者常倾向于将 Claude Code 或 ChatGPT 视为拥有独立思考能力的智能体。若要充分发挥这些模型的性能潜力,关键在于打破这种固有认知,深入探究其底层工作机制…
很多开发者在利用 AI 修复局部 Bug 时,经常遇到 AI 擅自修改设计模式或将业务逻辑写入 Controller 的情况。这种局部修复导致全局失控的现象,是因为 AI 助手在执行任务时缺乏架构导向…
当日常工作或内容构思时借助大模型审查方案,往往只能得到充满赞美的反馈,罗列出三条优点却忽略了核心漏洞。这种现象源于顺从偏差,即大模型的内部权重倾向于维持和谐,输出的更像一面美化自身的镜子而非客观真相。…
抛弃笔记本电脑,仅利用手机与 AI 助手也能独立完成一个小项目的从零构建。这种模式将编程重心从单纯的编写代码转移到了需求定义与逻辑审核上。 虽然手机屏幕尺寸限制了 IDE 插件重构和快捷键跳转的使用,…
当团队把开源的 GitHub 监控工具接入大模型链路时,经常会遇到界面毫无显示却返回 的现象。这个归类于 Self Hosted 或云端托管的工具本身作为开源的 OpenTelemetry nativ…
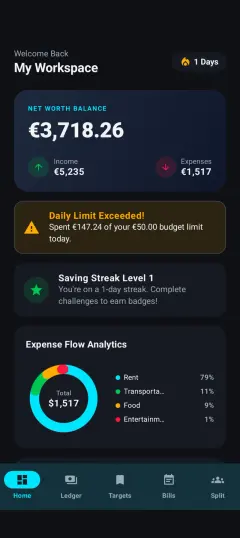
Java 与 Kotlin 混合开发 BudgetBuddy 之后,项目落地了收支追踪、预算预警和账单分摊三条完整链路。这套方案只适合数据完全本地化的场景,一旦引入服务端同步,事务边界和类型安全就得重…
4GB 内存的 VPS 跑 Next.js 常常被 OOM 打断,问题多半出在构建阶段:像 Coolify、Dokku 这类一键部署工具,构建进程一启动,内存峰值立刻顶上来,生产容器还在运行,两者同时…
Google 的 Co Scientist 让我们更直观地看到一个问题:单一超大参数量的 LLM 承担科研全流程的能力并不现实,尤其是在需要高度确定性的文献综述、假设提出和实验设计等环节。这种“逻辑坍…
Alex18
专家
·问题求助
· 715
· 3
· 12
·2026/7/27
求助