把 ChatGPT 当长期项目用的时候,对话历史根本不够用
为什么长期工作不适合存在聊天记录里
做长线项目的人应该都有这种体会:手里那个活了几个月的需求,聊天记录早就滚到几千条。你想找三个月前定下的某个参数,或者确认一下上次废弃的方案是什么,唯一的办法就是往上翻。这种体验非常糟糕,因为它违背了一个基本逻辑:我们的工作并不是由一个个孤立的对话组成的,而是由一个不断演进的“当前状态”构成的。
在 ChatGPT 里,对话只是载体。真正需要持久保存的,不是我们说了什么,而是事情现在的样子。比如,现在的核心假设是什么?哪些部分已经验证过不需要再改了?哪些地方还悬着没定论?支撑这些结论的参考资料在哪?这些内容如果散落在几百条消息里,每次开启新对话,模型都要重新从海量噪声里提取有效信息,既慢又不准。
我之前以为这只是个整理问题,加个类似“项目文件夹”的功能,再配个简单的视觉地图就行。但深入琢磨后发现,组织结构和上下文管理其实是同一个问题的两面。如果只解决分类,不解决上下文的自动筛选,用户还是得手动把旧对话的摘要喂给新对话。真正的解法应该是建立一个悬浮在对话之上的“持久层”。这个层级负责维护工作的当前状态,而对话退居幕后,成为状态变更的历史日志。
理想中的持久化结构是什么样
我们可以把这个架构拆解成四个层次,从底向上分别是:项目或领域、持久化的工作流、当前状态、以及对话和来源。
在这个模型里,ChatGPT 会自动维护大部分结构。当你针对某个子任务发起对话时,系统不应该把整个项目的记忆全部塞进上下文窗口,也不应该全靠向量检索去猜你刚才在想什么。它应该根据当前的任务,精准地拉取相关的状态片段。与此同时,你需要有一个可视化的接口来检查这个结构。哪怕只是一个小型的思维地图或者大纲视图,只要能让你看到模型是怎么理解当前状态的,你就有了控制权。如果模型的归类错了,你可以手动隔离、移动或者删除某些节点。
这种设计的核心目标不是追求无限的记忆力,也不是让你去手动维护一个复杂的知识图谱。它的目的是用最少的必要上下文,实现可靠的连续性,并且让用户清楚地知道模型“脑子里”现在装着什么。这种透明度比单纯的记忆容量更重要,因为一旦模型产生了幻觉,你能立刻通过查看结构发现哪个分支出了问题。
这种思路在开源社区已经有人跑了
如果你去翻翻 GitHub 上的 Discourse 仓库,会发现类似的逻辑已经在社区平台里跑通了。Discourse 不仅仅是一个论坛,它是一个经过十多年实战检验的开源社区平台。官方甚至提供托管服务,让你跳过服务器维护和配置的繁琐过程。在 Discourse 里,讨论话题、实时聊天、主题定制以及插件扩展(包括基于 Discourse AI 的聊天机器人)都是围绕着一个核心的数据结构进行的。这种结构保证了无论社区聊了多少年,关键信息都不会丢失,且能被高效检索。这其实就是“持久化状态”的一个缩影:将结构化的数据与流式的交互分离开来。
再看看更前沿的尝试,比如 Ai_home 这个认知架构原型。这个项目试图在传统的上下文窗口 LLM 之上,构建具有持久身份、长期记忆、情绪识别甚至自我修改代码能力的代理。虽然这听起来有点玄乎,但它揭示了一个趋势:未来的 AI 助手不应该是一张白纸,它应该像一个有经验的同事,带着过往的项目经验参与工作。Ai_home 的作者也指出,建立这种身份是复杂且漫长的,需要数千条独立的记忆才能浮现出实质性的东西。这也解释了为什么简单的对话历史无法承载长期工作——因为缺乏对记忆的结构化和累积机制。
商业落地中的性能启示
这种对效率和连续性的追求,在底层基础设施上也有体现。比如最近的推理提供商 Wafer,他们在延迟控制上做得非常出色。据 Neon Health 的联合创始人兼 CTO Harry Bleyan 介绍,Wafer 提供的延迟是他们试过的所有供应商中最低的,而且在每分钟请求量激增时也没有出现性能断崖式下跌。这带来的直接好处是,他们可以直接移除整个预取层(prefetching layer)。这一简化不仅降低了复杂性,还将推理成本降低了 50%。此外,Wafer 还帮助 DigitalOcean 将 Kimi 2.5 在 AMD 硬件上的速度提升了 11.33 倍,且没有任何准确性损失。
这些数字告诉我们,无论是聊天助手的上下文管理,还是底层模型的推理优化,核心都在“精准”二字。对于长期工作来说,精准意味着只加载必要的状态,而不是把几 GB 的聊天记录全塞进去。Wafer 通过去除预取层证明了,消除冗余处理能带来巨大的性能红利。同理,如果在 ChatGPT 的项目管理中,能自动过滤掉无关的历史对话,只保留当前任务的“当前状态”,那么不仅响应速度会变快,模型的注意力也会更集中,减少幻觉的发生。
我们该如何期待未来的功能更新
目前 ChatGPT 的“项目”功能还处于比较初级的阶段,本质上还是对聊天记录的简单归档。如果 OpenAI 真的想解决长期工作的痛点,接下来的迭代方向应该很明确。
- 自动状态提取:系统应该在对话过程中自动识别关键决策、待办事项和参考资料,并将其结构化存储,而不是等用户手动总结。
- 可视化状态图:提供一个轻量级的视图,展示当前项目的各个模块及其依赖关系。用户可以一目了然地看到哪些部分已经完成,哪些还在进行中。
- 上下文智能裁剪:在新对话开始时,系统应自动根据当前任务的相关性,从持久层中提取最匹配的片段,而不是进行全量检索。
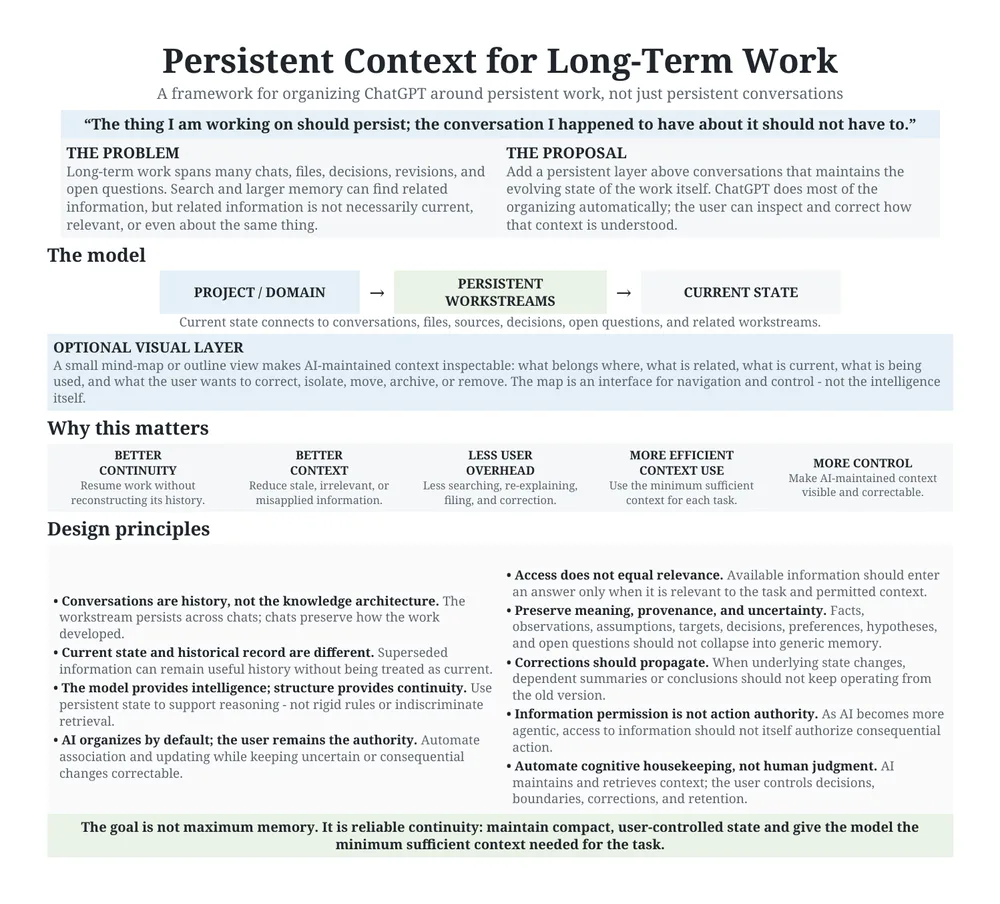
这并不是什么全新的概念,许多论坛和社区都在呼吁嵌套项目、持久化状态、改进的历史检索以及更好的连续性支持。但关键在于把这些碎片拼在一起,形成一个以“持久层”为核心的完整体验。
个人怎么看
我觉得这个问题之所以重要,是因为我们使用 AI 的方式正在从“问答”转向“协作”。在问答模式下,每次对话都是独立的,上下文不重要。但在协作模式下,AI 是你的长期搭档。你希望它记得上次讨论的结果,知道哪些方案已经被否决,了解项目的整体脉络。如果只是让它在一个无限长的聊天记录里大海捞针,那它永远只是一个聪明的搜索引擎,而不是一个真正的合作伙伴。
目前的解决方案大多是依靠用户的提示词技巧,比如让模型在每次对话结束时输出一个总结,然后在下一次对话开始时把这个总结作为输入。这种方法虽然有效,但极其脆弱且容易出错。一旦中间某次总结遗漏了关键信息,后续的所有工作都可能建立在错误的假设上。
所以,一个内建的、自动化的持久化上下文机制,是 AI 工具走向成熟的必经之路。它不需要多么花哨,只需要做到两点:一是准确地维护工作的当前状态,二是让用户对这个过程有清晰的控制和感知。当我们不再需要担心“AI 忘了我说过什么”,也不再需要手动整理聊天记录时,我们才算真正进入了高效 AI 辅助工作的时代。
你提到的“几千条”聊天记录,我记得我用 ChatGPT 做毕设时,对话历史直接把浏览器卡死,连滚动都卡顿。现在才知道,这根本不是技术问题,是设计缺陷。