Google DeepMind 用 Gemini 4 Argon 把输出上限拉到百万 token
Google DeepMind 憋了半年多没动静,直到上个月管理层刚洗牌完,这次直接把 Gemini 4 Argon 推了出来。这玩意儿不只是简单的模型升级,它是 GDM 对着 GPT-6 Astra 和 Claude Opus 5.5 这种一线竞品甩出的回应牌。核心卖点很直接:在 13 个主要基准测试里拿了第一,而且首次把单次输出上限拉到了 100 万 token。虽然目前还在有限预览阶段,但如果你现在就在搞代码重构或者长文档处理,Argon 的性价比和长文本能力值得仔细盘一盘。
到底强在哪:基准测试与价格账
Argon 的身位抢得比较硬。在 Google 公布的 19 个可信基准中,它在 13 个项目上达到了 SOTA(State of the Art)水平。拿大家最关心的 DeepSWE(软件工程评估)来说,Argon 得分 77.9%,比 Opus 5.5 的 74.2% 高了接近 4 个百分点,也比 Astra 的 74.1% 领先。这说明它在复杂代码理解和修复上的逻辑链条更稳。
价格方面有两个档位需要看清楚。标准定价是输入 $4/百万 token,输出 $20/百万 token。但现在有个 50% 的入门折扣,也就是输入 $2,输出 $10。更狠的是缓存输入的折扣高达 95%,这对那些重复读取同一份知识库的企业工作流简直是降维打击。
不过要注意,便宜不代表省 token。Artificial Analysis 的数据显示,Argon 完成任务平均消耗 62K 输出 token,而 Astra 只要 27K。Argon 是靠单价低来赢下最终成本(折扣价下单次任务约 $1.99,Astra 是 $3.26),而不是靠推理效率。这意味着如果你用的是按量计费且没有缓存优化的环境,盲目切换可能会导致总消耗量翻倍,只是单价减半。你需要核算的是:你的任务是否适合这种“暴力输出”式的解题风格?
百万 token 输出的实现机制
1M token 的输出听起来很性感,但背后有个技术细节容易被忽略。Google 官方宣传的是 1M token 上限,但 Vals 列表显示最大输出其实是 262K。这中间的差距是因为引入了一个叫 Long Decode Continuation 的新 API 特性。
这个功能允许你在长响应过程中暂停,然后在后续调用中继续解码。Artificial Analysis 正是通过这种方式才跑出了 1M token 的结果。这对开发者意味着什么?意味着你不能指望一次 generate 调用吐出整整 100 万字,而是需要处理状态保持和上下文衔接。如果你的应用架构不支持流式中断和续传,实际能用的有效长度可能会被压缩在 64K 到 262K 之间。
内部实战:代码重构与内存优化
别看参数漂亮,Google 拿自家业务做了压力测试,数据挺能说明问题。
Argon Agent 在数据中心做了一次大规模清理,释放了超过 300 TiB 的内存。更硬核的是代码迁移工作:它正在将超过 80 万行的 C/C++ 内核代码转为 Rust。这不是简单的语法转换,而是涉及底层逻辑的重构。在一个视频解码器项目中,Argon 替换了 32K 行 SIMD 代码,用更安全的 Rust 实现,结果性能提升了 2.7 倍,且输出结果完全一致。
这透露出一个信号:Argon 在处理底层系统代码时,不仅准确率够,还能考虑到指令集层面的优化。如果你手头有老旧的 C++ 库要维护,Argon 可能是个不错的起点,但务必做好人工 Review,毕竟它生成的 Rust 代码追求的是“安全”和“快”,不一定符合你们团队的编码规范。
幻觉与精度的权衡
高产出和高速度往往伴随代价。Argon 在 Artificial Analysis 的 Omniscience 测试中,幻觉率为 15%,远低于 Astra 的 51%。但这带来了精度的轻微下降:Argon 的准确率为 50%,低于 Astra 的 63%。
这就形成了一个明显的 trade-off:
- Astra:回答更少,更精准,幻觉少,但贵。
- Argon:回答更多,覆盖面广,幻觉控制极好,但偶尔会“过度发挥”导致精度稍弱。
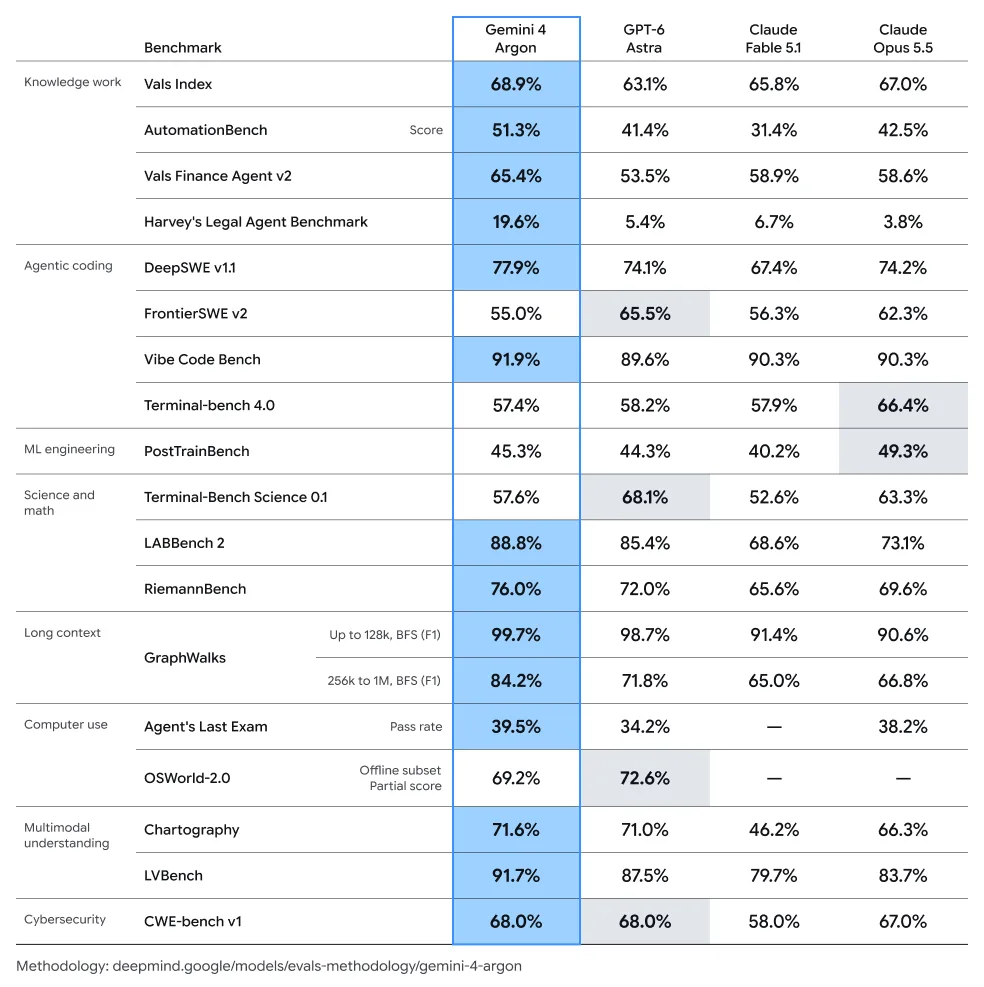
在 Vals Index 的综合评分里,Argon 以 68.9% 拿下第一,平均单次任务成本 $15.68。在自动化基准 AutomationBench-AA 上,它得了 77.5%,排名第一。但在终端操作 Terminal Bench 4 上,它得了 57%,排在 Sonnet 5.5、Opus 5.5 和 Astra 之后。这说明 Argon 在“规划与生成”上极强,但在“即时交互与短指令执行”上并非绝对统治。
怎么用才划算:场景建议
基于目前的折扣期和特性,我把使用场景分成了三类:
- 长文档/知识库一次性处理
利用 95% 的缓存输入折扣。先把几百页的技术文档喂进去构建 Context,然后让 Argon 用 Long Decode Continuation 生成完整的分析报告。因为输入几乎免费,输出又便宜,这是最赚的场景。
- 代码全量重构与迁移
参考 Google 内部的 Rust 迁移案例。让 Argon 输出完整的文件级代码,利用其高 token 吞吐能力一次生成整个模块,而不是分段生成。事后用单元测试验证一致性。
- 避免使用的场景
如果是简单的问答或短代码片段生成,Argon 的 62K 平均 token 消耗会让你付出不必要的计算资源浪费。这时候用轻量级的 Flash 版本或者更便宜的模型更合适。
潜在坑点与下一步
目前 Argon 还在 Fairwind 计划中,优先面向政府用户和受信任的网络防御者。普通开发者和企业用户需要等待 Google 完善护栏(guardrails)后才能开放访问。
这里有一个容易被忽视的风险点:Long Decode Continuation 是 API 层面的新功能。如果你现在的后端逻辑是同步阻塞等待完整 JSON 返回,接入 Argon 时需要重构为异步流式处理,并增加“断点续传”的状态管理逻辑。否则,一旦网络抖动或超时,你可能丢失中间生成的几十万个 token,而重新生成的成本虽然低,但时间成本很高。
另外,注意那个 CK 猜想(Cauchy-Kovalevskaya 猜想)的内部研究成果。虽然这是个数学里程碑,但它暗示了 Argon 在纯逻辑推导和抽象证明上的能力已经超越了简单的模式匹配。如果你在做科研辅助或数学建模,Argon 的表现可能会超出预期。
总结来说,Gemini 4 Argon 不是那种“全能且完美”的模型,它是一个“大力出奇迹”的选手。用更低的单价换取更多的输出,用极高的幻觉控制率换取稍低的绝对精度。在 50% 折扣期内,它是目前性价比最高的头部模型之一,但前提是你的应用架构能吃得消百万 token 级别的流式输出。
100万 token 输出上限,我都想试试长文本生成了,不过价格有点小贵。