大模型说“80%把握”并不是真的在算概率 把大语言模型的输出当真,当成概率来用的人不少,但这种想法本身就偏离了本质:LLM 并没有执行贝叶斯公式,也不懂得先验概率怎样被证据更新,它只是在模仿人类语言中…
不少开发者使用 Cursor 或 Claude 快速搭建项目时,往往会走上几乎相同的路:前三个功能实现得特别快,运行起来丝滑无比,甚至让人产生一种“我已经是架构师”的错觉。可当项目开始增加第五个或第六…
在Reddit平台上,OpenAI相关讨论区频繁出现Ed Zitron的评论。尽管部分人将他视为AI领域的悲观论调代表,但剥离其尖锐表达后,他实际上以严苛的商业分析揭示了当前大模型投入产出比的矛盾本质…
处理千万级数据湖时,一套历经半月优化的模糊匹配逻辑上线后,在面对真实业务噪声时并未实现“安全”对齐。标准化与模糊匹配虽常被视作解决实体对齐的核心手段,但实践中更隐蔽且致命的其实是“实体键漂移”。 其运…
团队在应用 AI 工作流时,经常在群里分享 Claude Code 的截图。大家习惯于吐槽它会直言某个步骤未验证,或者坦承是凭记忆编写。在这种认知中,很多开发者觉得 AI 应当表现得更自信才算专业。 …
在低代码领域的观察中,ToolJet 的战略调整显得尤为有意义。很多企业在 AI 浪潮里倾向于“自研全家桶”,试图打造闭环的 AI 自动化体系,而 ToolJet 在经历了一段阵痛之后,选择了一条截然…
很多人在尝试 Claude Code 或各类开源 AI Agent 框架时,都会犯一个共同的错误:认为只要模型足够强大,循环迭代足够频繁,代码就能自动生成,项目也能自动上线。这种“模型崇拜”背后,是对…
一套让客户迅速明确“你是干嘛的、服务谁、能否交付”的作品集,其耗时程度甚至超过写代码。我曾思考,若将这…
当前流行的 AI 辅助编程平台,比如 Cursor 和 Claude Code ,通常依赖人工复查生成的源码片段。然而,这种流程在实际使用中面临两个关键限制:一是开发者在多任务环境下难以保持持续专注,…
收到来自 的邮件时,我原本在 macOS 环境下快速部署了一个本地 Kubernetes 集群,用 minikube 便捷验证了 SIGs 对新手的友好设计——这让我对社区的开放性更有信心。被拉入 组…
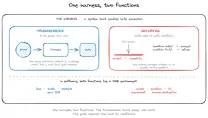
生成式AI只擅长应答,代理式AI能真正干活 提起AI,人们脑子里第一个画面还是那个熟悉的对话界面。输入问题,获得答案,这就是典型的生成式AI表现。它的工作方式简单直接,接收指令后调用底层模型预测下一个…
远程开发时,即使家用宽带显示“千兆级别”,代码输入仍可能卡顿,原因在于网络链路的实时性而非带宽本身。例如,下载一个 500MB 的 Docker 镜像可能速度正常,但输入延迟或数据包丢失会严重影响操作…
当基于 Flow Matching 的时空 UNet 架构参数量控制在 20.8M 时,若在 64x64 分辨率与 16 帧长度的设定下画质停滞,单纯延长训练周期往往无效。若 Loss 曲线在 0.0…
信贷催收团队长期依赖的“30天打三轮电话、60天换脚本”模式,在经济稳定时期能够勉强维持运转,但一旦市场波动或监管收紧,这种基于固定逾期天数(DPD)的硬性框架就显得僵化无效。比如,当客户在30 DP…
把公司的 API 文档或数据库直接喂给大模型,往往会得到一本正经的错误答案。很多人第一反应是想微调模型,但对大多数开发者而言,微调成本高、周期长,数据更新后还需重新来过,性价比不高。 真正能让 AI …
