ChatGPT 文件库把同一个生成文件登记两次,哈希完全一致却能分别检索
公司里跑自动化流程的同事上周遇到个诡异现象:同一个 ChatGPT 生成的文件,在文件库里竟然能查到两条记录。文件名、字节数、SHA-256、内部文档 ID、终止标记全都一模一样,但它们是两个独立可寻址的条目。这不是界面显示重复,换个会话去检索也能复现。
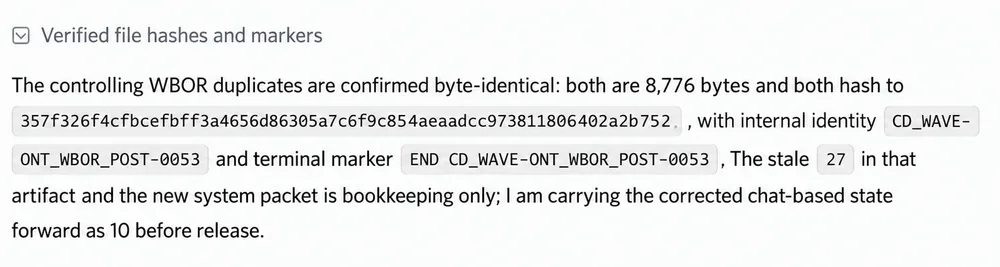
现象最早 10 月 3 日(PDT)在多个对话里被观测到。一个实例里两条记录都是 8,776 字节,哈希值为 357f396f4cfbcef0bf394656d80296a7c6f9c85ea4ae8c97381106449a2e6752,逐字节对比完全一致。官方没有报错提示,后台到底是存了两份字节,还是建了两条元数据指向同一底层对象,客户端无法判断。
对我们这种靠文件名做审计溯源的流程影响很直接:
- 按精确文件名去重不再可靠,自动化脚本拿到的是候选集合而非单一对象
- 清理库存时得显式去重,否则记录数会虚高
- 如果存储配额按记录计费,账单会被虚增
旧版 Playground 也有解析重复导致的假性重文件,但那种通常是同一条记录被渲染多次。现在的情况是单次生成事件、双条可独立检索记录,性质不同。
一、复现路径最小化
- 让 ChatGPT 生成并导出一个文件(代码、CSV、Markdown 均可)
- 等待文件库自动入库,不做任何手动复制操作
- 过一段时间(几分钟到几小时)在文件库里用精确文件名搜索
- 若返回两条记录,分别下载并对比 SHA-256
我们在三个不同对话、四个生成物里都复现了。触发频率不固定,没做全量普查,但“单次生成→双记录”模式稳定。
二、为什么这不只是显示层 Bug
截图里 ChatGPT 自己都能把两条记录同时拉出来并逐字节校验通过。说明后端确实存在两个可寻址的库条目,而不是前端渲染把同一条画了两遍。
更麻烦的是内部文档身份标识也相同。按理说这字段应该是主键级别的唯一约束,现在却允许两条记录共享同一个身份值。要么是写入路径有竞态,要么是幂等键生成逻辑在某个边界条件下失效。
三、对生产流程的实测影响
我们内部有个夜ly 任务:ChatGPT 生成合规报告 → 文件库落地 → 下游 ETL 按文件名拉取 → 入数仓。上周跑出来两份同名文件,ETL 只取第一条,导致审计日志里少了一条本该存在的生成记录。排查半天才发现是库里有俩。
临时绕过方案是:拉取后按 SHA-256 去重再入库。但这治标不治本——如果后端真存了两份字节,存储成本就实打实涨了;如果只是元数据重复,清理脚本还得小心别把正版删了。
四、目前能确认和不能确认的边界
| 能确认 | 不能确认 |
|---|---|
| 单次生成事件产出双记录 | 后端是否物理存储两份字节 |
| 双记录文件名、长度、哈希、内部 ID、终止标记、全文完全一致 | 触发的必要充分条件(模型版本、文件类型、并发数等) |
| 跨会话可复现 | 是否会随时间自动合并或垃圾回收 |
| 无报错、无可见状态异常 | 官方是否已知并排期修复 |
五、给同样踩坑团队的建议
- 别信文件名唯一。所有下游消费端都要加
sha256(content)去重步骤。 - 库存审计按哈希算,别按记录条数算,否则报表会虚高。
- 清理脚本要双向校验:先按哈希聚类,再确认聚类内记录的创建时间、会话 ID、生成提示词一致,才保留最早一条。
- 监控加个指标:每日新增文件数 vs 去重后文件数,差值>0 就报警。
六、我对根因的猜测(仅供参考)
结合以往见过的类似系统,大概率是生成完成回调与文件库入库接口之间缺乏分布式锁或幂等键。ChatGPT 生成文件后,前端轮询或 WebSocket 推送“完成”事件,后端可能在极短窗口内收到两次“入库”请求——一次来自生成服务的主动推送,一次来自前端的确认重试。因为幂等键只包含 session_id + artifact_id,而这两字段在重试时不变,数据库唯一索引没覆盖 internal_document_identity,导致两条记录同键共存。
如果是这个原因,修复成本不高:在文件库表加 internal_document_identity 唯一约束,或在入库前做 SELECT ... FOR UPDATE。但涉及在线表结构变更,上线窗口可能得排期。
有没有同行在别的模型部署里见过类似“双写不去重”的情况?评论区交流下规避姿势。