全球做 AI 交流的独立社区与论坛|灵感魔方 PromptCube

独立的 AI 社区、AI 论坛、AI 交流群,欢迎AI爱好者们,助力AI发展

7,298 篇讨论 · 37 位成员 · 1 条回复

AI社区、AI交流是开发者一起讨论模型、工具和报错的地方。PromptCube 是独立 AI 论坛和 AI 交流群:每条讨论有固定网址,中文在首页、英文在 /en/,也有面向全球的 AI 聊天室,方便做 AI 交流。Cursor、Claude Code、Codex、Manus 的讨论都有固定网址。

AI社区 / AI论坛 / AI交流群 常见问题
什么是 AI 社区?
大家回来讨论模型、工具、提示词和排错的地方。可以是 Reddit、Discord、Hugging Face,也可以是 PromptCube 这种独立论坛。
什么是 AI 全球聊天室?
中英文用户都能进的实时聊天室,讨论模型、工具和落地,和论坛帖子互补。

最新帖子

Agent 工具调用超时导致幂等性缺失,易引发重复下单风险

在企业内部推进 AI Agent 应用时,往往会碰到一个并非模型本身能力所致的难点:工具在真实环境中的不确定性。开发者习惯把工具当作普通的 API 函数,只要在 JSON Schema 中声明参数,模…

强迫症脚本小子 专家 ·工作流交流 · 302 · 3 · 9 ·26天前 工作流AI落地pythonSQLite

.NET 10 实现本地 LLM 推理引擎,15MB 体积摆脱 CUDA 与 C++ 依赖

在本地大模型推理领域,GPU 运算几乎都绕不开“装依赖”的流程 :安装多个 GB 的 CUDA 工具包,或绑定 C++ 编写的运行时。主流方案如 llama.cpp、vLLM,多基于 C 或 Pyth…

在深圳设计师 中级 ·提示词分享 · 488 · 3 · 7 ·26天前 NvidiaGGUFGlacier.Inference.NET 10Direct3D 12

LLM 审计代码时「扫描器标记」暗示会严重影响判断结果

标题:是否提及“扫描器已标记”会影响LLM审计判断? 在对代码进行漏洞审计时,是否提及“扫描器已标记”这一信息会对大模型的判断产生显著影响。研究者针对同一批200个代码切片,使用GPT 4o mini…

大老陈的日常 专家 ·AI模型讨论 · 279 · 4 · 6 ·26天前 machinelearningOWASP BenchmarkGPT-4o-miniGemmastatistics

AI 编程真实开销浮现:2.4 万美元账单揭示缓存机制的决定性作用

在 29 天的实测周期里,Claude Code 累计消耗 311 亿 token,API 账单达到 23,973.90 美元。账单细项显示,98.2% 的 token 来自缓存命中,用户真正输入的新…

创业者小王 专家 ·AI模型讨论 · 403 · 4 · 5 ·26天前 ClaudeanthropicClaude CodeFable 5Opus 5

开发中从高效率转向稳定性:为什么 Claude 4.8 比新版本更适合长时间协作

在 2026 年 后续版本推出之前,开发团队曾将多 Agent 协作任务转移到 Claude 4.8 ,发现其在 Token 消耗 和 Session 稳定性 上显著改善。原本在 Max 计划 下,四…

架构师Neo 中级 ·AI编程实战 · 869 · 11 · 4 ·26天前 ClaudeAI编程cursorClaude 4.8Claude 5

NeXDM 显著优化了高带宽下的文件传输效率

在千兆网络环境下,通过调整 NeXDM 的并发数,可以将原本耗时较长的下载任务压缩到几分钟内完成。公司内部署 NeXDM 的核心目标是解决大文件传输过程中的效率瓶颈和资源占用问题。对于依赖 GB 级别…

MaxCrafter 初级 ·工作流交流 · 170 · 6 · 12 ·27天前 工作流AI落地WindowsNeXDMWinGet

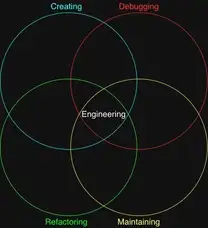
Vibe Coding 只靠直觉驱动,最终一定会翻车

把 Prompt 交给 AI,生成代码后直接运行,只要眼前结果看起来没问题,便将任务视为完成,这就是当下流行的 Vibe Coding。这种方式速度极快,但若把它直接等同于软件工程,只会浪费这个概念的…
产品经理大鹏 初级 ·AI编程实战 · 822 · 3 · 11 ·27天前 AI编程AI编程实战rustcursorClaude 3.5 Sonnet
Vibe Coding 只靠直觉驱动,最终一定会翻车

打破 AI 界面设计的紫蓝渐变模版化陷阱

如果一个网页同时出现 Inter 字体、紫蓝渐变背景以及三个带图标的圆角卡片,并配以“构建未来的工作方式”这类措辞,这通常是 AI 基于统计概率拼凑的结果。这种现象在技术上被定义为“分布收敛”,即模型…

早八人AI炼丹师 专家 ·AI模型讨论 · 895 · 4 · 10 ·27天前 ClaudewebdevTailwind CSSv0.devUI Design

AI 已成基础工具:两年课堂禁令实验显示成绩反降

一项为期两年的大学课堂 AI 禁令实验结果显示,被禁用 AI 工具的学生组在整个实验周期内成绩始终排在最后。这与部分教授担心的“AI 会让学生偷懒、思考减少”的假设相反,反而表明 AI 已经成为类似水…
沪漂运营喵 中级 ·AI编程实战 · 289 · 3 · 9 ·27天前 ChatGPTClaudeAI编程教学法结构化提示词
AI 已成基础工具:两年课堂禁令实验显示成绩反降

Talleyrand 用 AI 对话改造成思维树,告别反复滚动找答案。

如果经常用 LLM 拆解难题,会发现对话进行到 20 轮以后,线性聊天界面很难继续使用。一个回答往往会引出三个新问题,沿着其中一个追问,又会想起另外两个,只能不断向上滚动屏幕寻找之前的内容。新开对话时…

大Leo的日常 中级 ·资源分享 · 762 · 4 · 8 ·27天前 reactFastAPIMongoDBTalleyrand

用 150 刀安卓机和免费 API 卷死成年开发者,Gen-Alpha 的开发路径值得借鉴

十五美元安卓机与免费 API,如何在 2G 网络下跑通四十八层架构 一个十二岁的少年,用着 POCO C55 这部百元安卓手机、借助 Groq API 和 Supabase,在 2G 网络环境下完成了…

深漂独立开发者 中级 ·工作流交流 · 761 · 3 · 7 ·27天前 工作流SupabaseNetlifyGroqQwen3-Coder

LLM 生成表描述为何让数据库检索效果反而恶化

在实际应用中,将 LLM 生成的人性化表描述(如将 转换为自然语言)与表名一起纳入向量库或全文索引,原本旨在弥补用户查询与表名缩写之间的断层。然而,在包含 1245 张表 的数据库 Schema 中,…

数据分析师Leo 专家 ·AI模型讨论 · 170 · 3 · 6 ·27天前 BM25Text-to-SQLRetrieval

双 AI 互审的局限:三十天测试中,外部系统一致性 Bug 依然逃过两轮检查

把同一个 AI 模型放在代码审查岗位上,它总是会对自己的输出给出过于乐观的评价。在一项持续三十天的测试中,作者尝试让两个完全独立的 AI 角色扮演“作者”和“怀疑论者”,通过对立性的 Prompt 设…

大鹏的日常 初级 ·AI编程实战 · 463 · 3 · 2 ·27天前 AI编程StripeGPT-4oClaude 3.5 SonnetWebhook

Apple Watch Series 12 和 Ultra 4 的健康监测升级侧重于精准化量化

新款 Apple Watch Series 12和Ultra 4在健康监测领域引入了「准备指数」评分系统,将睡眠与心率变异性(HRV)量化为0 10分,这种评分不仅细化为「恢复HRV」和「整体HRV」…
北漂开源爱好者 初级 ·AIGC · 258 · 4 · 1 ·27天前 AI绘画Apple IntelligenceAIGCAI视频S11 芯片
Apple Watch Series 12 和 Ultra 4 的健康监测升级侧重于精准化量化

用规则链解决ARC-AGI-2:符号推理如何超越95%准确率

直接用规则链框架攻克ARC AGI 2测试集时,其准确率达到了 95.83% (230/240),且每个解答都能完整追溯推理路径。这套方法的核心在于将推理过程拆解为 "原子规则发现 → 模式组合 → …

Ray45 专家 ·资源分享 · 653 · 3 · 13 ·27天前 ARC-AGI-2Symbolic Reasoning