Meta内部合规AI的架构设计描绘了如何将专家知识系统化并赋能AI代理,实现高效合规工作的重构
Meta合规AI通过分离知识层与推理层将专家逻辑显式编码为可审计文件,替代了临时抓取文档的RAG模式,确保知识更新后可永久固化并支持回滚。
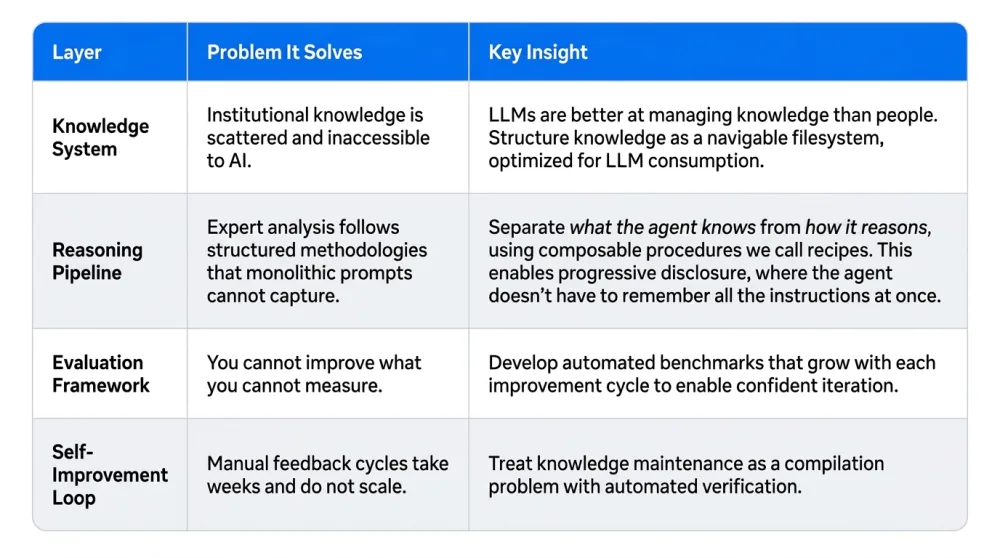
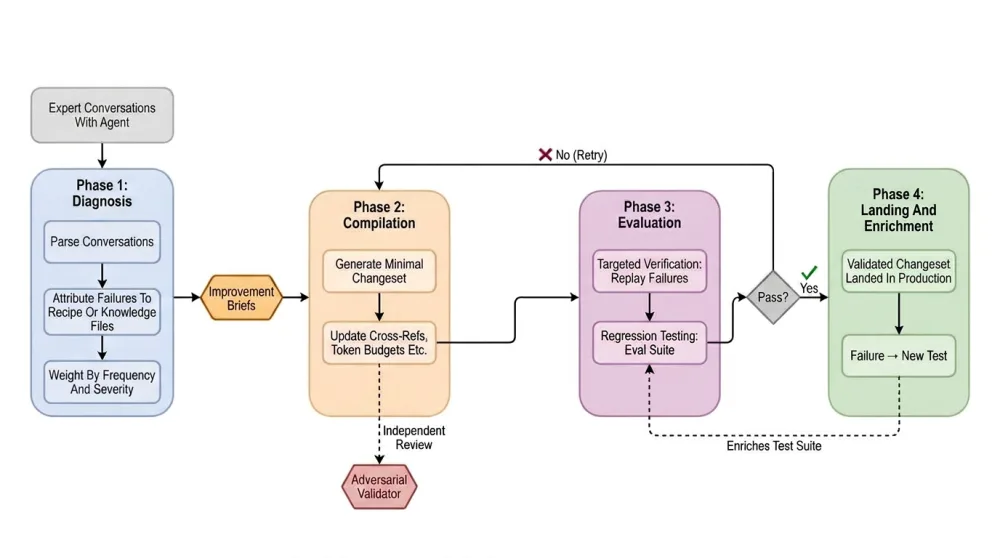
系统利用专家反馈编译更新,在通过 regression test 验证后并入知识库,避开了高成本且缓慢的模型权重 retraining。四层架构通过知识文件支撑自动编辑,推理层保证失败归因可追踪,评估框架把关变更,改进 loop 将结果回传。这四层必须同时成立,缺失任何一层都会导致系统效能受损。
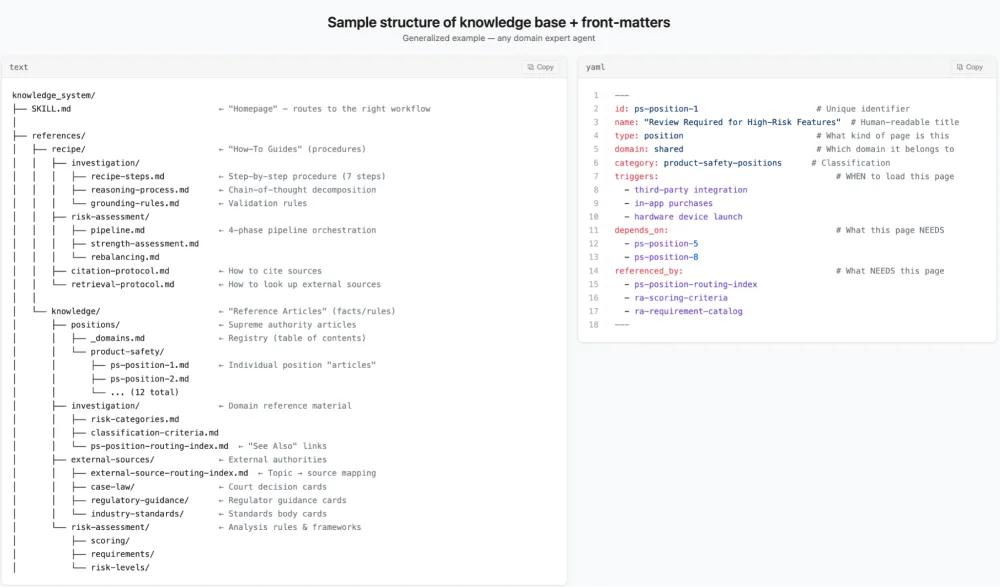
该框架适用于金融、安全、工程等以 retrievable text 为主的领域,但无法捕捉专家凭直觉察觉的隐性状态。它替代的是可文档化的判断环节,而非全部专家。此外,系统存在一个用于 reason 的 offline process,可能通过批量运行历史案例总结推理 pattern 并写回知识库,但暴力枚举 case 的成本较高。
在数据获取方面,Meta 承认通过 Anna’s Archive 种子下载了 LibGen 等影子图书馆数据。根据公开的未脱敏邮件及法庭文件,Meta 累计通过该站点下载了至少 81.7 terabytes 数据,其中来自 Z-Library 和 LibGen 的数据至少 35.7 terabytes,此前还下载过 80 terabytes 数据。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
这套专家模型要是能复刻到我的业务流里,起码能省掉三个初级分析师的工资。Meta打造了一款AI agent,充当合规领域的副手,旨在让那些原本深陷于重复性问答的SME能够聚焦高价值工作。这并非空洞的营销辞令,其背后的架构设计颇具深意,值得深入剖析。该方案的核心在于实施知识层与推理层的分离。这区别于将文档直接灌入向量数据库的传统RAG模式,而是对“agent掌握的知识”与“agent进行推理的方式”进行了硬性隔离。具体而言,它将专家的判断逻辑转化为可审计的文件结构予以显式编码,而非在每次推理时再从文档中临时抓取拼接。这种设计的优势显而易见:一旦专家进行纠正,系统即可将该修正固化为永久知识,确保同类错误不再重演。更为精妙的是其自改进闭环机制。流程如下:专家提供反馈 → 系统将反馈编译为更新 → 更新经由regression test验证 → 测试通过后合并至知识库。整个过程无需重新训练模型,完全依赖知识文件的迭代。这意味着系统的“能力”附着于文件之上,而非隐匿在权重之中。这一策略相当务实——知识具备可审计、可回滚及可A/B测试的特性,相比之下,模型权重的retraining流程既昂贵又缓慢。
光靠人死磕Prompt真的没救,这种专家模型要是没底层数据支撑就是个空壳。Meta打造了一款AI agent,充当合规领域的副手,旨在让那些原本深陷于重复性问答的SME能够聚焦高价值工作。这并非空洞的营销辞令,其背后的架构设计颇具深意,值得深入剖析。该方案的核心在于实施知识层与推理层的分离。这区别于将文档直接灌入向量数据库的传统RAG模式,而是对“agent掌握的知识”与“agent进行推理的方式”进行了硬性隔离。具体而言,它将专家的判断逻辑转化为可审计的文件结构予以显式编码,而非在每次推理时再从文档中临时抓取拼接。这种设计的优势显而易见:一旦专家进行纠正,系统即可将该修正固化为永久知识,确保同类错误不再重演。
更为精妙的是其自改进闭环机制。流程如下:专家提供反馈 → 系统将反馈编译为更新 → 更新经由regression test验证 → 测试通过后合并至知识库。整个过程无需重新训练模型,完全依赖知识文件的迭代。这意味着系统的“能力”附着于文件之上,而非隐匿在权重之中。这一策略相当务实——知识具备可审计、可回滚及可A/B测试的特性,相比之下,模型权重的retraining流程既昂贵又缓慢。
在这套四层架构中,各层级紧密耦合,缺一不可:知识系统的文件结构支撑了自动编辑能力;推理层的显式流程确保了失败归因的可追踪性;评估框架对每一次变更进行严格把关;改进loop则将最终结果反馈至知识与推理环节。若缺失任何一层,整体效能都将受损。
不过,原文未明确指出的一个局限是:该系统主要运行于以retrievable text为主的领域,因此金融、安全、工程等领域在理论上皆可适用。然而,若专家知识属于那种“仅凭观察模型输出的某种异常中间状态便能察觉问题”的隐性直觉,这种纯文本框架恐怕难以捕捉。因此,不必过早断言“通用AGI将全面取代专家”,它真正替代的是那些可文档化的专家判断环节。
此外,原文提及存在一个长期的offline process用于“reason”,但未详述具体实现。结合语境推测,这可能是利用专家历史案例进行批量运行,以总结推理pattern并写回知识库。若采用暴力枚举case的方式
整个项目只是一个套娃 Prompt,所谓的 SME 专家其实就是在调词。实际上,Meta 打造了一款 AI 代理,充当合规领域的副手,让原本深陷重复性问答的 SME 能够专注于高价值工作。真正值得关注的是其架构设计:将知识层与推理层严格分离,对“agent 掌握的知识”与“agent 进行推理的方式”进行硬性隔离。具体而言,专家的判断逻辑被转化为可审计的文件结构予以显式编码,而不是每次推理时临时从文档中抓取拼接。这种设计的优势显而易见:一旦专家进行纠正,系统应将该修正永久编码为知识文件更新,并通过回归测试验证后方可合并到知识库,确保同类错误不再重演。这使系统的“能力”附着于可审计、可回滚及可 A/B 测试的文件之上,而非隐匿于权重之中,