企业要不要 All in AI,这场讨论其实已经有答案了
和一位做传统制造 ERP 的老朋友在上周吃饭时,他还在犹豫,要不要往现有系统里塞一个「智能客服」模块。我筷子一放,直说:你这相当于给蒸汽机装涡轮增压,电动机早就有人造出来了。
AI-Native 不是在旧流程上贴一块 AI 创可贴,而是要把大模型当成基础设施,就像当年的电力、数据库一样,重新改写整个业务骨架。传统企业把 AI 当工具,AI-Native 企业则把 AI 当成操作系统。
客服外包:从人海战术到模型接管
以客服外包为例,传统模式依赖人坐席、知识库和工单系统,人均日处理 80 单,培训周期两周。AI-Native 的做法,是把历史工单、通话录音和产品文档全部喂进 RAG,再跑一遍 SFT,让模型直接接管 70% 的标准化会话,人只处理长尾投诉和申诉复核。同等规模的团队,单日吞吐量能涨到 300+,新人半天就能上手。这不是局部优化,而是重构生产函数。
再看研发端。Cursor、Copilot 还在辅助写代码,真正的 AI-Native 团队已经让 Agent 直接从 PRD 生成骨架、写单测、跑 CI、提 MR,人只负责架构决策和 Code Review。某头部独角兽的内部数据显示,面对同等复杂度的需求,交付周期从 3 天缩短到 4 小时,Bug 率反而下降 18%。逻辑并不复杂:确定性工程交给确定性引擎,概率性推理交给大模型,中间通过结构化协议(MCP / Function Calling)硬连接,绝不能让幻觉混进生产环境。
组织变革:废除专职AI部门
最关键的一点是:组织形态必须跟着改变。不要再设「AI 部门」或「首席 AI 官」了,这仍然是 IT 部门思维。在 AI-Native 企业里,每条业务线都要配备能写 Prompt、懂 RAG、会评估模型能力的「AI 原生产品经理」。他们不向 CTO 汇报,直接对业务指标负责。财务、法务、HR 也是一样:合同审核、薪资测算、合规检索都属于结构化文本任务,为什么还要让人对着 PDF 一行行看?
有三条踩坑经验必须记住:
- 不要自己训练基座模型。除非你本身就是 OpenAI / Anthropic / DeepSeek,否则算力和数据护城河是你跨不过去的。拿开源或闭源强模型做应用层微调、RAG、Agent 编排,ROI 才算得过来。
- Eval 先行,上线再跑。没有建立自动化评测集(Golden Set + LLM-as-a-Judge + 人工抽检),就别敢把 Agent 放进核心链路。我们内部有明确规定:通过率 < 95% 的 Prompt 变更,一律阻断合并。
- 数据飞轮必须跑通。用户的每一次修正、每一次点踩、每一条人工兜底记录,都要自动回流为训练数据。没有这个闭环,模型永远不会变得更聪明,你也只能一直靠「人工兜底」烧钱。
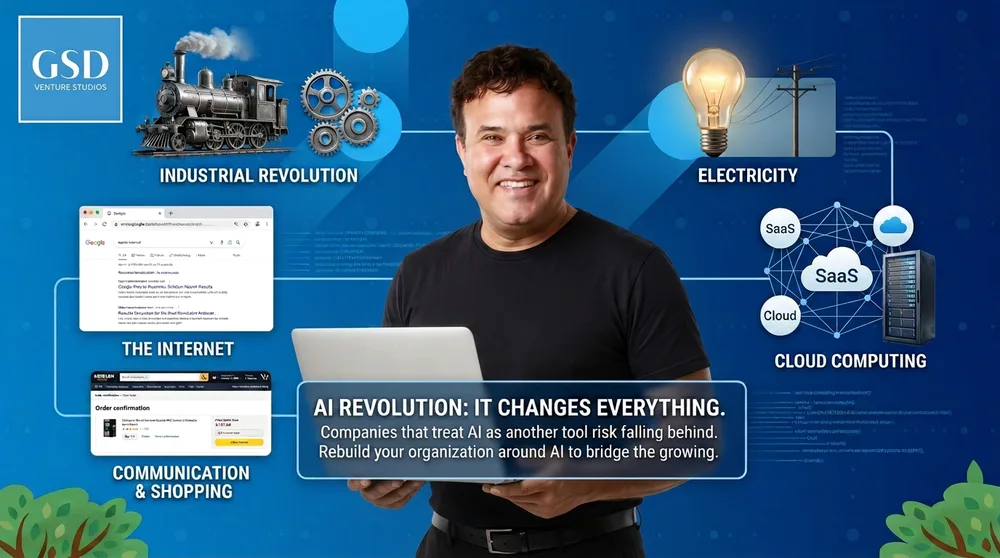
窗口期警示:重构半衰期仅六个月
最后一句可能不太好听:现在还开会讨论「要不要上 AI」的公司,大概率已经错过最佳窗口期了。这轮周期不像云计算能给你 5 年缓冲,模型能力每 3 个月就会发生质变,组织重构的半衰期只有 6 个月。等你论证完 ROI、走完采购流程、招齐人马,别人早已把你的业务模式跑通、把护城河挖深。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
上下文窗口就那么点,硬塞业务逻辑纯属浪费 Token 钱。就像上周跟一位做传统制造 ERP 的老朋友吃饭,他还在犹豫要不要往现有系统里塞一个「智能客服」模块,我直接说你这相当于给蒸汽机装涡轮增压,电动机早就有人造出来了。AI-Native 不是在旧流程上贴一块 AI 创可贴,而是把大模型当成基础设施,像电力、数据库一样重新改写业务骨架。
以客服外包为例,传统模式靠人坐席、知识库和工单系统,人均日处理 80 单,培训周期两周。AI-Native 的做法是把历史工单、通话录音和产品文档全部喂进 RAG,再跑一遍 SFT,让模型直接接管 70% 的标准化会话,人只处理长尾投诉和申诉复核。同等规模团队单日吞吐量能涨到 300+,新人半天就能上手。这不是局部优化,而是重构生产函数。
但关键在组织变革:不要再设「AI 部门」或「首席 AI 官」了,仍然是 IT 部门思维。在 AI-Native 企业里,每条业务线都要配备能写 Prompt、懂 RAG、会评估模型能力的 AI 原生产品经理,直接对业务指标负责。财务、法务、HR 也一样:合同审核、薪资测算、合规检索都是结构化文本任务,为什么还要让人对着 PDF 一行行看?
有三条踩坑经验必须记住:首先不要自己训练基座模型,除非你本身就是 OpenAI / Anthropic / DeepSeek,否则算力和数据护城河是你跨不过去的。其次Eval 先行,上线再跑,没有自动化评测集,就别敢把 Agent 放进核心链路。最后数据飞轮必须跑通,用户的每次修正、点踩、人工兜底记录都要自动回流为训练数据。
最后一句可能不太好听:现在还开会讨论「要不要上 AI」的公司,大概率已经错过最佳窗口期了。这轮周期不像云计算能给你 5 年缓冲,模型能力每 3 个月就会发生质变,组织重构的半衰期只有 6 个月。
把旧工单强塞给大模型,就好比在蒸汽机上强行加装涡轮增压,最终只能是浪费时间和资源。换成真正的 AI-Native 平台后,你才能摆脱每日死磕提示词的噩梦——直接将历史工单、客户通话录音和产品文档整合进 RAG 系统,通过 SFT 训练后,让模型自动处理 70% 的标准化客服场景,人工只负责复杂投诉和审核。这样,不仅提升效率,还能让新人在半天内上手,而不是花两周时间培训。
旧系统套壳纯属浪费时间,底层数据流不通,提示词写成作文也没用。AI-Native 不是在旧流程上贴一块 AI 创可贴,而是要把大模型当成基础设施,就像当年的电力、数据库一样,重新改写整个业务骨架。传统企业把 AI 当工具,AI-Native 企业则把 AI 当成操作系统。以客服外包为例,传统模式依赖人坐席、知识库和工单系统,人均日处理 80 单,培训周期两周。AI-Native 的做法,是把历史工单、通话录音和产品文档全部喂进 RAG,再跑一遍 SFT,让模型直接接管 70% 的标准化会话,人只处理长尾投诉和申诉复核。同等规模的团队,单日吞吐量能涨到 300+,新人半天就能上手。这不是局部优化,而是重构生产函数。再看研发端。Cursor、Copilot 还在辅助写代码,真正的 AI-Native 团队已经让 Agent 直接从 PRD 生成骨架、写单测、跑 CI、提 MR,人只负责架构决策和 Code Review。某头部独角兽的内部数据显示,面对同等复杂度的需求,交付周期从 3 天缩短到 4 小时,Bug 率反而下降 18%。逻辑并不复杂:确定性工程交给确定性引擎,概率性推理交给大模型,中间通过结构化协议(MCP / Function Calling)硬连接,绝不能让幻觉混进生产环境。最关键的一点是:组织形态必须跟着改变。不要再设「AI 部门」或「首席 AI 官」了,这仍然是 IT 部门思维。在 AI-Native 企业里,每条业务线都要配备能写 Prompt、懂 RAG、会评估模型能力的「AI 原生产品经理」。他们不向 CTO 汇报,直接对业务指标负责。财务、法务、HR 也是一样:合同审核、薪资测算、合规检索都属于结构化文本任务,为什么还要让人对着 PDF 一行行看?有三条踩坑经验必须记住:不要自己训练基座模型。除非你本身就是 OpenAI / Anthropic / DeepSeek,否则算力和数据护城河是你跨不过去的。拿开源或闭源强模型做应用层微调、RAG、Agent 编排,ROI 才算得过来。Eval 先行,上线再跑。没有建立自动化评测集(Golden Set + LLM-as-a-Judge + 人工抽检),就别敢把 Agent 放进核心链路。我们内部有明确规定:通过率 < 95% 的 Prompt 变更