文档站上92%召回率为何在真实场景中跌至65%?
实验室环境下,搜索引擎的 recall@1 可达92%,但部署 chops-search 到实际文档站后,召回率骤降至65%。这种落差并非偶然,而是由文档站的特定结构和测试设置共同导致的。
文档站的“陷阱”如何拖垮召回率
文档站看似简单,但其特性使得搜索引擎的性能表现脆弱。以某开发者测试的场景为例:
- 规模与密度的矛盾:文档站仅包含 19个页面、132个数据块,但关键词密度极高,查询与文档间的语义匹配变得极为敏感。一旦权重偏差,召回率便会断崖式下降。
- 结构化文档的“双刃剑”:采用 Diátaxis 结构编写的文档,逻辑严密且分类清晰,但这意味着查询词与文档内容的对齐度要求更高。稍有调整,排名就可能崩塌。
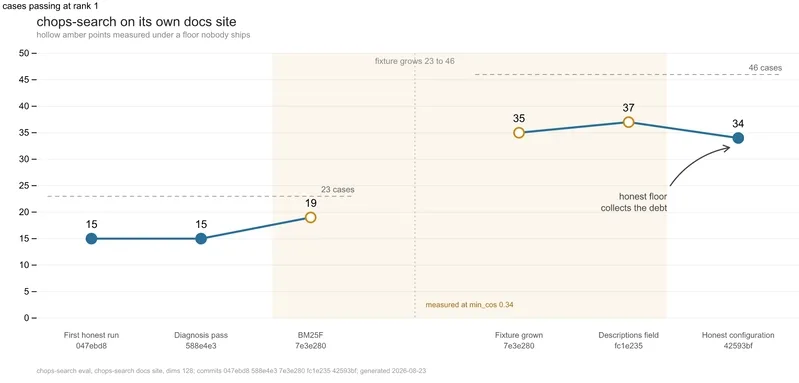
- 测试集扩容后的真相:最初 23个case 的召回率基准为65%,但扩充至 46个case 后,单纯依赖百分比无法反映实际通过案例数的变化。这意味着部分“优化”可能只是在特定测试集下表现良好,而在更广泛场景中失效。
调优过程中暴露的“伪效果”
开发者尝试了四种排名策略,但每次调整都在改变“测试环境本身”,而非优化核心逻辑。具体表现如下:
- 基准线(Baseline):在 23个case 下,召回率为65%。
- 应用 BM25F 算法:召回率瞬间上升至83%,但扩大测试规模后,实际召回率回落至76%,说明该算法在更复杂场景中的适应性有限。
- 添加描述字段:召回率回升至80%,但这种提升可能依赖于测试集中特定的描述模式,无法保证在生产环境中一致适用。
- 恢复生产配置(Honest Configuration):所有参数调回实际运行设置后,召回率进一步下降至74%。这表明,任何在“极端配置”下取得的优化(如调高
min_cos阈值至0.34)都无法在真实场景中复现。
关键问题在于:在评估时人为调高阈值,可能只是在“刷分”而非真正提升召回质量。这种“测量债”在生产环境中会暴露出来,导致实际效果与实验室数据严重不符。
实战中的核心洞见
- 避免单一指标误导:高 recall@1 在实验室环境下可能看似理想,但在实际应用中,必须结合 测试集的覆盖度和业务场景分布 进行综合判断。单纯依赖百分比无法反映全貌。
- 警惕“不可复现”的配置:如果评估指标是在 非生产环境下的特殊调整(如强制提高阈值)下取得,那么 CI 自动化测试门禁 可能只是在“刷分数”,而非真正保障系统质量。
- 优化路径的选择:直接增加有效信息(如扩充证据)往往比调整排序权重(如 BM25F)更能稳定提升召回率。这意味着,在搜索或 RAG 系统中,证据的质量和多样性 往往比算法本身更关键。
在工程化落地过程中,必须确保评估流程与生产环境完全对齐,否则数据可能仅反映特定条件下的表现,而无法预测实际应用效果。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
远
直接拿长难句怼一遍,那个92%的召回率估计能掉到50%以下。别迷信实验室里的漂亮数据,写搜索引擎的人最容易掉进这个坑,我见过一个实战案例,开发者发布时号称首位召回率92%,接入自己文档站并加CI门禁后,真实评估只有65%。而且调优过程也全是坑,比如把阈值调到不符合生产环境的0.34,分数好看但实际跑不出来,这就是在刷测量债,不是保质量。建议评估流程必须跟生产参数完全对齐,否则你跑出来的曲线只是在自我感动。
0
免费 AI 工具箱 · 全部完全免费
同类方向的延伸案例可以参考AI大模型变现案例库,有不少直接可参考的案例。
实验室数据纯纯是骗人的,我跑自己的 Bad Case 库直接被打回原形。就像那个把 recall@1 吹到 92% 的项目,一旦接入真实文档站,真实评估结果只有 65%。