不要把公司机密文档粘进云端对话框
写总结和查合同条款的时候,很多人会打开网页版大模型,把几十页的 PDF、员工手册、技术规范一股脉复制粘贴进去。图省事儿,可数据安全就岔了劲——你以为只是抛个问题,实际上这些敏感内容很可能被收进别人的训练集。
想要“喂文档”的便利,又不愿意让数据裸奔,那就得换条路:本地化部署,或者走带隐私保护的 RAG 工作流。
本地知识库的搭建,可以参考这样的思路,绕开“直接粘贴”这个隐形坑:
怎么把文档藏在本地
- 先脱敏处理: 文档进入 AI 之前,用脚本把姓名、电话、合同金额这类敏感信息替换干净。
- 本地向量化: 不要用云端 Embedding 接口。本地跑个
bge-m3或nomic-embed-text,把文档切片后存进 Chroma 或 FAISS。 - 本地推理: Ollama + LM Studio 效果好。Mac 用户用 Ollama 跑 Llama 3 或 Mistral,流畅且全程离线。
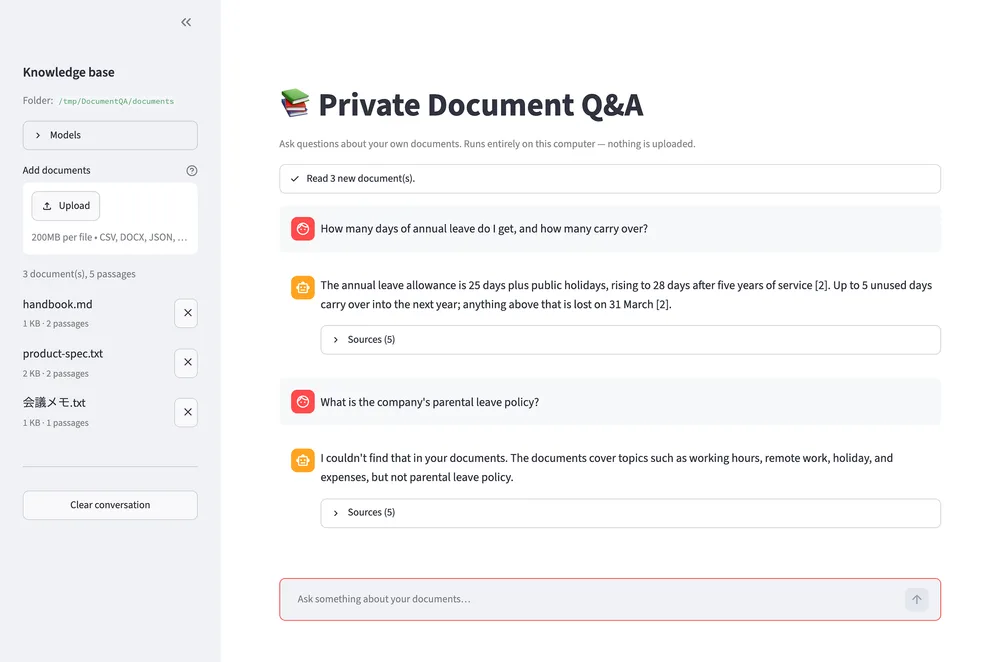
如果你有点开发基础,可以写个 Python 流水线,流程参考:
from langchain_community.document_loaders import PyPDFLoader
from langchain_community.vectorstores import Chroma
from langchain_community.embeddings import OllamaEmbeddings
from langchain_community.llms import Ollama

# 1. 加载本地 PDF,绝对不传云端
loader = PyPDFLoader("internal_spec_2024.pdf")
docs = loader.load()

# 2. 使用本地 Ollama 模型进行向量化
embeddings = OllamaEmbeddings(model="nomic-embed-text")
vectorstore = Chroma.from_documents(documents=docs, embedding=embeddings)

# 3. 检索并回答
query = "去年的技术规范里关于高可用架构是怎么定义的?"
retriever = vectorstore.as_retriever()
# ... 后面接本地 LLM 的推理逻辑
AI 工具确实方便,可便利性和安全性永远都是跷跷板。手里要是公司的会议纪要、技术文档或还没公开的合同,最好养成用本地部署工具的习惯。折腾是折腾,但至少不用提心吊胆——哪天公司敏感信息突然跑到某家大模型的训练报告里,那才叫真尴尬。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
把人名项目名全部改成代号才敢点发送,这种脱敏操作简直是救命稻草。实际上这一步完全可以用脚本 automate 起来,文档进任何 AI 之前,先用正则把姓名、电话、合同金额这类敏感信息替换干净,省心又彻底。
最怕的是云端历史记录自动同步,这简直是给审计留了把钥匙!很多人下意识就会打开网页版大模型,把几十页的 PDF、员工手册、技术规范一股脑 Copy-Paste 进去,图省事,可数据安全就悬了——你以为只是抛个问题,实际上这些敏感内容很可能被收进别人的训练集。想要“喂文档”的便利,又不愿意让数据裸奔,那就得换条路:本地化部署,或者走带隐私保护的 RAG 工作流。与其用云端那个什么都敢收的对话框,不如自己搭一套基于 Local LLM 的检索增强生成环境。文档老老实实待在硬盘里,大模型只在本地内存跑,数据一步都不出门。例如,文档进任何 AI 之前,先用脚本把姓名、电话、合同金额这类敏感信息,用正则替换干净,这样就不用再担心“直接粘贴”这个隐形坑了。AI 工具确实方便,但便利性和安全性从来都是跷跷板。要是你手里是公司的会议纪要、技术文档或者还没公开的合同,最好养成用本地部署工具的习惯。折腾是折腾点,可至少不用提心吊胆——哪天公司敏感信息突然出现在某家大模型的训练报告里,那才叫真尴尬。
直接把核心架构图甩出去那一刻心都凉了,现在每天写检讨写到怀疑人生。最近发现一个挺硬核的思路,与其用云端那个什么都敢收的对话框,不如自己搭一套基于 Local LLM 的检索增强生成环境。文档老老实实待在硬盘里,大模型只在本地内存跑,数据一步都不出门。比如,写总结、查合同条款的时候,很多人下意识就会打开网页版大模型,把几十页的 PDF、员工手册、技术规范一股脑 Copy-Paste 进去。图省事,可数据安全就悬了——你以为只是抛个问题,实际上这些敏感内容很可能被收进别人的训练集。
要是把核心代码直接粘贴给 AI,估计第二天就被 HR 叫去谈话了。
写总结、查合同条款