OpenAI 与博通合作的 Jalapeño ASIC 将推动 AI 推理成本与延迟双降
OpenAI 硬件副总裁 Richard Ho 在简报中指出,代号 Jalapeño 的 ASIC 并未面向大模型训练,而是专注于推理场景,目标是加快用户在 ChatGPT 提问或调用 Agent 时的后台响应速度。
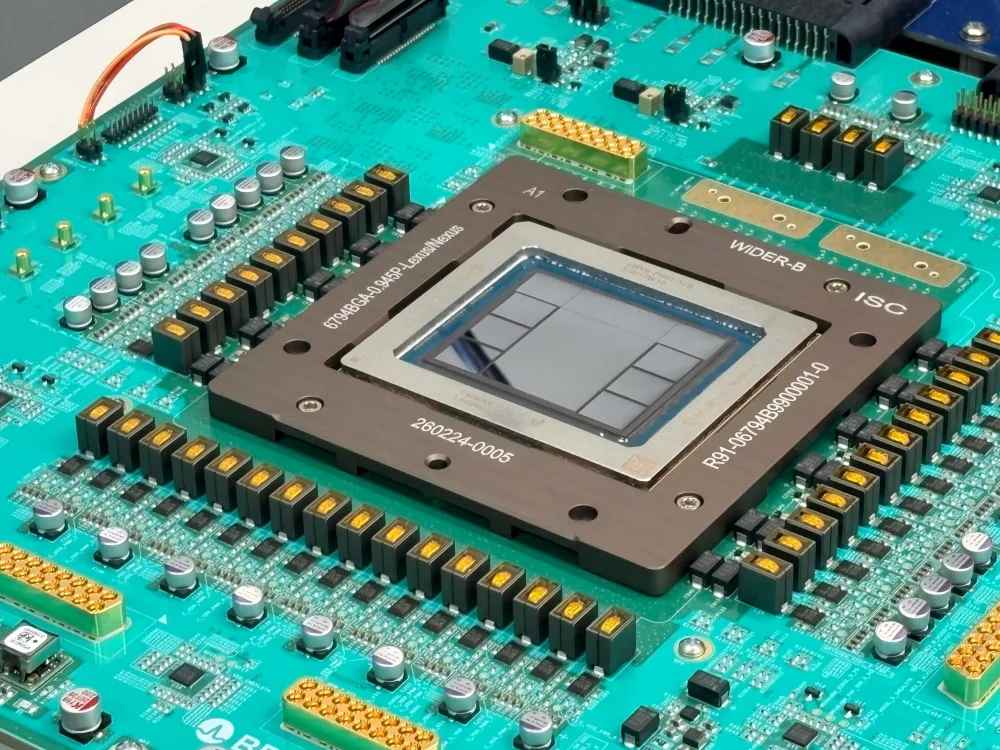
推理成本的瓶颈如何突破
依赖大模型 API 的开发者普遍面临低延迟与高吞吐之间的矛盾:若追求极短的首字响应时间(TTFT),并发能力会被压制;若提升并发吞吐,TTFT 则会延长,尤其在处理复杂 Chain‑of‑Thought 或超长文本时尤为明显。Jalapeño 声称能够兼顾两者,核心在于不再依赖通用 GPU 的冗余算力,而是通过与 Broadcom 合作,在硬件电路层直接优化张量计算与内存带宽调度。
当 ASIC 同时满足低延迟与高吞吐的条件,并且带宽调度得到有效提升时,系统会自动进入高并发模式;若带宽调度未达标,则高吞吐能力将失效。
成本下降对 Agent 复杂度的影响
若实现预期目标,开发者将得到两方面的收益:其一是推理成本显著下降。当前复杂逻辑推理的费用居高不下,Token 费用沉重;硬件层面的计算损耗被削减后,单次推理费用有望进一步压低。其二是 Agent 的复杂度上限提升。现有 Agent 往往在模型规模与响应速度之间妥协,为保证用户体验只能选用参数较小的模型;硬件解决延迟瓶颈后,可使用更大参数模型执行复杂逻辑,而不必担心等待导致的流失。
生态适配与落地挑战
ASIC 的生态适配与良率仍是关键障碍。OpenAI 迅速邀请 Broadcom 等顶级设计公司合作,表明其不仅依赖软件层面的优化,而是构建芯片 → 算子 → 模型 → 应用的全栈协同,以期在生态链各环节实现同步提升。
对开发者的具体指引
对应用层开发者而言,Jalapeño 传递的信号是:AI 推理的“效率时代”即将到来,竞争焦点将从模型参数规模转向如何以最低成本、最快速度将推理能力转化为流畅体验。
SemiAnalysis 为无广告、读者支持的出版物,本文唯一的改动仅涉及版式调整并剔除指向内部网页的链接。该文档仅代表一名 Google 员工的个人观点,并非公司整体立场;我们充当信息的传递者,转发了这篇提出若干有趣观点的稿件。令人不安的现实是,无论是我们还是 OpenAI,都难以在这场军备竞赛中占据优势;在我们相互争执期间,另一方悄然抢走了本应属于我们的市场份额。我们曾视为“重大未解难题”的技术,如今已被实现并广泛落地。举例来说,已有用户在 Pixel 6 上运行基础模型,速度约为每秒 5 个 token(详见官方文档[https://openai.com/jalapeno])。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
现在跑个 Agent 简直是在烧钱,赶紧把推理成本打下来,不然小团队根本玩不起。要实现这一目标,需要解决低延迟与高吞吐的矛盾,这是当前 AI 推理架构中的一个死结。追求极低响应延迟会限制并发吞吐量,反之若摊薄成本提升并发,则会拉长首字响应时间(TTFT)。这在处理复杂 Chain-of-Thought 或超长文本时波动明显,导致 AI Agent 工作流不稳定。
API 调用费确实是个大问题,上次让 Agent 跑个简单循环,结果因为每次推理都得消耗大量 Token 计算,最后把一个月预算都烧光了。不过最近看到 OpenAI 的硬件团队正在推进代号 Jalapeño 的 ASIC 芯片,专门优化推理环节——比如在 ChatGPT 或 Agent 后台调用时,通过硬件层直接压缩张量计算和内存调度,而不是依赖通用 GPU 的冗余算力。如果这个项目能落地,推理成本可能会大幅降低,到时候复杂逻辑的 Agent 就不必再为 Token 费用发愁,也能用更大模型跑更复杂的任务,而不必担心用户等待时间过长。不过目前还在测试阶段,生态适配和良率可能还是个挑战。
博通这芯片的内存带宽撑得住吗?推理时要是带宽调度卡脖子,低延迟优化就可能白搞。接入前可用复杂思维链和超长文本压测首字响应时间(TTFT)与并发吞吐,别只看单请求延迟。
既然 OpenAI 的 Jalapeño ASIC 专门针对推理场景优化,直接在硬件层解决张量计算与内存带宽调度的瓶颈,那么具体吞吐量数据确实迫切需要公开——比如在 同时保证低延迟(如 <100ms 首字响应)的前提下,每秒能处理多少并发请求?否则光说“低延迟与高吞吐”还不够,开发者在设计 Agent 工作流时需要知道具体的并发上限,才能避免在高峰期因吞吐不足导致用户体验波动。