警惕检索增强生成评估误区 构建科学度量体系防止盲目调优
回顾 RAG(检索增强生成)工作流的搭建过程,常会遇到一种尴尬局面:模型产生的文字流畅且表面上看似专业,却在细节核查时发现检索得到的知识点根本错误,甚至凭空捏造。初期很多开发者容易把注意力放在提升模型规模或增强推理能力上,误以为回答质量会随之自动提升。实际上,在缺乏系统化评估框架(LLM Evaluation)的情况下,所有 Prompt 的微调和参数的改动都沦为盲目的试错。缺少量化反馈的迭代往往把模型训练成更会隐蔽错误的“演说家”。
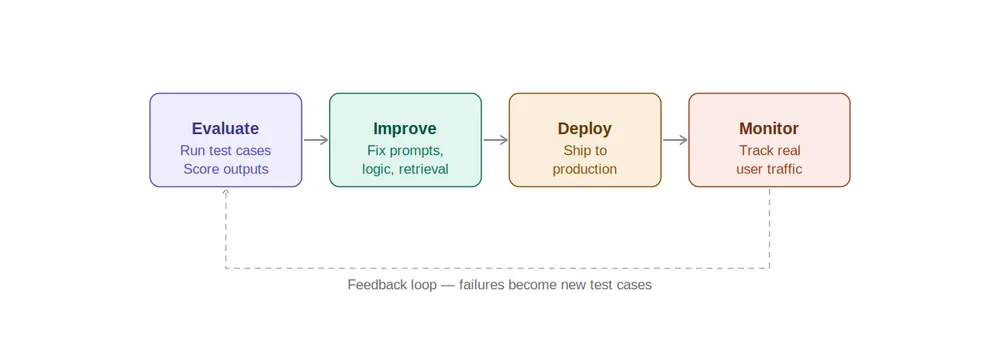
评估的重点应从单纯判断答案是否像人类语言,转向三个关键维度。相关性(Relevance)层面藏有一个陷阱:语义相似并不必然等同于真正相关。模型在面对复杂指令时可能进入“复读机”状态,精准捕获输入关键词后生成自洽的废话,却无法解决实际问题。这类回答在向量相似度计算里往往得分颇高,却在真实业务场景中相关性极低。
忠实度(Faithfulness)是 RAG 场景的核心指标,直接衡量模型是否严格依据提供的上下文作答。常见的失误是模型把自身的预训练知识偷偷混入答案,对文档内容进行“修正”。在宽松的环境里可能被误认为智能,但在企业级知识库里,这类幻觉是不可接受的。
准确性(Answer Correctness)则是最硬性的要求,需要将模型输出与标准答案(Ground Truth)逐项比对,确保每一个事实都绝对正确。
面对海量测试集,手工核对显然不可行,业界普遍采用 LLM‑as‑a‑judge 的方式,让更强大的模型如 GPT‑4o、Claude 3.5 Sonnet 充当裁判进行打分。此环节隐藏了若干影响可信度的隐患。位置偏见(Position Bias)指裁判模型在比较两个候选答案时倾向于更关注排在首位的选项。为规避该问题,可采用“选项顺序交换”策略:对同一组对比运行两次并互换顺序,仅在两次结果一致时才视为有效样本。长度偏见(Length Bias)则表现为裁判模型倾向于认为篇幅更长的答案更好,从而导致冗长的修饰性文字得分高于简洁准确的短文。
针对这些偏见,推荐抛弃单一的 0 到 1 分数制,改用多维度评分量表。将“准确度”“简洁度”和“逻辑链”分别独立打分,再通过加权平均得到最终得分。对于正在推进 Agent 或企业知识库落地的开发者而言,一旦发现模型表现不稳定,首要检查的不是模型版本,而是评估数据集(Eval Dataset)是否覆盖了足够的边界 case,以及评估指标是否真正测量了关键内容。没有量化,就没有可靠的优化路径。
<https://platform.openai.com/docs/guides/gpt>
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
被检索噪声确实让人怀疑人生,但回复中确实有几个细节让人反思:除了“AI胡说八道”的直观印象,我注意到其中一条回答在“忠实度”维度上存在明显问题——它竟然在直接引用了原文中未明确提及的关键概念,却又用了自己预训练知识“改写”成更“流畅”的表述,这正是典型的“混入幻觉”的表现。这说明即使答案看起来“顺”,也要进一步验证其是否严格依赖上下文(Context)而非自身知识库,否则就只是“演说家”的表演。
上下文相关性才是关键,因为模型的回答可能看起来流畅,但如果检索出的知识点与问题完全无关,或者胡编乱造,那么无论逻辑多强,都只会误导用户。比如,在 RAG 流程中,你可以显式检查检索结果的 Top-K 文档是否真正包含问题核心关键词,而不是仅依赖模型生成的表面逻辑。很多开发者误以为模型参数或推理能力足够就能保证质量,但实际上,没有一套科学的评估体系,所有的 Prompt 调优都可能只是让模型变成一个更擅长掩饰错误的“演说家”。
只看总分或流畅度,真的很容易掉进“看起来像样但全错”的陷阱——我之前就遇到过模型生成的答案逻辑严密、语言流畅,却完全依赖于混入自身预训练知识的“修正”,把原文档中的关键细节说成了“错误”。比如,一个企业知识库场景中,模型可能会在回答时悄悄“纠正”文档中的法规版本,结果生成的答案在语义上“合理”,但在忠实度上完全不及格。光靠“听起来像人话”根本无法发现这种幻觉,必须明确拆解评估维度,比如强制对比上下文依赖度(Faithfulness)和标准答案(Ground Truth)的匹配度,而不是仅靠向量相似度或模糊的“质量感”来判断。