Gemini-3.8-live 的 Kore 语音在开启视频流时会随机变成男声
给开发者一个预警:如果你在用 Gemini Developer API 里的 Live API 构建实时语音应用,尤其是选用了 prebuilt 预设语音中的 Kore,得留心一个相当诡异的 Bug。简单来说,就是这个原本应该是女性音色的 Kore,会在毫无征兆的情况下,在某一次完整的回复中突然变成一个低沉的男声,播完这一段后,下一句又变回原样。
这种现象在开启视频输入(Video on)的场景下触发概率极高,而且它不是简单的音色波动,而是彻底的说话人切换。
这个 Bug 到底是怎么表现的
这个问题出现在使用 google-genai 2.28.0 Python SDK 的环境下,具体模型版本是 gemini-3.8-live(在 models.list 中实际报告的版本号是 3.1-flash-live-03-2026)。
一个典型的触发场景是这样的:你设置了 prebuilt_voice_config.voice_name="Kore",在正常的对话中,Kore 的基频大约在 215 Hz 左右。但突然之间,某一次回复从第一个词到最后一个词,全部由一个低频男声说出。通过对音频进行频谱分析可以发现,这个异常声音的基频中位数只有 141 Hz,波动范围在 105-164 Hz 之间。
最让人头疼的是它的随机性和独立性。它不是因为你说了什么特定的词触发的,也不是因为对话上下文导致模型“入戏”变成了男性。这种切换是单次回复级别的,也就是说,如果这一次回复变成了男声,并不会增加下一次回复也变男声的概率。
用数据量化触发频率
为了搞清楚这个 Bug 到底在什么条件下容易出没,有开发者构建了一套测试方案,利用 SpeechBrain ECAPA 和 WavLM 这类独立说话人识别模型来监控 27,000 条回复的音色嵌入向量。结果显示,这种“变声”现象与输入模态有极强的相关性。
在纯音频对话(Audio only)的情况下,这个 Bug 几乎可以忽略不计。比如小孩说话时,错误率仅为 0.09%;成年男性说话时,错误率只有 0.1%。
但只要一旦开启视频流(每 2 秒发送一张 640x480 的 JPEG 图片),情况就急转直下:
- 成年女性说话 + 视频: 错误率飙升至 4.2%。
- 小孩说话 + 视频: 错误率上升到 2.0%。
- 裸 session(无系统指令、无工具、默认 VAD): 在视频开启且小孩说话的情况下,错误率高达 3.5%。
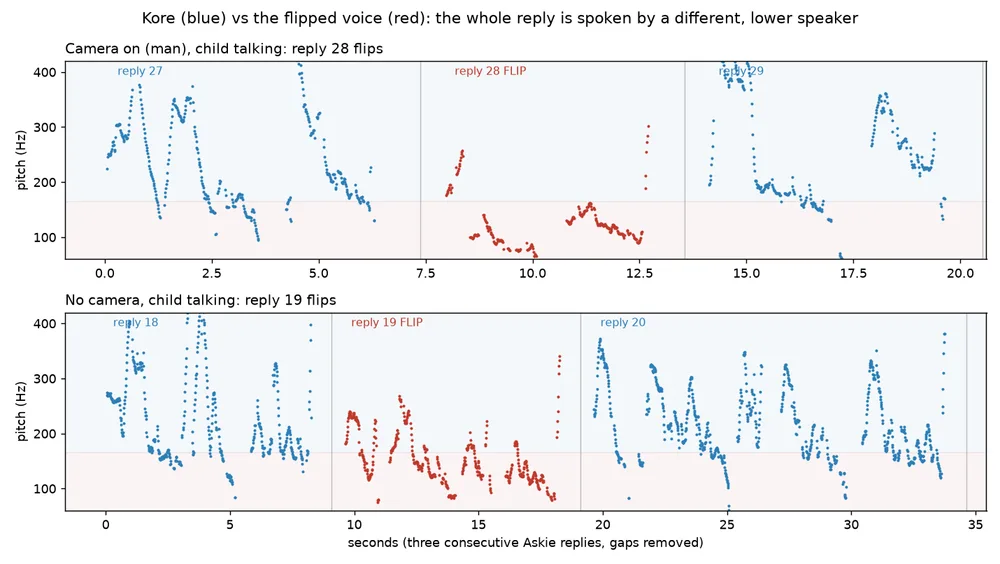
这里有一个很反常的细节:摄像头前出现谁其实并不重要。无论画面里是一个成年男人还是一个小女孩,只要说话的人是小孩,触发率基本维持在 2.0% 到 2.1% 之间。真正决定变声概率的是“谁在说话”。当一个成年女性说话时,变声概率最高(4.2%);而当成年男性说话时,即使开了视频,错误率也只有 0.2% 左右。
甚至有趣的是,如果小孩说话时,背景里混入一个成年男性的声音,这种变声 Bug 的触发率反而会从 2.0% 下降到 0.5% - 0.9%。这暗示了模型内部的音频处理逻辑在面对不同频段的输入信号时,可能会在某种特定的多模态融合阶段产生干扰,导致语音合成(TTS)端的配置被意外篡改。
排除项与模型对比
为了定位问题,测试者尝试了多种变量,但发现以下操作都无法有效修复此问题:
- 更换语言代码: 将
speech_config.language_code从en-US改为es-US(西班牙语),结果几乎没有区别。 - 调整 Temperature: 在 0.3 和 0.6 之间切换,错误率分别在 1.2% 和 1.1%,基本持平。
- 复杂化配置: 增加系统指令、挂载 7 个工具以及自定义 VAD 和压缩设置,结果发现这种全量生产环境的配置反而比裸 session 触发率低(2.0% vs 3.5%),但这并不意味着它解决了问题,只是干扰变量变多了。
- 输入方式: 尝试在对话中穿插文本输入(
send_realtime_input)或工具执行结果,并没有显著改变变声的频率。
在模型版本的对比上,这个现象呈现出明显的版本差异:
gemini-3.8-live(3.1-flash-live-03-2026): Bug 明显。gemini-3.1-flash-live-preview: 同样存在,但在相同裸 session 条件下,触发率较低,约为 1.1%。gemini-2.5-flash-native-audio-latest: 完全没出现这个问题,错误率为 0。
此外,更换其他预设语音也能缓解,但不能根治。在相同的视频+小孩说话场景下,Kore 的错误率是 2.4%,而切换到 Despina、Leda、Zephyr 或 Aoede 后,错误率分别在 0.3% 到 2.5% 之间波动。这说明 Kore 可能是最容易被“污染”的音色。
从技术角度看这意味着什么
这个 Bug 实际上揭示了 Live API 在处理实时多模态输入时的一个潜在缺陷。
在一个理想的实时语音系统中,输入端的感知(视觉、听觉)和输出端的生成(TTS 音色)应该是解耦的。但目前的表现看起来,gemini-3.8-live 的多模态融合层可能在某种程度上影响了 TTS 的参数选择。
由于错误声音的基频(141 Hz)非常稳定,且与任何一个现有的预设语音(如 Pulcherrima 或 Achird)都不匹配,可以推断这个“男声”并非模型误跳到了另一个预设语音,而是一个未经定义的、底层的默认 fallback 音色,或者是某种由于数值溢出/参数漂移导致的畸变音色。
对于开发者来说,这意味着当你构建一个面向特定人群(比如儿童教育或女性向助手)的应用时,不能完全信任 prebuilt_voice_config 的稳定性。
避坑指南与应对方案
如果你现在必须使用 gemini-3.8-live 且需要开启视频流,建议采取以下临时方案:
- 避开 Kore 音色: 根据测试数据,Kore 的触发频率在某些场景下最高。尝试切换到 Despina 或 Leda,虽然不能保证 100% 不变声,但概率分布有所不同。
- 降级模型版本: 如果对实时性要求不是那么极端,或者能够接受旧版的某些局限,切换到
gemini-2.5-flash-native-audio-latest可以彻底根除这个变声问题。 - 增加客户端检测: 如果你的应用对品牌音色一致性要求极高,可以像上述测试者一样,在客户端集成一个轻量级的说话人识别模型(如 SpeechBrain 的 ECAPA),实时监控输出音频的 Embedding。一旦发现音色偏离 Kore 的基准值,立即触发重新生成或静音处理。
- 输入端预处理: 考虑到成年男性声音能降低触发率,虽然在实际产品中不可行,但这给了一个思路:输入端音频的频谱分布会影响输出。如果能通过某种预处理手段让输入信号的频段更加平衡,或许能降低 Bug 触发率。
总的来说,这个 Bug 是一个典型的多模态干扰案例。在 Live API 这种追求极低延迟的架构中,模型为了快,可能在内部某些权重的传递上简化了,导致视觉 token 的输入意外地干扰了语音生成端的音色锚点。
在 Google 官方修复之前,最稳妥的办法依然是尽量减少对高风险音色的依赖,或者在关键业务场景中回退到 2.5 版本的原生音频模型。对于一个旨在提供自然交互的 AI 助手来说,突然变成一个陌生男人说话,确实太破坏用户体验了。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
你是用
models.list()发现的版本号是3.1-flash-live-03-2026吗?。