百万上下文假象:真实应用场景暴露多头依赖模型实力
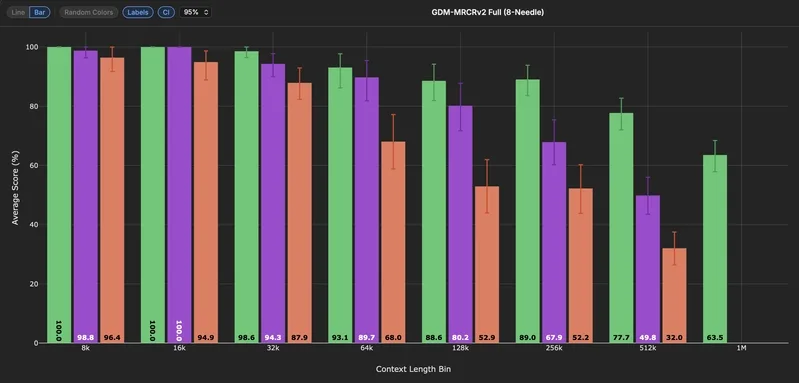
在大语言模型宣传中,“百万上下文”成为常见炫技,但实际应用场景并非如此。Context Arena 通过“8-Needle”多头依赖测试(GDM-MRCRv2 Full)揭示了各家旗舰模型在长程逻辑链条下的真实表现,与单针测试截然不同,更接近代码库分析或复杂文档查询的真实需求。
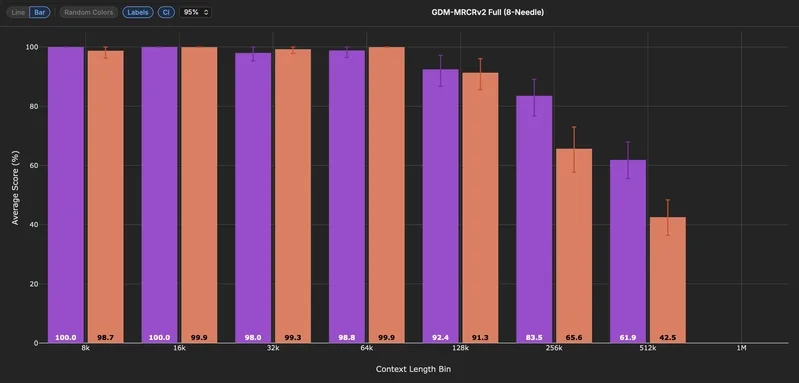
测试结果显示,GPT-5.6 Sol 和 Claude Opus 5 在 128k 以内的准确率均保持在 90% 左右,但在上下文扩展至 256k、512k 后,Opus 5 的准确率出现“断崖式下跌”,1M 时直接跌破 60%。相反,Sol 全程维持 85% 以上,1M tokens 时仍保持 82% 的准确率。这一数据直指 OpenAI 在长程依赖优化上的领先地位,而 Anthropic 则在 8-Needle 测试中表现“跑不通”,说明 1M 窗口的“百万上下文”标签在实际场景中并无意义。
另一组对比中,Gemini 3.7 Flash 在 512k 甚至 1M 处的准确率与 GPT-5.6 Sol 相当,甚至在某些情况下“反超”,但其在 OpenRouter 上的价格仅为 Sol 的 1/10。这意味着,对于需要处理整个代码库或数百份财报的工程团队,Flash 成为唯一可大规模落地且成本可控的选择。相比之下,Sonnet 5 和 GPT-5.6 Terra 的表现显著不佳,建议工程师避免考虑。
为了避免被“百万上下文”的夸大宣传误导,建议采用 Context Arena 开源的评测管线,配置如下:
benchmark: GDM-MRCRv2
variant: Full_8-Needle
context_bins: [8k, 16k, 32k, 64k, 128k, 256k, 512k, 1M]
models:
  - gpt-5.6-sol
  - claude-opus-5
  - gemini-3.7-flash
  - gpt-5.6-terra
  - claude-sonnet-5
metric: accuracy_ci95
needle_type: multi_hop_coref在选择模型架构时,先进行本地化测试,再对比成本,切勿被销售口中的“百万上下文”误导。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
1M 上下文纯属吹牛,丢进去几十万字合同居然漏掉两个核心违约项,害我通宵对了一遍。比如 Context Arena 跑的 GDM-MRCRv2 Full (8-Needle) 基准测试直接揭露了各家旗舰模型的底细,塞进 8 个相互关联的“针”,要求模型在 1M tokens 的海量数据中串联因果链条,这才是代码库分析和真实 RAG 场景的实际考验。
拿Gemini 1.5 Pro跑了200k的旧代码,这波上下文能力直接把GPT-4o给秒了,特别是在GDM-MRCRv2 Full (8-Needle)基准测试中,它能在1M tokens的海量数据中串联因果链条,这才是代码库分析的实际考验。
喂了200k代码结果它给我编了三个接口,这1M上下文纯属虚标,还得手动逐行排雷。别盯着发布会参数了,Context Arena 的
GDM-MRCRv2 Full (8-Needle)测试里,塞进 8 个相互关联的“针”串联因果链条,Opus 5 到 1M 时准确率直接跌破 60%,而 Sol 全程维持在 85% 以上。我用的这个模型八成就是那款在 256k 就开始断崖下跌的,跑不通 8-Needle 的 1M 窗口毫无意义。下次选型先拿自己的代码库跑分,别被销售嘴里的“百万上下文”带跑偏。