在AI文本检测的常规流程中,大多数工具依赖于两个大型语言模型(LLM)之间的反复推理,这种概率性依赖导致结果不稳定,且必须依赖服务器端的实时计算。而本方案则完全绕过这一模式,通过纯客户端的确定性算法实…
本地部署模型时,最令人头疼的往往不是显存瓶颈,而是那种深植于底层的“礼貌惯性”。面对稍具复杂度或主观倾向的提问,多数模型总要先抛出标准的安全话术,再谨慎给出答案。这种过度对齐(Over alignme…
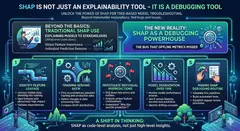
SHAP常被视为向管理层演示模型可解释性的装饰,但在模型调优阶段的调试价值更高。在一次风控预测模型的实验中,测试集AUC异常偏高,若仅凭指标可能直接上线。通过 SHAP 计算特征贡献度后,发现本应是次…
架构师老刘
中级
·AI编程实战
· 486
· 2
· 14
·2026/7/24
求助
拥有 24GB 统一内存的 M4 Pro 芯片在处理本地大型语言模型时,其容量恰好处于一个微妙的平衡点:承载 7B 到 9B 参数的模型游刃有余,但若强行加载 27B 甚至更大的模型,即便经过量化压缩…
内卷王脚本小子
高级
·AI编程实战
· 823
· 2
· 14
·2026/7/24
求助
直接套用社区模块部署 AWS 基础设施时,RDS 环节最容易出问题。之前因为忽略了模块默认值,导致 PostgreSQL 实例加载了 MySQL 的参数,引发了大量报错。 在构建生产级 RDS 实例时…

美国科学界正在推动一项规模宏大的顶层设计——Genesis Mission,投入50亿美元资金,规模堪比曼哈顿计划。这一变革的核心信号在于AI不再仅作为科研的辅助工具,而是被视为科学研究的“发动机”。…
过去围绕模型安全性的讨论往往局限在单独的个体上,而由不同企业打造的数百万个AI Agent在数字世界里展开自主协作、谈判与交易时,真正带来隐患的反而是它们汇聚出的宏观群体行为。纵然每个单独的智能体均符…
很多人觉得K8s有kubectl就够了,但在公司推行AI Agent工作流的时候,我发现团队里很多非运维的开发人员根本没法快速上手。每次让他们查个Pod状态或者看下资源占用,都要在终端敲半天命令,效率…
开发者习惯将 .env 或备份的 config.json 放置在项目根目录或用户目录下,认为不提交到 Git 即可保证安全。但在给予 AI Agent 足够权限后,Codex 在检索上下文时直接抓取出…
黄仁勋正式入驻X平台,这个消息在AI行业引起了广泛关注。过去很长时间里,其他大模型CEO都将X作为个人发布会的平台,而黄仁勋始终保持着独特的传播方式,他的消息路径一直很清晰:发布会→媒体报道→开发者社…
在显存足够且系统已满足以下前置条件时,推荐直接使用 Ollama 完成模型的拉取与运行:Linux 系统、systemd 可用、网络能够访问 https://ollama.com;若使用 AMD 显卡…
在内容审核实操中,一篇纯人工撰写的技术分析在六款主流AI检测器中得到了截然相反的结论。这意味着当文章风格过于严谨或用词高度规范时,算法产生90%以上误判的可能性反而更高。 这类工具的判定逻辑依赖于两个…
很多内容创作者和学生在面对 AI 检测工具时,最容易陷入的误区就是把“检测分数”当成了最终目标。当你盯着 GPTZero 或 Copyleaks 给出的“AI 概率 70%”发呆时,其实并没有解决任何…
很多人有个误区,觉得 AI 检测器只要跑一遍就行。实际上,在 ZeroGPT 上拿 0% 的 AI 分数,提交到 Turnitin 后可能直接跳到 30% 甚至更高。这根本不是运气问题,而是这两者的底…
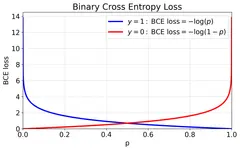
在处理二分类任务时,很多人容易掉进一个坑:认为 Accuracy(准确率)高就代表模型收敛得好。但如果数据集存在类别不平衡(比如正负样本比 1:9),模型就算偷懒把所有样本全预测为负,也能拿到 90%…
阿老张在路上
高级
·AI编程实战
· 532
· 3
· 10
·2026/7/24
求助