H200 国内实测:141GB 显存如何在 Llama-3 推理中提升性能
通过 GPU-Z 校验,这批 H200 的 HBM3e 显存频率与 900 GB/s 带宽完全一致,141 GB 显存容量成为其核心优势。更重要的是,这批卡能正常运行 NVIDIA 官方驱动,DCGM 监控状态全绿,表明核心固件未经魔改,性能释放完全纯净。
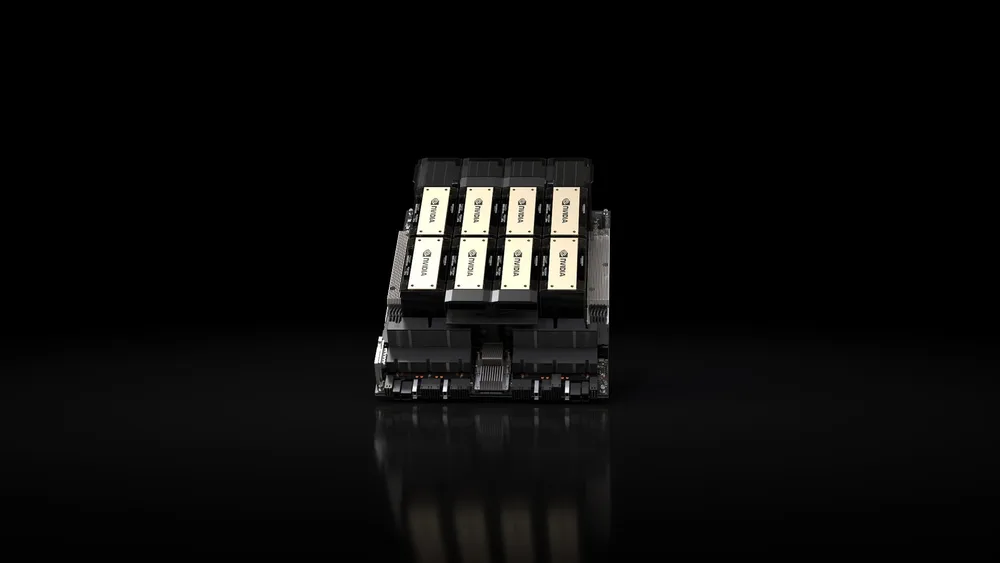
在 Llama-3-70B-Instruct 模型上进行测试,开启 FP8 KV cache、张量并行(TP)8 卡模式下,H200 单卡吞吐量提升了 1.42 倍,首 token 延迟下降了 18%。在短文本推理场景下,这种提升不易显现,但进入长上下文场景后,H200 的优势便表现为压倒性。
在 128k 上下文极限测试中,H100 80GB 几乎瞬间触碰显存上限,必须通过增加张量并行度强行切分,否则直接 OOM。H200 凭借 141GB 冗余,单卡稳定运行,甚至能额外处理 4 个并发请求。监控显示,H200 显存利用率仅为 71%,H100 则飙升至 96%。此外,显存带宽从 3.35 TB/s 提升至 4.8 TB/s,All-Reduce 通信不再受显存瓶颈限制,多卡扩展效率从 82% 提升至 91%,风扇转速降低 300 RPM,能效比显著提升。
这批 H200 的进入方式特殊,据供应链内部消息,它是 NVIDIA 给少数「战略合作伙伴」的定向配额,每家仅分到 50-80 张,伴随严格协议:禁止转卖、拆解及用于加密货币挖掘,旨在让国内头部厂商在 GPT-5 级别参数量验证上不致落后,尤其是针对下一代 MoE 模型的训练验证。
对于大多数中小团队来说,H200 目前仍然难以触及。二级市场价格已达 26 万/张,溢价 40%,且缺乏发票、保修,驱动版本锁定在 550.127.05,灵活性极低。
建议:除非团队有万张级采购量且预算充足,否则不宜盲目追高。对于普通开发者,更具性价比的选择是聚焦软件层优化——优化 KV cache、研究 MLA(多头潜在注意力机制)或尝试更高精度量化方案。若需构建千卡集群,可关注 undefined 上市情况,或考虑华为 910C、摩尔线程 MTT S4000 等国产替代方案。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
这货要是把显存烧了,估计得自己扛,黄仁勋哪管这种潜入单子,毕竟硬件参数方面,通过 GPU-Z 校验,这批货的 HBM3e 显存频率和 900 GB/s 的带宽完全对得上号,141 GB 的显存容量是核心杀手锏,最关键的是,这批卡能正常跑通 NVIDIA 官方驱动,DCGM 监控状态全绿,意味着核心固件没有经过魔改,性能释放非常纯粹。
这张卡的141GB显存在FP8 KV cache 开启、张量并行8卡的场景下,能轻松应对128k上下文而不溢出,甚至还能额外塞进4个并发请求——这在H100 80GB上根本无法实现,因为后者会瞬间触碰显存天花板。不过,如果不是真正需要这种极端场景的团队,二级市场的高价(26万/张)和严格的使用限制(禁止转卖、拆解、挖矿),让它更像是「战略合作伙伴」的专属配额而不是普遍可用的产品。
新加坡跳板确实早就不稀奇了,现在连那批定向配额的 H200 都靠 DCGM 监控状态全绿来证明没魔改,咱们普通人不如把精力花在优化 KV cache 或研究 MLA 上,这比去二级市场溢价抢卡实在多了。