用 SFT 和 RL 激活 Gemini 对突尼斯民间诗歌的捕捉能力
面对阿拉伯语这类多方言语言,大模型的表现往往呈现出一种极端的“两极分化”。绝大多数模型在处理阿拉伯语时,实际上是被现代标准语(MSA)和古典诗歌所统治的。像突尼斯民间诗歌这种带有浓厚地方色彩、语料极小众的文学传统,在预训练阶段几乎是不可见的。这意味着即便像 Gemini 这样参数量巨大的模型,在面对这种冷门文化时,本质上是在靠概率猜测或者生搬硬套标准语来“模拟”方言,结果往往是缺乏灵魂的翻译腔。
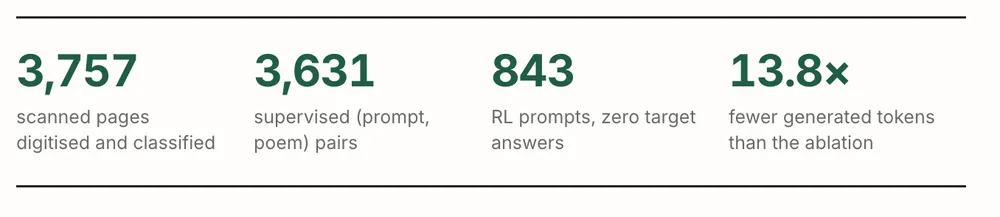
为了验证这种文化碎片能否被“激活”,我尝试通过监督微调(SFT)和强化学习(RL)给模型补课。这次实验的核心逻辑不是让模型学习一种新语言,而是在已有的语言能力基础上,通过精准的对齐,强行将模型从标准语的舒适区拉到突尼斯民间文学的特定语境中。
第一步是构建 SFT 种子数据集。由于这种诗歌的韵律和意境极难通过 Prompt 描述清楚,我准备了几百组高质量的对照组,包含原作及其详细的语言学分析。我将数据严格组织为 JSON 结构,例如:{"instruction": "请将这段现代突尼斯语口语转化为传统的民间诗歌格式,并保持特定的韵律。", "input": "今天的天气很糟糕,人们在街上抱怨。", "output": "[符合突尼斯民间诗歌格律的特定文本]"}。通过这批精准的 SFT 数据,Gemini 首先建立起一种初步的映射关系,意识到这种特定风格的存在,从而解决了“不知道怎么写”的问题。
然而,单纯依赖 SFT 很容易导致模型陷入过拟合,写出来的东西虽然格式对了,但极其死板,缺乏文学上的灵动感。于是我引入了强化学习(RL)的闭环,设计了一个专门的奖励模型(Reward Model)来对输出结果进行打分。
在这个奖励模型中,我设定了两个极其严格的维度:一是韵律校验,如果结尾词不符合突尼斯民间诗歌的押韵规律,直接判定为低分;二是文化一致性,这是一个关键的“去噪”过程,只要模型在输出中混入了不属于该地区的古典阿拉伯语词汇,就会被扣分。这种机制强迫模型在生成过程中舍弃那些“正确但违和”的标准语词汇,转而寻找更地道的方言表达。
在 Agent 平台上跑了几个迭代 Cycle 之后,效果出现了质的变化。Gemini 生成的诗句开始褪去那种刻意的“书卷气”,展现出一种泥土气息。最令人惊喜的细节是,模型开始能够自主识别出某些特定意象在突尼斯文化中的隐喻,而不是简单的词对词翻译。
这次实操证明,即便是在预训练阶段被忽略的文化碎片,只要有足够垂直的专家数据支撑,通过“SFT 建立认知 → RL 细化风格”的链路,依然可以通过轻量级的后训练将其激活。对于那些希望让模型处理极小众领域或方言的开发者来说,这种构建反馈循环的思路比单纯堆砌 Prompt 要高效得多。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
SFT 喂了几条才开始出效果?想知道这个数据量级,我也想试下
只要数据集够精,没必要堆量,快告诉我你用几条样本跑通的?