别被 A100 吓跑,单卡 4090 也能微调 7B 模型的实操指南
很多人在尝试微调大模型(LLM)之前,最焦虑的就是显存。网上很多讨论动辄就是“A100 80G 起步”,这种说法虽然没错,但它指的是数据中心级别的全参数微调标准,对于绝大多数开发者和个人玩家来说,这完全是过度配置。实际上,微调 LLM 到底吃多少显存,并不取决于模型大小这一个维度,而在于你选择的“训练方案”。
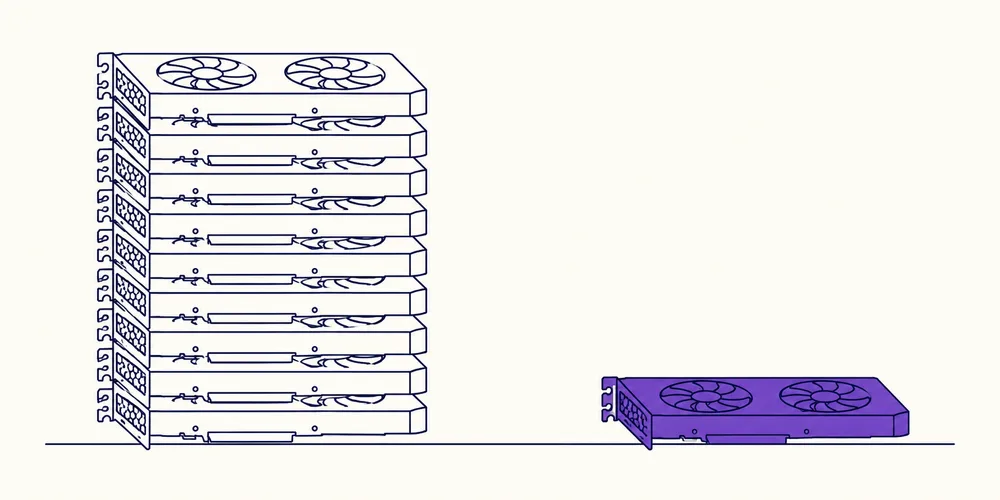
我们可以把模型大小看作骨架,而微调方法决定了你在这具骨架上需要承载多少额外的内存负担。
最硬核但也最吃资源的是全参数微调(Full Fine-tuning)。在这种模式下,显存开销是极其惊人的。以一个 7B 参数的模型为例,如果使用 FP16 精度,模型权重本身就占掉 14GB。但真正让显存爆炸的是优化器状态(Optimizer States)和梯度。如果你使用最常见的 AdamW 优化器,它需要为每个参数维护两份动量状态,这意味着优化器状态要占用 3 倍于模型权重的空间。再加上前向传播过程中产生的激活值(Activations),一个 7B 模型在全参微调时,起步显存就在 60GB 到 80GB 之间。如果你尝试 13B 模型,显存直接破百,这也就解释了为什么全参微调几乎成了 H100/A100 的专属领地。
对于平民玩家,LoRA(低秩自适应)和 QLoRA 才是真正的救星。LoRA 的核心逻辑是冻结原模型的所有权重,只在旁边挂两个极小的低秩矩阵进行训练。这样一来,需要更新的参数量从几十亿直接砍到了几千万。一个 7B 模型在 LoRA 模式下,显存需求能从 80GB 骤降到 20GB 左右。
而 QLoRA 则在 LoRA 的基础上更进一步,它将基座模型量化到了 4-bit(通常使用 NF4 格式)。这种操作直接把基座模型的内存占用砍掉了 75%。在实际操作中,一个 7B 模型通过 QLoRA 微调,显存占用可以压到 12GB-16GB。这意味着,一张消费级的 RTX 4090 甚至 3090 都能轻松跑起来,甚至在 32GB 内存的 MacBook 上配合 llama.cpp 也能勉强尝试。
在这里分享一个我踩过的深坑:之前尝试给 7B 模型做全参微调时,显存莫名其妙地爆掉,报错提示 OutOfMemoryError。当时我检查了 batch size 已经很小了,但忽略了优化器状态的计算。后来我尝试切换到 8-bit AdamW 优化器,并开启了梯度检查点(Gradient Checkpointing),显存占用直接下降了近一半。梯度检查点虽然会略微增加计算时间(因为它在反向传播时重新计算激活值),但它能极大地缓解显存压力。
针对不同配置的硬件,我的实操建议如下:
首先,如果你的显存只有 16GB 或更低,不要犹豫,直接上 QLoRA。记得把梯度检查点(Gradient Checkpointing)打开,并将 batch size 调到最小(比如 1 或 2),配合梯度累积(Gradient Accumulation)来模拟大 batch,这样才能跑得动。
其次,如果你拥有 24GB 显存(如 3090/4090),LoRA 是你的最佳选择。你可以在保证性能的同时,尝试稍微大一点的基座模型,或者增加序列长度(Max Sequence Length),因为你还有一定的显存冗余。
最后,只有当你拥有 48GB 以上显存(如 A6000 或多卡集群)时,才建议考虑全参数微调。即便如此,我也建议先用 LoRA 跑通基准线,因为在大多数特定任务中,LoRA 调优后的效果能达到全参微调的 95% 以上,但成本却低得惊人。
总结来说,单卡用户没必要执着于全参微调。在资源有限的情况下,通过 NF4 量化和低秩矩阵,你完全可以用极小的代价获得接近顶配的微调效果。
4090跑LoRA勉强能行,一旦尝试全参微调瞬间爆显存,心在滴血。