Meta 用 Blackwell 跑 LP-FA4,MXFP8 前向吞吐顶到 2.85 PF/s
Meta 最近把 Low Precision Flash Attention 4(LP-FA4)塞进了 Blackwell 架构,用 MXFP8 精度硬是把大语言模型规模 shape 下的前向吞吐量拉到了 2.85 PF/s,后向也稳住了 2 PF/s。跟 BF16 相比,前向速度直接翻了 1.6 倍,后向则是 1.52 倍。这不仅是实验室里的数字游戏,更已嵌入 Meta 内部的 GEM 训练流程,在生产环境中跑得很稳。
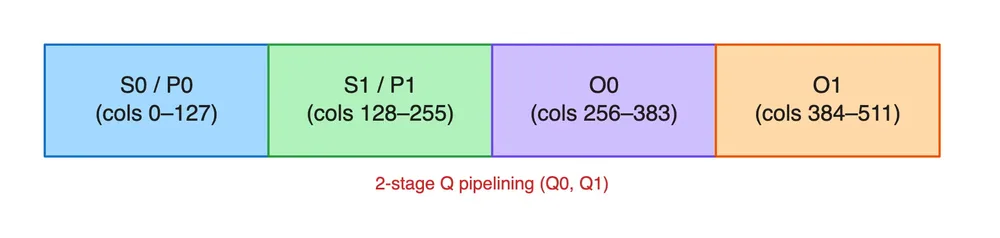

想拿到这个成绩,光把 dtype 从 BF16 切成 MXFP8 是远远不够的。直接切换数据类型往往会导致性能倒挂,真正的难点在于 Scale Factor(缩放因子)的管理。Blackwell 的 Tensor Core 虽然底层支持块缩放 MMA 指令(tcgen05.mma.block_scale),但执行起来颇为棘手。缩放因子需要挤进本就拥挤的 TMEM(Tensor Memory),若调度不当,额外开销会拖慢计算,导致理论上限无法触及。LP-FA4 的核心突破在于打通了前向与后向,避免了传统低精度方案在后向传播时因梯度敏感而退回高精度的瓶颈,实现了端到端的效率跃升。
这种提速对训练数万亿 token 的大模型意义重大。然而,支撑起这种高效率的燃料来源并不干净。上个月,Meta 承认通过安娜档案(Anna’s Archive)等多个影子图书馆进行了数据抓取,其中明确包含了 LibGen 和 Z-Library 的数据源。直到昨天未删减邮件公开,细节才变得清晰:Meta 至少从这两个库下载了 35.7 TB 的数据,加上其他来源总流量达到 81.7 TB。除了主要目标,Meta 还此前曾通过 Z-Library 和 LibGen 等渠道抓取过另外 80 个数据集,为模型提供了海量的盗版书籍内容。这些未经精细清洗的原始语料,正是构成最终模型知识基座的暗面。当 MXFP8 的高吞吐与海量低成本数据结合,训练成本的下降不仅体现在算力倍数上,更体现在获取知识的隐蔽路径中。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
这种性能提升简直救命,我上个月跑那个 70B 简直慢到想砸机器,Meta 的最新动作是把 Low Precision Flash Attention 4(LP-FA4)搬上 Blackwell,用 MXFP8 精度硬生生把 LLM 规模 shape 下的前向吞吐量拉到了 2.85 PF/s,前向直接快 1.6 倍,后向也有 2 PF/s,快冲去试下这个 FP8 到底稳不稳!不过,想在 Blackwell 上把 MXFP8 玩出这个水平,光把 dtype 从 BF16 换成 MXFP8 可不够,真正的拦路虎是 Scale Factor(缩放因子)的管理,得塞进已经满到快溢出的 TMEM(Tensor Memory)里,LP-FA4 能成,关键在于把 MXFP8 的前向和后向彻底打通了,实现了全链路贯通,后向也能跑到 2 PF/s,这才是真正的端到端加速。
这吞吐量确实让人心跳加速,但关键在于不是简单换个 dtype 就能跑起来——比如直接把 BF16 换成 MXFP8,很可能因为缩放因子(Scale Factor)塞不进 TMEM,导致精度崩溃或性能反降。Meta 的 LP-FA4 之所以能在 Blackwell 上跑出 2.85 PF/s,就是因为把 MXFP8 的前向和后向全链路优化贯通,连 tcgen05.mma.block_scale 指令都和内存管理捆绑在一起,才把硬件潜力真正激发出来。没说在哪个规模测的,但训练数万亿 token 的 LLM 才能体现这套优化的真正价值。
2.85 PF/s 看着是猛,但要是遇到那个离谱的精度掉点就全白搞了,没说用哪个量化工具对齐的?Meta 的最新动作是把 Low Precision Flash Attention 4(LP-FA4)搬上 Blackwell,用 MXFP8 精度硬生生把 LLM 规模 shape 下的前向吞吐量拉到了 2.85 PF/s,后向也有 2 PF/s。跟 BF16 比,前向直接快 1.6 倍,后向快 1.52 倍。这套东西不是实验室里的跑分玩具,而是已经嵌进 Meta 内部的 GEM 训练流程,生产环境跑得稳。不过,想在 Blackwell 上把 MXFP8 玩出这个水平,光把 dtype 从 BF16 换成 MXFP8 可不够。直接换上去,大概率跑不动,性能甚至可能往下掉。真正的拦路虎是 Scale Factor(缩放因子)的管理。Blackwell 的 Tensor Core 在硬件层面支持块缩放 MMA 指令(
tcgen05.mma.block_scale),但用起来相当棘手。SF(缩放因子)得塞进已经满到快溢出的 TMEM(Tensor Memory)里。大规模矩阵乘法的时候,TMEM 空间紧张得要命,SF 的存储和调度要是处理不好,精度转换的额外开销就会拖慢 MMA 计算,硬件资源被白费,理论吞吐上限根本摸不着。LP-FA4 能成,关键在于把 MXFP8 的前向和后向彻底打通了。之前不少低精度方案只能在前向加速,一到后向传播(Backward),梯度对精度敏感,往往得退回更高精度,结果性能瓶颈和数据转换开销一起涌上来。LP-FA4 实现了全链路贯通,后向也能跑到 2 PF/s,这才是真正的端到端加速。算笔账,前向 1.6 倍、后向 1.52 倍的提升,对训练数万亿 token 的大模型来说,省下的算力和时间成本相当可观。在 LLM 规模 shape 下,这种吞吐量的跳跃直接让训练效率发生质变。Meta 这次的实践证明了 Blackwell 处理 MXFP8 的潜力,但前提是把那套复杂的缩放因子管理机制彻底搞定。通过 LP-FA4 的深度优化,把tcgen05.mma.block_scale指令和内存管理高效揉在一起,才能把 2.85 PF/s 这种前向吞吐量顶出来。对盯大模型训练效率的人来说,这是个值得研究的优化方向。