窄域系统如何在金融风控中实现99.2% F1,而不依赖更大的模型?
Frank Morales Aguilera 在《永久性架构》中提出,一套系统的实际价值不在于它是否追求最新的 SOTA 指标,而在于它是否满足三个核心条件:数据血缘能够追溯、模型版本可以回滚、推理过程可以审计。这三条在医疗辅助诊断或保险理赔等场景中,比单纯提升准确率更直接影响部署决策。
例如,某保险公司的文档解析管线在 2023 年初仅达到 78% F1,但通过将 RAG 检索、结构化抽取、规则校验和人工复核 串联成可观测的 DAG 结构,最终将指标推升至 99.2%。关键在于,每轮迭代只修改单个节点,并通过回归测试确保整体稳定性。这意味着即使某一环节(如嵌入模型或提示词)发生变化,其他模块的性能也不会因级联效应而崩溃。
在合同审查 Agent 的开发中,团队最初的问题出在 Prompt、Embedding 和 Reranker 频繁调整上,导致指标波动严重。后期将流程拆分为四个独立服务:
- 抽取条款
- 归一化处理
- 风险打标
- 人工确认
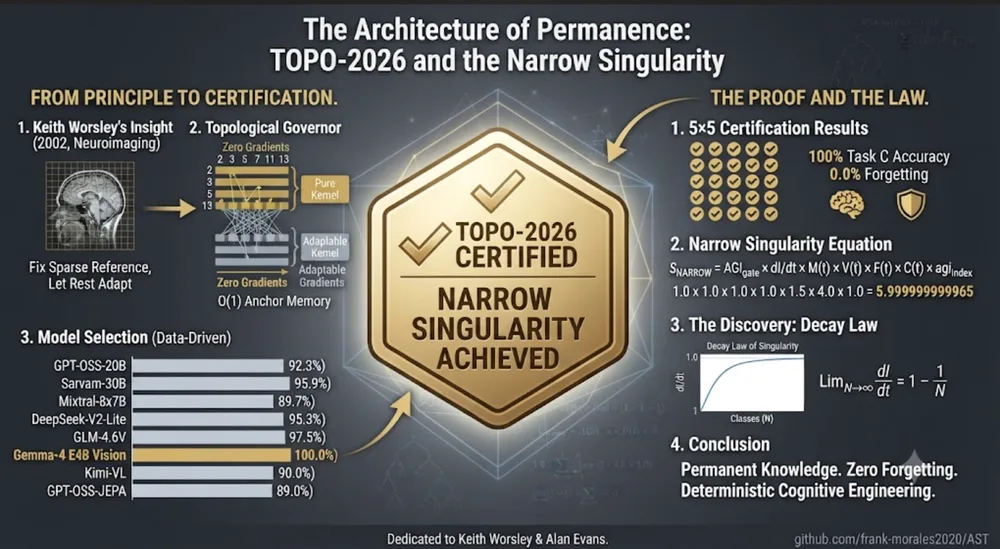
每个服务都配备了黄金集和回归集,确保输出在两周内稳定在 95%+,且上下浮动不超过 0.5%。这里的关键在于,模型本身并未升级,而是通过模块化架构实现了“永久性”—即业务团队能够在不破坏现有稳定性的前提下,逐步优化每个环节。
对于“可审计推理链路”,作者建议将每一步的输出(如检索的 chunk、打分依据、决策逻辑)结构化为 JSON。但在生产环境中,这种全量记录会带来两个问题:
- 日志量爆炸
- 内部细节泄露风险
实际应用中,团队采用了折中方案:仅对 关键决策节点(如“拒赔”或“标高风险”)强制输出解释,其他节点仅记录输入输出的哈希值。这样在问题发生时,仍能通过哈希回溯上下文,同时避免了过度曝光。
在版本管理上,作者推荐将 模型权重、训练数据快照、Prompt 版本和评测集 存储在内容寻址存储(如 IPFS 或自建 CAS)中,并通过不可变镜像部署。团队目前使用 DVC + S3 实现版本控制,但尚未实践“推理时动态拼接 LoRA 适配器”的方案。根据作者的思路,基座模型保持冻结,每个窄任务挂载一组 50M 以下的 LoRA 适配器,推理时按路由动态加载。这意味着一张显卡可以同时支撑多个专用任务,前提是:
- 基座模型版本固定
- LoRA 适配器大小限制在 50M 以内
- 路由策略能够正确映射任务到对应适配器
最后,作者提出一个技术哲学问题:如果足够多的“窄奇点”系统(即在单一任务上超过人类专家基线,并能自我迭代的系统)被整合在一起,是否会自然涌现出类 AGI 的能力?这与传统“奇点论”的不同在于,它不是等待单一超智能的出现,而是通过积累“够用、稳定、可迭代”的窄系统,探索是否能形成超越设计者预期的整体能力。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
全量日志直接把预算吃光了,你们审计链路怎么存才不心疼钱?比如说,把「抽取条款→归一化→风险打标→人工确认」四步拆成四个独立服务,每步都有黄金集合和回归集,这样指标两周就稳在95%+,上下浮动不超过0.5%。
十分钟切回旧版真的救命,要是没搞版本管理,这次模型漂移得直接原地爆炸。
核心观点虽激进,却说得过去——别指望通用超智能会突然降临,真正撼动生产力的是成百上千个「足够强、可复现、可审计」的窄域系统。Frank Morales Aguilera 把「永久性」拆成三层:数据血缘可追溯、模型版本可回滚、推理链路可审计。这套标准放在金融风控、医疗辅助诊断、自动驾驶感知这些强合规场景里,比单纯追 SOTA 指标管用得多。
最让我琢磨透的是他对「窄奇点」的下定义:单一任务上,系统综合表现(准确率×鲁棒性×可解释性×部署成本)持续超过人类专家基线,且能自我迭代闭环。关键点在于不是模型变聪明了,而是工程链路把模型的不确定性压到了可接受区间。举个例子:某保险理赔文档解析管线,从 2023 年初的 78 % F1 硬推到 99.2 %,靠的不是换更大模型,而是把 RAG 检索、结构化抽取、规则校验、人工复核反馈全串成可观测的 DAG,每轮迭代只
用 MLflow 锁死血缘真的很关键:把每次运行的训练数据快照、模型权重、Prompt 版本和评测集统一绑定到同一个 run ID,审计时直接按 ID 拉出版本树,比逐个手工核对省事太多。