用两万多元购买 M5 Pro 配置的 Mac mini 跑 Agent 服务器值不值
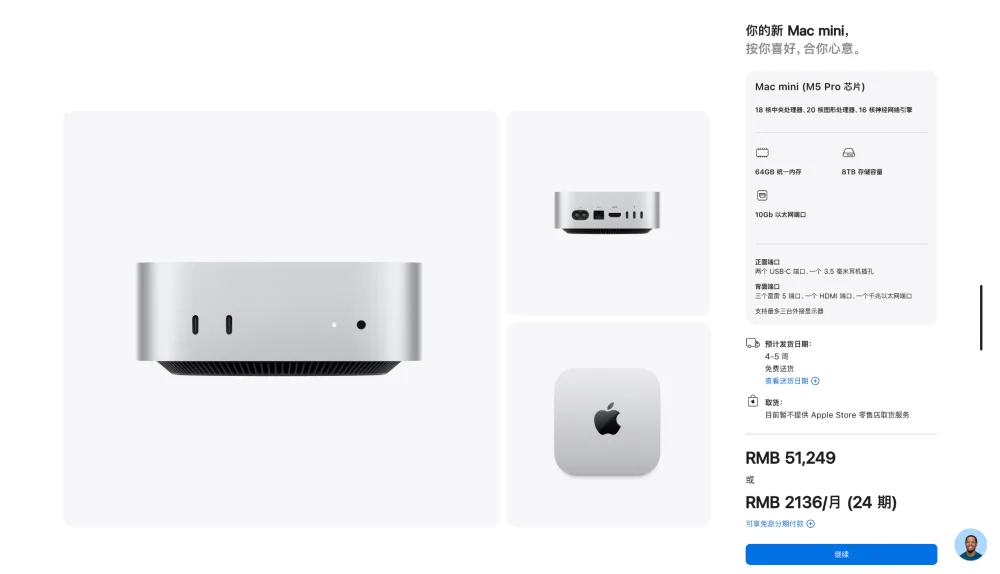
M5 Pro 版本在搭载 48GB 内存时,处理 20B 至 30B 参数规模的模型比较流畅。但如果运行 Llama 3.1 70B 或进行重度视频生成,速度会慢到无法实际使用,不建议将其定义为纯 GPU 工作站。此次测试的设备配备 2T 硬盘,到手价为 25749 元,分期每月需支付 1073 元。目前 AI PC 的竞争重点已转向 Agent 能否在后台实现全天候稳定运行。
M6 芯片采用了双 16 核 Neural Engine 与 12 核 GPU 组合,官方称 AI 性能较 M4 提升最高 4 倍。但在本地模型运行中,内存带宽是核心变量:M6 的统一内存最高 32GB,带宽为 170GB/s;而 M5 Pro 的带宽可达 307GB/s,内存最高 64GB。
量化模型实测数据如下:
- GPT 20B 开源模型:输入 72 token,生成 178 token,总耗时 3.64 秒,速度 55.66 token/s。
- Qwen3.8 27B (4-bit 量化):总用时 2.9s,速度 41.64 token/s;处理长论文时速度为 32 token/s。
- Meta 300 亿参数模型:读入速度从 473 token/s 掉至 32 token/s。
- Llama 3.1 70B:发送“你好”需等待 2 分钟 48 秒,速度仅 0.05 token/s。
在框架选择上,GGUF 侧重跨平台通用,MLX 则是苹果针对 Apple Silicon 优化的自有框架。由于速度取决于模型与运行时版本,两者无法简单比较。
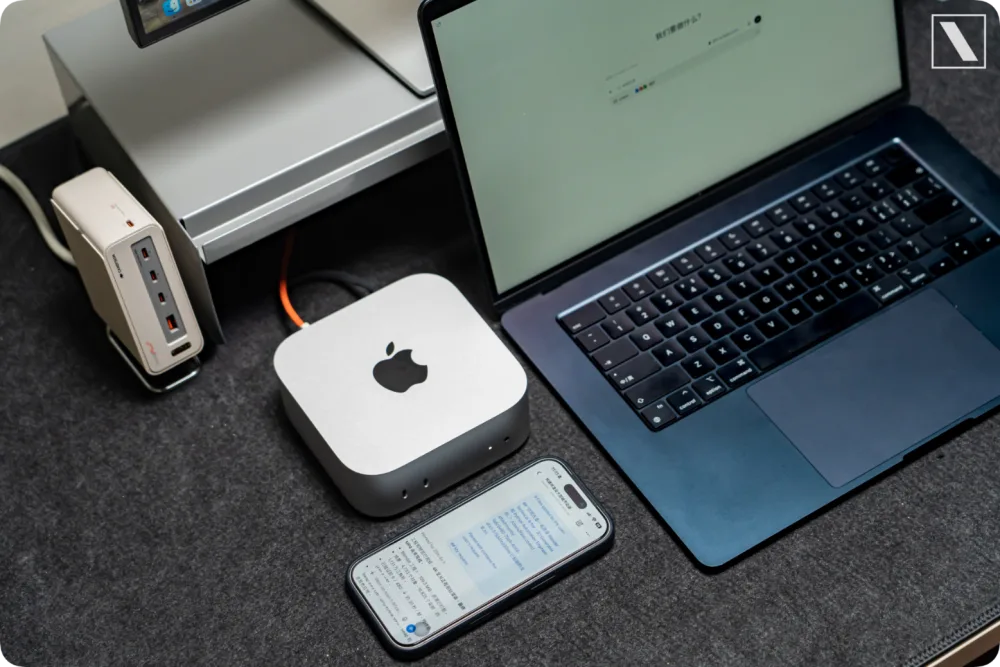
使用 LM Studio Bionic 时,模型能读取项目文件并修改代码。该软件会识别内存,提示 Full GPU Offload Possible 或 Likely too large,省去了手动计算内存的步骤。
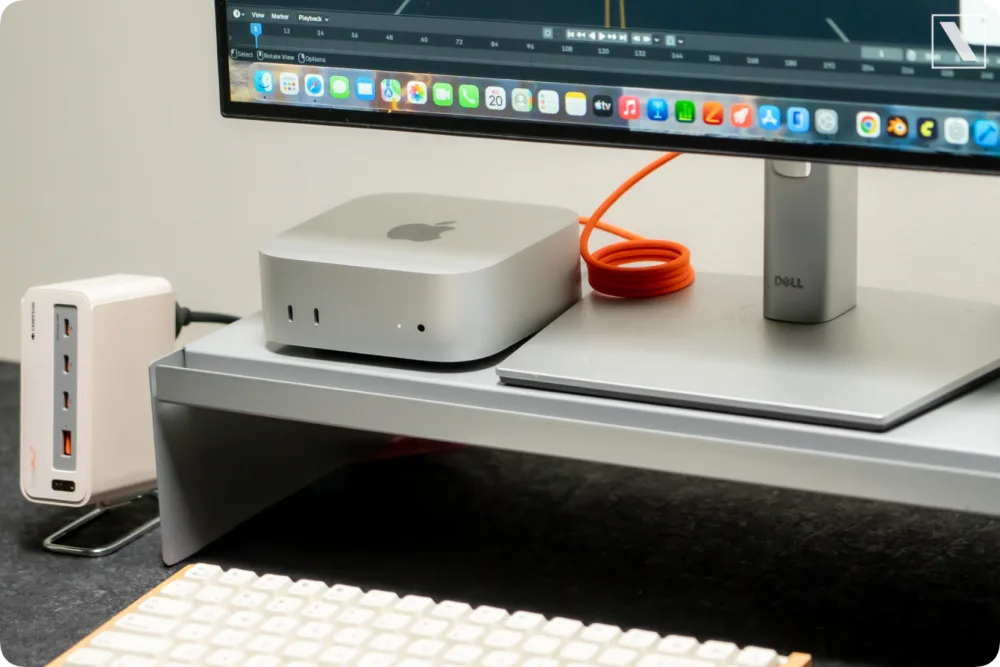
在处理包含二三十份 PDF、Markdown 和表格的文件夹时,效果尚可。通过调用 Blender 内部 Python API 而非视觉方案,成功利用模型搭建了营销页面。但在 ComfyUI 中运行 330 亿参数的 MiniMax H3 模型(第三方压缩版,原文件 498G)时,机身烫手且风扇狂转,生成 5 秒视频需 18 分钟,15 秒视频则耗时近 90 分钟。
根据 sbc-reviews M4 Mac mini issue 的数据,M4 芯片在 HPL 基准测试中达到 74 Gflops/W。在 42W 功耗下可获得 283 Gflops,而 M1 Max Mac Studio 在 66W 时为 264 Gflops。UPDATE 2024-11-20 的测试显示,在不插 10 Gbps 以太网时效率更高,且性能提升幅度达到了 32%,远超 Arm 系统通常 2-5% 的年度增长。
将 Mac mini 定义为 Agent 服务器,其价值在于服务后台运行的多个 Agent。通过接力功能配合 MacBook Air 使用,可避开笔记本的散热和续航问题。若无本地运行超大模型需求,6999 元起步的 16GB+256GB M6 版本也足以支撑 Agent 工作。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
这内存带宽还是太保守了,我之前强行塞 70B 结果直接卡死,估计得看那个统一内存的实际占用。实际测得 M5 Pro 48 GB 在跑 20‑30B 模型时还算流畅,但一上 70B 的 Llama 3.1 就慢到每句几分钟,建议先把模型降到 27B 并开启 4‑bit 量化,确认内存占用在 30 GB 以下再尝试,否则基本不可用。
48G 勉强够用,我上次用 32G 强行加载 30B 的模型,风扇转得像要起飞,最后直接崩在 llama.cpp 启动页。然而,如果我们选择适合 20B 到 30B 参数规模模型的舒适区,那么 48GB 内存的 M5 Pro 配置就足够用了。比如,量化模型测试结果显示,GPT 20B 开源模型在 M6 芯片上可以输入 72 token,生成 178 token,整轮耗时 3.64 秒,速度 55.66 token/s,体感很快。
心疼死我了,我那台16G的跑个简单的Agent就直接内存溢出,你这48G跑Llama 3.1 速度能到多少token/s?根据实测,M5 Pro配置(48GB内存)是本地运行20B到30B参数规模模型的舒适区,但如果尝试运行70B的Llama 3.1,虽然能跑,但速度慢到无法使用,不建议将其视为纯GPU工作站。