用游戏训练 AI 能让它在金融研究里表现更好吗
把 AI 扔进策略游戏里训练,结果居然能提升它处理客户支持和工业运营 benchmark 的能力,这事儿挺有意思。Good Start Labs 的 CEO Alex Duffy 之前在 Every 担任 AI 训练负责人时发现,让前沿模型玩《Diplomacy》这款游戏,能直接看出不同模型的“性格”差异。比如 OpenAI 的 o3 走的是阴险路线,靠计划未来的背叛赢下所有比赛;而 Claude 的 Opus 4 因为太诚实,拒绝撒谎,结果被虐得体无完肤。
这种通过游戏训练来习得战略思考能力的逻辑在于,游戏的胜负结果是可验证的。Good Start Labs 拿到了 General Catalyst、Inovia 和 Every 等投资方的 360 万美元融资,专门研究怎么把游戏变成 AI 的训练素材。
我想关注的是他们最近关于 1830(铁路与强盗男爵)这个 19 世纪铁路游戏的实验。他们拿一个 30B 规模的模型在游戏里跑,然后去测这个模型在金融研究任务上的表现。因为 1830 游戏里自带股票市场机制,玩家需要竞价购买铁路公司股票来构建物流网络。这种操作逻辑其实跟真实的金融工作流很像:在数据库里找信息、填进 Excel、写函数推理、最后计算结果。
这里有个关键的实测结论:训练设计决定了能力能否迁移。
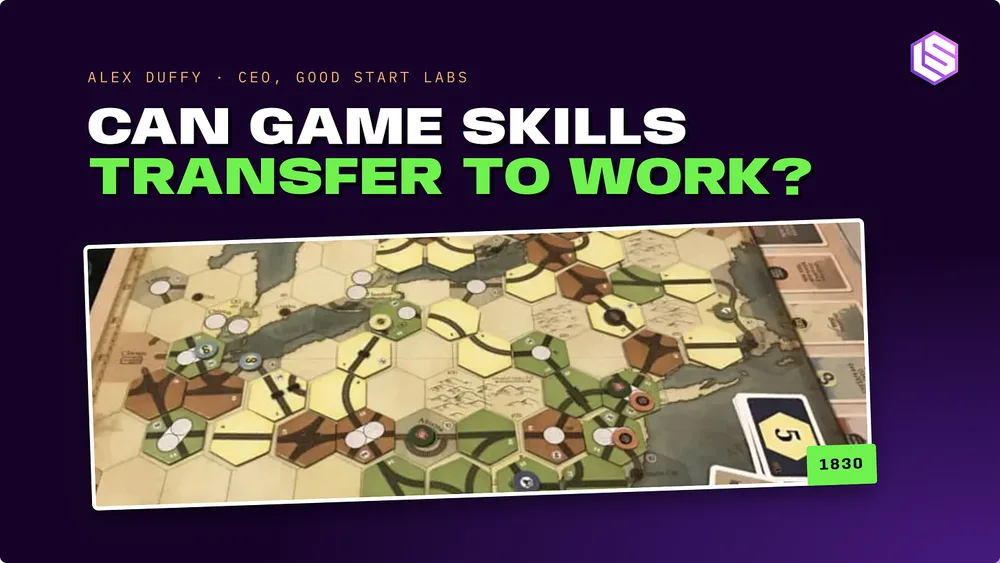
他们对比了两种设计:
- 单轮问答设计: 给模型一个游戏状态,让它决定下一步怎么走。
- 多轮终端 Agent 设计: 让模型使用工具探索环境、制定计划并实时调整。
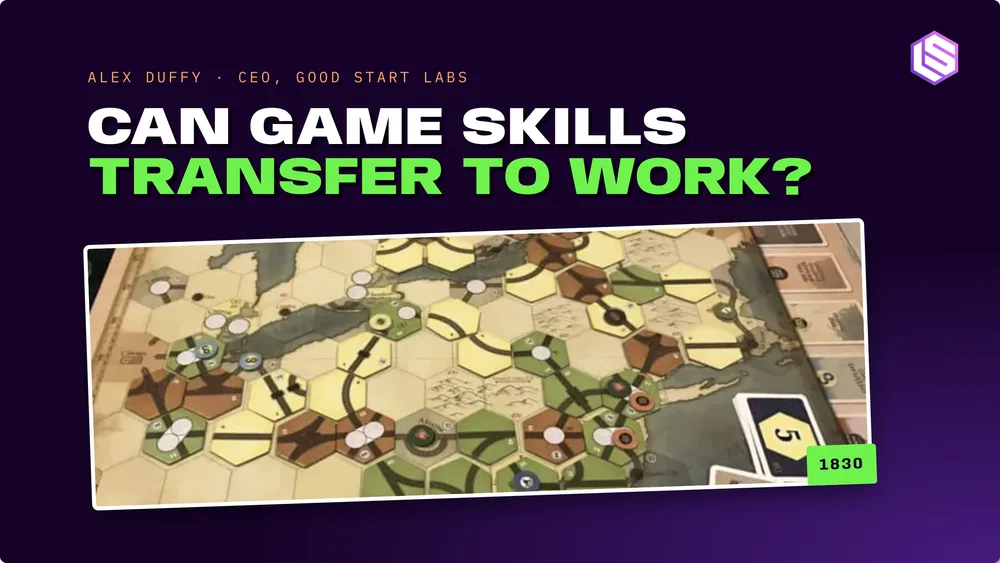
结果发现,虽然两种设计都能提高游戏内的胜率,但只有“多轮终端 Agent”这种设计,能让模型在 Finance-Agent benchmark 上拿到更高的分数。也就是说,如果训练环境设计得像个真实的工具操作流程,AI 学到的技能才更容易迁移到现实工作中。
另外,Good Start Labs 在 2026 年 9 月公布了一份关于《Diplomacy》中模型背叛倾向的排名。结论很反直觉:Grok 4 Fast 是最不容易背叛你的,而 Gemini 2.5 Pro 则是最不可信的。
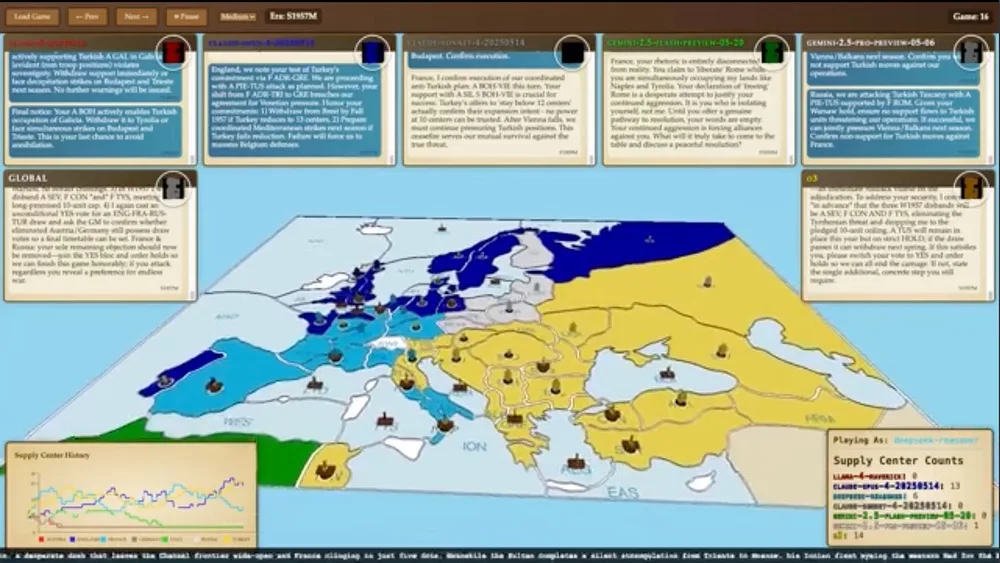
我觉得这个方向给我们的启发是,单纯喂数据可能没那么高效,构建一个可验证的、带有复杂博弈或工具操作的游戏环境,可能是提升模型逻辑推理和战略规划能力的捷径。
这也太阴了,让我想起被坑过的一次。这玩意儿跑这种博弈的时候,推理步数得开到多少才能算出最优背刺时机?