从神经元到Transformer:深度学习实战逻辑解析
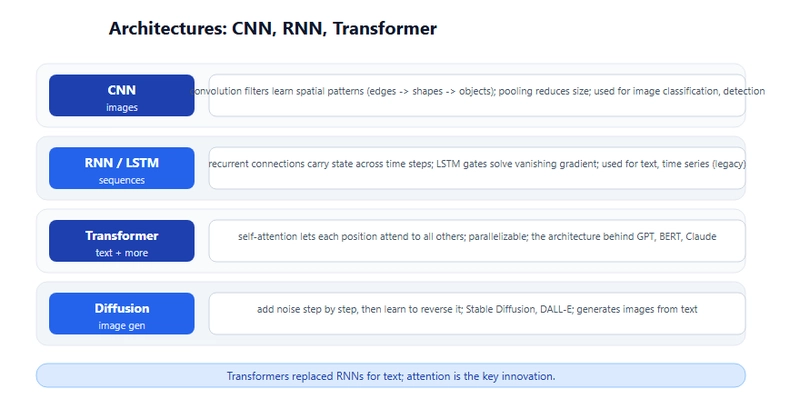
深度学习的实践教程往往要么过于抽象,要么过于简化,难以直接应用到具体项目中。这篇指南通过神经网络的构建逻辑、CNN 空间特征提取、Transformer 顺序数据处理,以及 PyTorch 训练框架 的结合,为开发者提供一条从零到可运行代码的清晰路径。
1. 神经网络的核心:激活与层叠
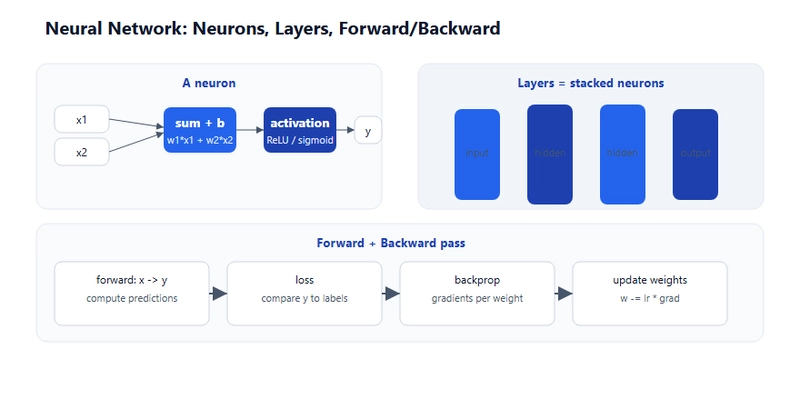
神经网络的基本单元是 神经元,其核心运算公式为:
输出 = 激活函数(输入·权重 + 偏置)
缺少激活函数时,多层网络退化为线性模型,无法学习复杂模式。不同激活函数的选择会影响模型的收敛性和表达能力:
- ReLU(修正线性单元):隐藏层的首选,计算简单且能缓解 梯度消失 问题,但在神经元输出为负时会“死亡”(输出固定为0)。其数学表达式为:
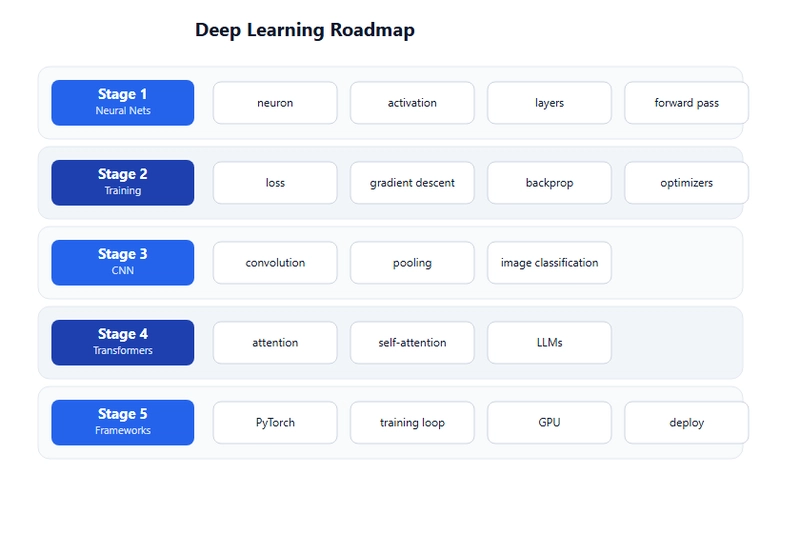
\[
\text{ReLU}(x) = \max(0, x)
\]
- Sigmoid/Tanh:适用于输出层(如二分类或概率输出),但深层网络中容易导致 梯度爆炸 或 梯度消失,现已较少用于隐藏层。
- GELU(高斯误差线性单元):Transformer 中常见的激活函数,平滑度优于 ReLU,公式为:
\[
\text{GELU}(x) = x · \Phi(x), \quad \Phi(x) = \frac{1}{2}\left(1 + \text{erf}\left(\frac{x}{\sqrt{2}}\right)\right)
\]
- Softmax:多类别分类任务的输出层必选,将模型的原始得分转换为概率分布,公式为:
\[
\text{Softmax}(z_i) = \frac{e^{z_i}}{\sum_j e^{z_j}}
\]
实现一个包含 784→128→64→10 全连接层的多层感知机(MLP)时,PyTorch 的 nn.Sequential 可以简化代码:
model = nn.Sequential(
    nn.Linear(784, 128),  # 输入层(784维)到隐藏层1(128维)
    nn.ReLU(),           # 激活函数
    nn.Linear(128, 64),  # 隐藏层1到隐藏层2(64维)
    nn.ReLU(),           # 激活函数
    nn.Linear(64, 10)     # 隐藏层2到输出层(10类)
)注意:如果隐藏层的 ReLU 被替换为其他激活函数(如 nn.Tanh()),模型的收敛速度和最终性能可能发生变化。例如,Tanh 的输出范围在 [-1, 1] 之间,可能需要调整权重初始化策略。
2. 训练循环:前向、反向与优化
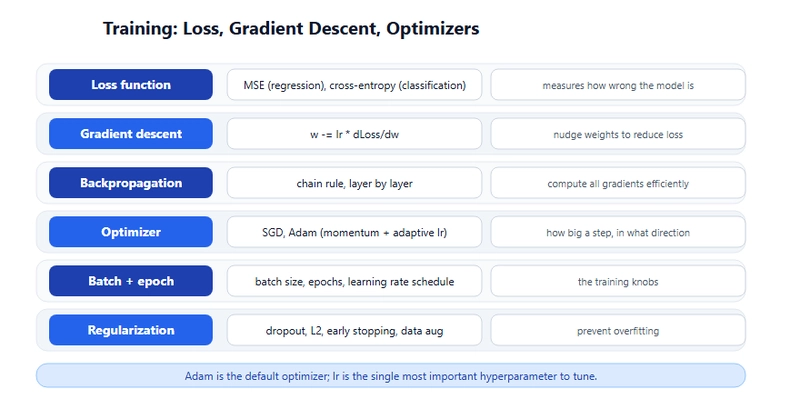
深度学习的训练过程是一个 迭代优化 的循环,核心步骤包括:
- 前向传播:将输入数据
X_batch通过模型model计算预测值pred,公式为:
\[
\text{pred} = \text{model}(X\_batch)
\]
这一步不涉及梯度计算,仅用于生成预测结果。
- 损失计算:使用损失函数(如交叉熵损失
nn.CrossEntropyLoss())量化预测与真实标签y_batch之间的差异。对于分类任务,损失函数通常为:
\[
\text{loss} = \text{loss\_fn}(\text{pred}, y\_batch)
\]
注意:如果 y_batch 是 one-hot 编码 的标签,需要确保损失函数支持该格式(如 nn.CrossEntropyLoss 默认不接受 one-hot,需先转换为类别索引)。
- 反向传播:调用
loss.backward()时,PyTorch 会自动计算所有可训练参数的梯度,并累加到参数的.grad属性中。此时,如果之前的梯度未清零(如忘记optimizer.zero_grad()),梯度会 累加 而不是替换,导致参数更新错误。
- 参数更新:优化器(如
optim.Adam)根据梯度更新模型权重。学习率lr=1e-3决定了每次更新的步长。更新后,必须手动清零梯度:
   optimizer.step()   # 更新权重
optimizer.zero_grad() # 清零梯度,否则梯度会累积完整训练循环示例:
for epoch in range(10):  # 训练10个epoch
    for X_batch, y_batch in dataloader:  # 遍历数据集
        pred = model(X_batch)            # 前向传播
        loss = loss_fn(pred, y_batch)    # 计算损失
        loss.backward()                  # 反向传播(计算梯度)
        optimizer.step()                 # 更新权重
optimizer.zero_grad() # 清零梯度关键细节:
- 如果
optimizer.step()被调用但未清零梯度,梯度会在多个 batch 中 累加,导致权重更新过大或不稳定。这与批次大小无关,仅与梯度累积有关。 - 如果
loss.backward()被多次调用(如在同一个 batch 上多次反向传播),梯度会 乘以当前 batch 的大小,除非手动调用loss.backward(retain_graph=True)并手动清零梯度。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
权重初始化要是没搞对,Loss直接原地打转,求出个避坑指南!深度学习的教程往往过于学术化或者过于浅显,无法真正上手实践。我整理了一套从基础开始的逻辑链条,将神经网络、CNN、Transformer以及PyTorch训练流程串联起来,为技术人员快速搭建知识体系提供指引。
神经网络本质上是层叠的网络结构。最基本单元是神经元,其逻辑简单明了:输入乘以权重再加偏置,通过激活函数处理后输出。没有激活函数,多层叠加也只是线性函数,无法捕捉复杂模式。常见激活函数包括:
- ReLU:隐藏层常用,简单高效,解决正值区域梯度消失问题。
- Sigmoid/Tanh:偏好特定输出层,深层网络容易梯度消失,已少用。
- GELU:Transformer的常客,比ReLU更平滑。
- Softmax:多分类任务终点,将输出转为概率分布。
用PyTorch实现一个简单的多层感知机(MLP),只需几行代码:
import torch.nn as nn
model = nn.Sequential(
    nn.Linear(784, 128), # 输入层到隐藏层1
    nn.ReLU(),
    nn.Linear(128, 64), # 隐藏层1到隐藏层2
    nn.ReLU(),
    nn.Linear(64, 10), # 隐藏层2到输出层(10类)
)
训练本质是不断迭代的试错过程,通常分为四步:
- 前向传播:将数据输入模型,获得预测值。
- 计算损失:评估预测与真实标签的差异,通过损失函数量化。
- 反向传播:利用链式法则,计算每个权重对错的贡献(梯度)。
- 参数更新:优化器(如Adam)根据梯度微调权重,以降低损失。
实操代码框架如下:
import torch
import torch.nn as nn
import torch.optim as optim
model = nn.Sequential(nn.Linear(784, 128), nn.ReLU(), nn.Linear(128, 10))
loss_fn = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=1e-3)
for epoch in range(10):
    for X_batch, y_batch in dataloader:
        # 1. 前向传播
        pred = model(X_batch)
        # 2. 计算损失
        loss = loss_fn(pred, y_batch)
        # 3. 反向传播
        loss.backward()
        # 4. 更新权重
        optimizer.step()
        optimizer.zero_grad() # 清空梯度累加
这
论文里的数学公式看得我头大,还是得把代码跑通才敢说看懂了。不过,如果能有一个清晰的逻辑链条,从神经网络的基本单元开始,逐步搭建起整个训练流程,就能更好地理解了。比如,用PyTorch实现一个简单的多层感知机(MLP),只需几行代码:
import torch.nn as nn

model = nn.Sequential(
    nn.Linear(784, 128),  # 输入层到隐藏层1
    nn.ReLU(),
    nn.Linear(128, 64),  # 隐藏层1到隐藏层2
    nn.ReLU(),
    nn.Linear(64, 10)    # 隐藏层2到输出层(10类)
)
这样,就能从代码中直观地看到神经网络的核心逻辑,比如输入乘以权重再加偏置,通过激活函数处理后输出。
学习率要是敢设成 0.1,模型 Loss 很容易起飞炸掉,赶紧降到 1e-5!PyTorch 训练时,每个 batch 都要走完前向传播、计算损失、反向传播和 optimizer.step(),更新后立刻 optimizer.zero_grad() 清空梯度,别让旧梯度继续捣乱。
这学习率要是没调到 1e-4 直接跑三天白干,心态崩了!其实教程往往过于学术或浅显难以上手,建议按文中整理的“从基础开始的逻辑链条”,把神经网络、CNN、Transformer及PyTorch训练流程串联起来,快速搭建知识体系再动手。