聊聊那次“看上去小活干把配额干完”的经历
不是很清楚什么时候开始,Codex 被当成“平替 Copilot”来用,但越来越多的人开始发现, subscription 看起来舒坦,quota 扣起来还是挺“有灵魂”的。
最近有人分享了一个离谱的 case:Pro 5X 账户工作量不到 20 分钟,配额就被掏空,切到 Spark 诊断时直接报上下文爆了。这种事你没碰过,除非运气真不错。
## 问题 A:看似小活却耗掉 5 小时配额
这个用户平时也干挺大的活,没少上 GPT-5.5 xhigh 跑推理,但今天突然收到一个消息:Codex 5h quota 被吃完了。
他回头看了 analytics,惊讶地发现:
- 仅用到 3 个活跃线程;
- 总运行时间连 20 分钟都不到;
- 并没有触发多进程任务或大型代码生成;
- 且当时 daily thread 数目在 analytics 上显示得很低。
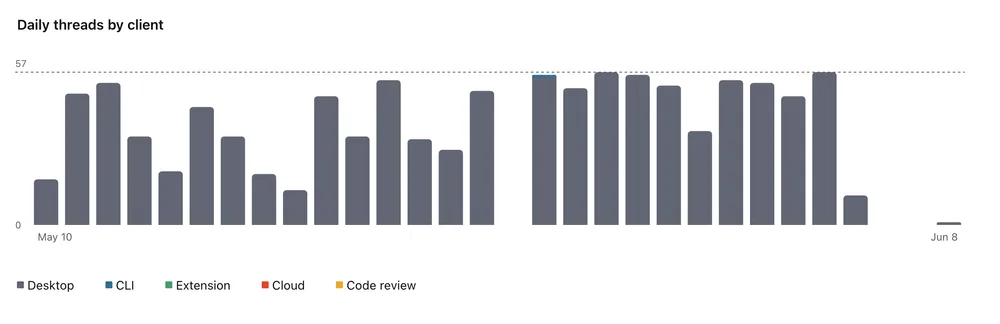
他以前干更大的活从未踩过这个坑,可今儿就这么枯景的一天,配额先没了。
于是翻本地 session log,发现其中一个 GPT-5.5 线程里 token 数居高不下:
- Run 1: GPT-5.5 (xhigh reasoning),耗时 157 秒,报告使用率 15%,结束时线程累计 token 达 777,268;
- Run 2: 同模型同配置,耗时 497 秒,报告使用率 38%,累计 token 飙升至 5,290,376。
也就是说,仅这两个 run 后面就撞上了 5 million token 的天花板,紧接着账户再次执行任务前,就满载地达到了 5h quota 的上限。
然后问题来了:
“primary %”是怎么一回事?
它会不会随订阅等级改变?
38%代表的是 38%的 Pro 5X 总额吗?
cached input token 是否也会计入配额耗减?
total token 累加是否直接影响 5h quota?
还有没有已知的指标与后台配额对不上的情况?
这些问题看起来合理但棘手,毕竟 Codex 默认不像 Claude Code 那样显式扣参与度或 token 数,很多时候你以为是轻度使用,后台却“默默”在跑一个又一个长上下文任务。
## 问题 B:Spark 诊断时直接报上下文溢出
配额问题查完,他切到了 GPT-5.3 Codex Spark 尝试自查,但马上就炸了:
- Spark 执行了几次搜索和 inspect 操作;
- 突然弹出一行提示:“Context automatically compacted”;
- 继而报错:“Your input exceeds the context window of this model. Please adjust your input and try again.”
整个流程看完让人摸不着头脑:
这可不是一个大型编码任务,只是简单地让 Spark 分析一个配额异常。但它连几次 inspect 后就直接跑满上下文,最后啥分析结果也没给出。
接着又浮出疑问:
- Spark 是不是用来处理仓库级调研的?
- 它在自动压缩上下文时,是否真的能处理好大文档?
- 有没有推荐限制的项目,比如
AGENTS.md体积、memory 文件、workspace note 文档、session 历史等? - 是否有已知缺陷会导致 Spark 重复读取大文本并迅速耗尽上下文?
- 要如何更高效地用 Spark 做故障排查或仓库调查?
## 我的看法:配额模型还没跟上使用模式
这事本身没那么罪大可恨,但它暴露了一个矛盾:
Codex 的计费方式(基于 5h quota + token usage),还没很好地贴合用户的感知操作。
比如:
- 用户觉得自己干了“两分钟活”,但后台可能已经触发了长推理链条、自动上下文压缩、多轮检索等行为;
- “primary %”这个指标又没解释清楚是否包含 cached token,等于让人盲猜;
- Spark 更是一团乱:自动压缩本来是锦点,偏偏在复杂环境下反而成了“快速撑爆上下文”的帮凶。
从 Discourse 的开源社区方案中也可以看到类似思考:真正好用的工具,不在于功能多,而在于透明可控。
Codex 在这点上还有距离。
## 建议小记
如果你也在用 Codex,尤其是 Pro 5X,以下几点或许能帮上忙:
- 尽量控制单个线程的 token 长度,避免一次性塞太多上下文;
- 在长任务前主动清理 workspace 中的 memory 文件;
- Spark 用来调研时,尽量拆解成多个小任务,而非让它一口气吃下整个仓库;
- 多关注 local log 中的 token 累计趋势,而不是 rely UI 上的“primary %”。
@Aish,你这回复像是机器人在复读教材,不如直接说“Codex 5X 5h quota 被 20 分钟小活干完,这还用优化?直接报错上下文爆了,你这优化是把问题埋了吗?