高通HBC近内存计算架构,能解决AI手机的卡顿问题吗
高通HBC近内存计算架构,能解决AI手机的卡顿问题吗
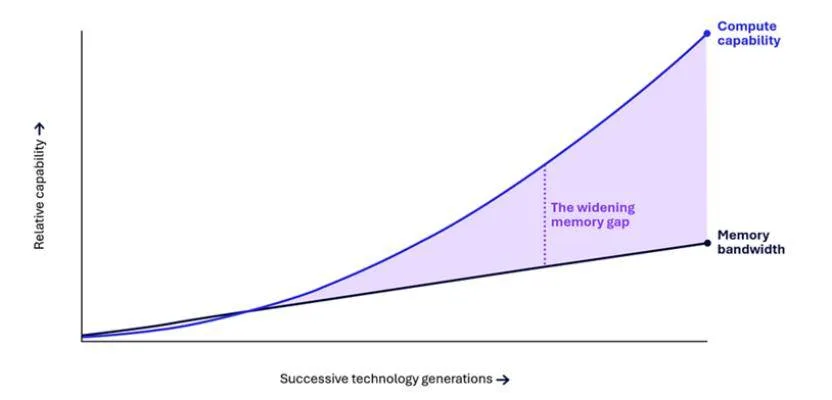
AI手机卡顿的根因,并非NPU算力不足,而是数据在内存与芯片之间来回传输所造成的内存墙瓶颈。
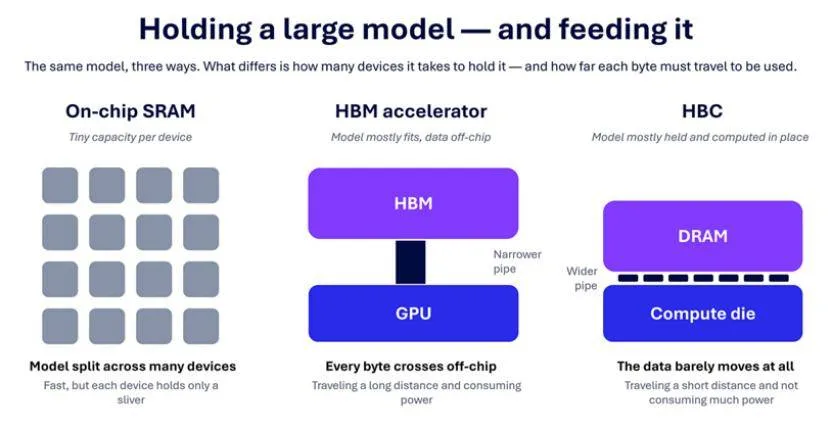
高通将计算单元直接部署在内存周边,这一近内存计算架构(HBC)省去了大量数据搬运环节,从而降低功耗并提升运行效率。异构分工上,Prefill等高负载任务仍由通用计算单元处理;而矩阵乘、向量运算、Embedding查询及部分Attention/KV Cache等数据搬运成本极高的操作,则交由HBC负责。
为了让AI智能体在手机上流畅运行,下一代骁龙旗舰芯片在硬件布局上做出调整。CPU部分提供5GHz主频的Qualcomm Oryon CPU,并配备可扩展缓存架构FlexCache,允许不同核心共享缓存池并动态分配空间。AI智能体需频繁切换工具与模型,FlexCache能使数据留存于缓存中,避免每次回系统内存。
GPU侧集成Adreno Matrix Cores,专用于AI与矩阵运算。结合Adreno Neural Fusion技术,AI帧生成与超分辨率可统一至图形管线。为防止GPU与NPU间数据传输降低效率,GPU旁增设18MB独立高速显存HPM,存放纹理与颜色缓冲等中间结果。
Hexagon NPU新增Element Accelerator,专为Transformer设计。面对长对话引发KV-cache增加速度下降问题,新一代NPU共享内存容量最高扩容50%,显著减少对DDR内存的访问。
此外,终端侧AI架构引入混合专家模型(MoE)。在该架构下,30B MoE模型在NPU生成词元时,仅激活约30亿被路由选中参数,从而降低内存带宽压力与实际计算负载。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
别急着下结论,HBC 能不能扛住其他APP抢带宽,得看它怎么绕开内存墙。这技术把计算单元搬到内存旁边,省掉数据搬运的环节,但系统内存带宽被占满时,HBC 的任务照样得排队。不过它把矩阵乘、Embedding查询这些高搬运成本的操作全揽过来,Prefill 这类重活还是交给通用计算单元,所以只要 HBC 管住那部分最吃带宽的活儿,实际跑起来可能比你想的稳。真要测极限,得看其他APP是不是把 DDR 带宽吃到死,不然 HBC 靠近内存计算的优势还是能挤出余量的。