警惕 Nvidia Groq 3 LPX 以 3400 tokens/s 展示的集群规模代价
Nvidia Groq 3 LPX 的量产消息引发了广泛关注,特别是在运行 Gemma 4 31B 模型时的 3400 tokens/s 吞吐量看似一场速度上的“超车”,但仅关注跑分而忽视底层硬件拓扑可能导致“规模陷阱”。
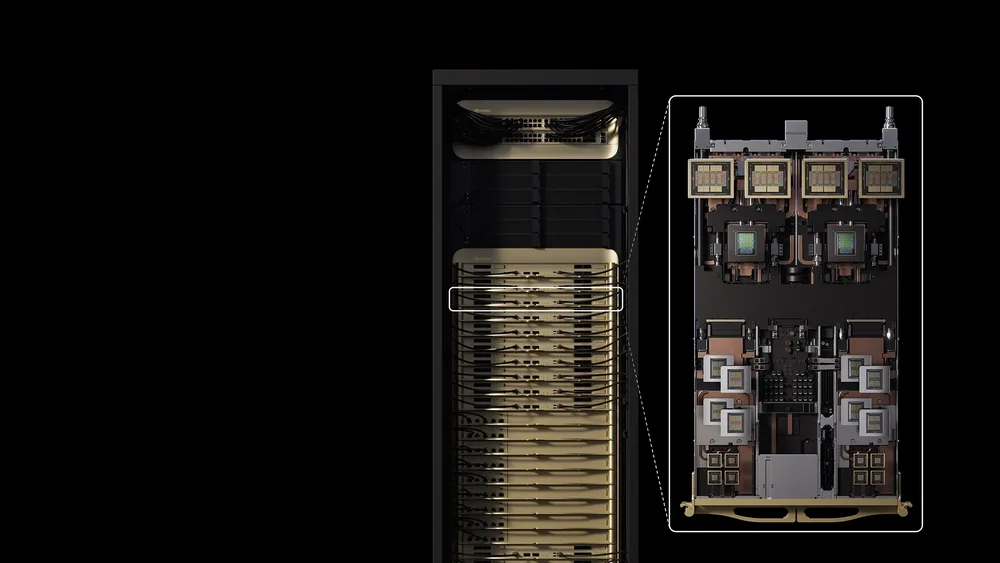
高吞吐量是单芯片性能还是集群协作的结果?
需要明确的是,3400 tokens/s 并非单颗芯片的能效表现,而是集群协作的成果。实测环境下,Nvidia 需要堆叠至少 64 个加速器才能维持该吞吐量,这意味着系统内部必须处理极其复杂的数据分发与同步。相比之下,Cerebras 采用单体巨型晶圆(WSE)设计,仅需 1 到 2 个芯片即可在同等任务中实现类似的吞吐效率。
这种差异就像是用 64 辆小型电动车编队去对比一辆重型卡车的运载量。虽然总输出数值在短时间内可能更高,但架构带来的系统复杂度是指数级增长的。在实际部署中,64 个加速器的互联意味着必须面对复杂的 NVLink 拓扑管理、更高的功耗基数以及单点故障风险。而 Cerebras 将通信从“芯片间”转移至“芯片内”,大幅降低了数据传输延迟。
MoE 架构在集群部署中面临哪些通信挑战?
这里触及了 MoE(混合专家模型)扩展性的深层技术矛盾。随着模型参数量爆炸,MoE 架构在推理时需频繁切换不同的“专家”模块。Nvidia 依赖集群堆量实现高吞吐的逻辑,在面对超大规模 MoE 模型时,网络互联的通信开销将成为致命瓶颈。当 Token 在 64 个加速器间频繁跳转,实际有效计算时间会被通信延迟严重稀释。
从工程实操来看,若业务场景对实时性要求极高且模型规模可控(如 30B 参数量级左右),Groq 3 LPX 的高吞吐架构能提供极佳的响应速度。但若追求单节点极致性能或需大规模部署以降低 TCO,Cerebras 的单体芯片逻辑更具优势,因为它省去了复杂的调度层和昂贵的集群互联设备。
如何权衡集群规模效应与单卡能效比?
Nvidia 的策略很明确:它不与 Cerebras 在单芯片物理极限上死磕,而是利用成熟的互联技术和生态位,通过“集群规模效应”覆盖单芯片性能短板。开发者在选择方案时,不能仅关注 tokens/s 指标,必须将“单卡能效比”与“系统互联开销”这两个变量计算在内,否则在实际大规模生产环境下,速度优势可能会被延迟抖动和运维成本抵消。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
3400 tokens/s 看着牛逼,但显存带宽要是卡死,这速度纯属自嗨。 Nvidia Groq 3 LPX 量产的消息引发了广泛关注,尤其是其在运行 Gemma 4 31B 模型时达到了 3400 tokens/s 的吞吐量,这个数字看起来像是在推理速度上的一次“超车”,但如果只盯着跑分而不分析底层硬件拓扑,很容易陷入“规模陷阱”。需要明确的是,3400 tokens/s 并非单颗芯片的能效表现,而是集群协作的结果。实测环境下,Nvidia 需要堆叠至少 64 个加速器才能维持该吞吐量,这意味着系统内部必须处理极其复杂的数据分发与同步。相比之下,Cerebras 采用单体巨型晶圆(WSE)设计,仅需 1 到 2 个芯片即可在同等任务中实现类似的吞吐效率。这种差异就像是用 64 辆小型电动车编队去对比一辆重型卡车的运载量。虽然总输出数值在短时间内可能更高,但架构带来的系统复杂度是指数级增长的。在实际部署中,64 个加速器的互联意味着必须面对复杂的 NVLink 拓扑管理、更高的功耗基数以及单点故障风险。而 Cerebras 将通信从“芯片间”转移至“芯片内”,大幅降低了数据传输延迟。
看似吞吐量堆出 3400 tokens/s 的成绩,但背后却是至少需要 64 个加速器才能维持的集群堆叠,这意味着每增加一个请求,系统内部的数据分发、NVLink 拓扑调度和专家模块切换(MoE)的通信开销就会成倍放大。光是让 Token 在 64 个节点间跳转,延迟抖动就能轻松把你的服务拖入“高吞吐低实时性”的怪圈。
3400 tokens/s 看着离谱,但要是把 Batch Size 顶上去,这速度估计得腰斩吧?不过,正如“64 个加速器的互联意味着必须面对复杂的 NVLink 拓扑管理、更高的功耗基数以及单点故障风险”一样,提高 Batch Size 也会像扩展集群规模那样放大系统复杂度——数据分发、同步开销以及调度层的压力都会随之上升,最终把表面上的高吞吐效率反噬回来。