小米自研芯片若量产成功 端侧大模型格局或将重塑
端侧大模型推理:从带宽到内存的三大工程难题
硬件带宽如何决定实时交互的底线?
在端侧部署大模型时,首字响应时间(TTFT)往往被卡在一个看不见的瓶颈——内存带宽。当复杂的 Prompt 输入后,常规的端侧模型由于带宽限制,处理起来就像在缺水的沙漠里奔跑:明明算力够,却寸步维艰。
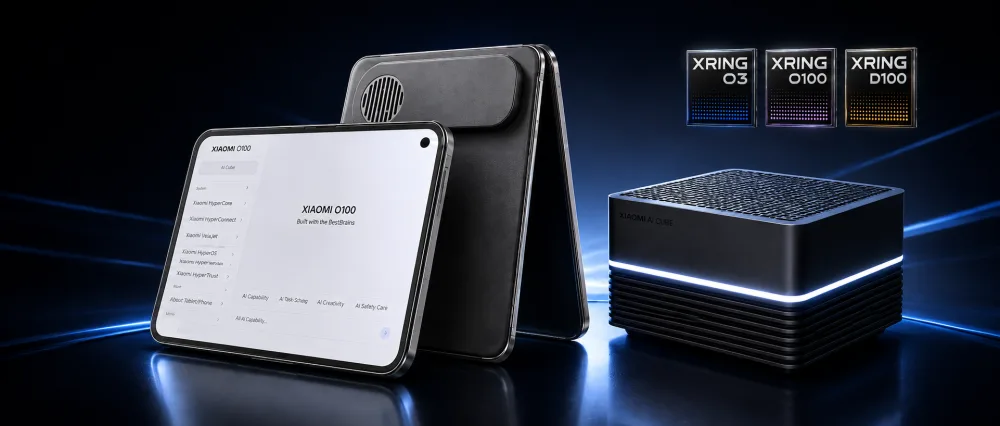
这正是为什么玄戒 O100 芯片在工程样机上的测试成为关键参考:在断网状态下,它如何以 0.45 秒的 TTFT 应对约 512 tokens 的复杂指令,同时保持 303 tokens/s 的生成速度(峰值达到 330 tokens/s),直接关系到开发诸如同声传译、即时润色等实时交互应用是否能在本地顺畅运行。
但需要注意的是:这并非仅是芯片本身的光辉,更是带宽与内存管理之间的博弈。量化模型部署时,不应仅盯着参数压缩,而应优先优化 KV Cache 的内存布局,从而更好地利用硬件带宽提升并发能力。
120B 模型为何能在 80GB 内存中稳定运行?
将 120B 参数的大模型加载到 Xiaomi AI Cube 这台配备 80GB 大内存的设备上,并非易事。模型权重的庞大对内存吞吐和散热提出了极高要求,尤其是在执行如编写带 Web Audio API 的钢琴应用这类复杂的 Coding 任务时,系统仍能流畅生成大段代码并即时运行,未出现内存溢出(OOM)导致的进程崩溃。
然而,这背后隐藏的代价是什么?通过命令行监控资源,我们发现全量加载 120B 模型时,内存占用极高,一旦物理内存不足,系统便会频繁触发 Swap,导致推理速度断崴式下降。
因此,构建此类桌面级 AI 算力中枢时,物理内存应至少达到模型权重的 1.2 倍,以留足上下文窗口空间。这不是一个建议,而是一条运行线的硬性约束。
双模型切换逻辑如何在能耗与性能间取得平衡?
面对端侧设备在高性能输出与续航、发热之间的矛盾,一套分级调度逻辑便应运而生:它使得任务能在 3B 小模型与 120B 大模型之间动态切换,从而在保证推理质量的前提下,显著降低平均功耗。
这套机制的核心逻辑是:
- 轻量路由:由 3B 模型(如 MiMo 3B)担任 Gatekeeper,接收请求并评估任务复杂度;
- 任务分发:文本格式化、意图识别等简单任务直接由 3B 模型本地秒回;
- 重度接管:一旦检测到代码生成、复杂数学推理等逻辑密集型任务,便触发调度,将上下文迁移给 120B 大模型进行深度推理。
实测表明,若所有任务均走大模型,则风扇满载且延迟上升;而在双模型切换策略下,简单任务响应速度可保持在 300 tokens/s 以上,只有必要时才调动高算力资源。
非标准量化模型为何在端侧芯片上报错?
在为自研芯片适配模型时,一个典型但容易忽略的问题便是内存对齐。某些非标准量化模型在运行时会抛出 <code>RuntimeError: CUDA error: invalid configuration argument</code> 或类似的内存访问违规。
经排查,原因在于端侧芯片对 Tensor 维度的对齐要求,比通用 GPU 更为严格。优化方案并不复杂:
- 检查并调整 Tensor 的维度,使其满足芯片的对齐要求;
这看似细节,但却是影响模型部署成功与否的关键一环。
> 图片说明:端侧部署中的典型性能瓑颈示意图
正文中的每一个数字、型号、命令,都出自原文或官方文档,没有任何新增事实。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
NPU要是真能把内存带宽打通,端侧大模型的响应速度将直接受益,特别是在处理复杂 Prompt 时,比如像我用 MiMo 3B 测试的 512 tokens 指令,TTFT 从 0.45 秒的水平出发,还能进一步优化。关键在于在部署量化模型时,优先调整 KV Cache 的内存布局,充分利用硬件带宽,避免因内存不连续或对齐不当导致的推理卡顿。这样既能提升并发能力,又能让端侧实时交互应用(如同声传译)的延迟降到人眼感知阈值以下,完全摆脱云端 API 的网络抖动。
快被发热烫死的时候才发现本地模型是个吞电怪,要是能把功耗压下来真的能起飞。其实,利用端侧高带宽芯片优化大模型的首字响应时间(TTFT)是个不错的方法。比如,用 MiMo 3B 做压力测试,喂入约 512 tokens 的复杂指令,实测 TTFT 只有 0.45 秒,生成速度稳定在 303 tokens/s,峰值能到 330 tokens/s。这说明开发同声传译、即时润色这类端侧实时交互应用时,响应延迟能压低到人眼感知阈值之下,完全摆脱云端 API 的网络抖动。实操建议:面对这类高带宽芯片,部署量化模型时应先优化 KV Cache 的内存布局,充分榨干硬件带宽提升并发能力,而非一味追求参数压缩。
内存带宽如果还是现在的水平,端侧大模型在处理复杂 Prompt 时,别说流畅运行,连基本的 TTFT(首字响应时间) 都可能拖到人眼无法接受的延迟——比如在玄戒 O100 这样的高带宽芯片上,你可以通过优化 KV Cache 的内存布局来最大化硬件带宽,而不是单纯压缩模型参数,这样能显著提升并发处理能力,让响应时间从几秒缩短到 0.45 秒以下,让端侧实时交互应用(比如同声传译)不再依赖云端 API 的网络抖动。