用 3D 白模精确锁定镜头轨迹,AI 才能真正填补画面细节
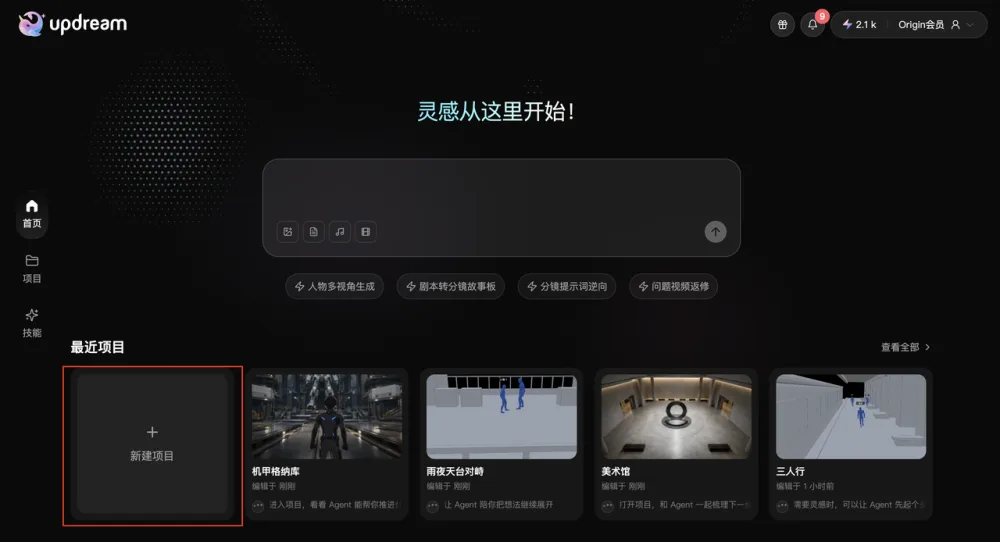
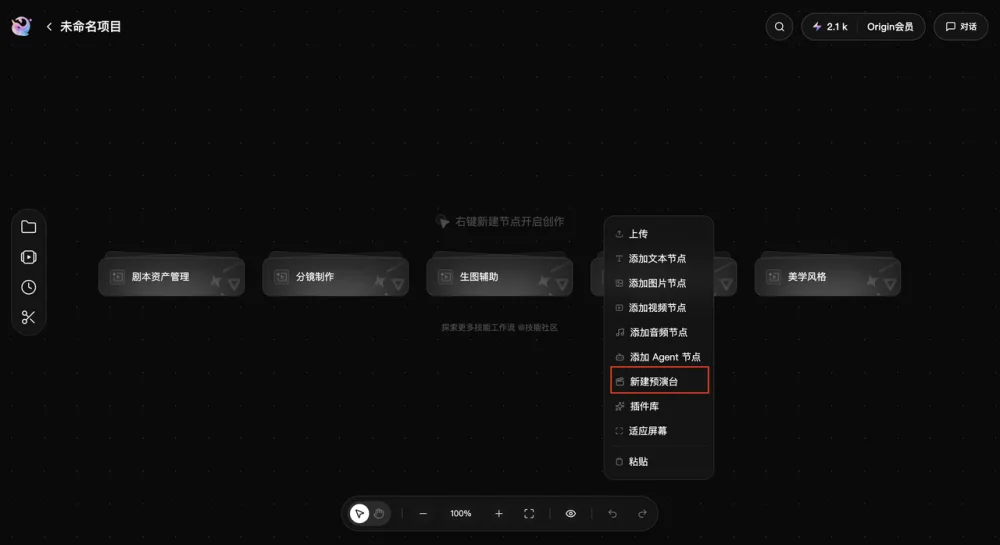
在 AI 视频制作中,最让人头疼的往往不是画面质感本身,而是如何让机位和人物动作与预期完全对齐。传统方法依赖文字描述或低效的手绘白模,容易导致运镜节奏失控或人物位置偏离设计意图。近期,预演工具升级后,通过“参考图转白模”功能,用户只需几张高纵深广角参考图,就能在几分钟内生成可编辑的 3D 白模空间。这意味着:
- 白模的核心优势
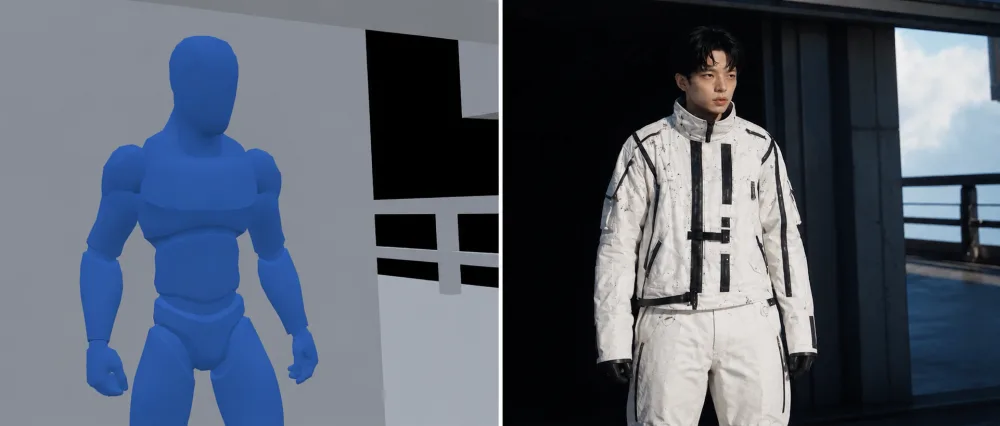
当镜头需要绕到人物背后再缓慢展开背景时,纯文字描述无法精确控制轨迹幅度和时机。而通过白模,用户可以在三维空间中精确拖动机位轨迹,确保运镜方向和节奏一致,避免 AI 模型在“抽卡”或过度平滑动作时产生意外效果。例如,在多人交互场景中,比如三个人在站台擦肩而过,白模能直观地展示人物相对位置和运动轨迹,而文字描述可能难以准确传达“A 在 B 左边五米处出现”的时空关系。
- 动作细节仍需视频模型协助
白模只能确定“拍什么”,无法直接控制“怎么动”。比如拳击动作,白模只能固定人物站立位置,而拳头的挥动则完全依赖于视频模型的能力,或者需要结合更细粒度的 3D 资产(如动作骨架)进行约束。这意味着在复杂动作场景中,白模仍需与高级渲染工具(如 Seedance 2.5)结合,才能保证最终画面的逼真度。
- 实际操作流程简化
用户只需遵循以下步骤:
- 上传参考图:选择纵深感强的广角图,系统自动生成可编辑白模空间(如 updream 的“参考图转白模”功能)。
- 快速调整机位:使用快捷键 G(移动)和 R(旋转)快速布局人物和镜头轨迹。
- 录制预演视频:在时间轴上设置关键帧,录制白模中的动作轨迹。
- 最终渲染:将预演视频作为控制条件,结合 Seedance 2.5 等模型,生成最终画面,主要任务是填充材质和光影。
这与传统工作流相比,大幅降低了“抽卡”风险,将创作者的控制权从随机生成转向可视化设计。例如,武侠对决中的推拉摇移,白模可以事先固定机位,而视频模型则专注于材质和光影细节,两者相辅相成。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
赶紧加上深度图试试,边缘稳得像焊死了一样,效率直接起飞。不过我更建议先拿几张有纵深感的广角场景图跑出白模,在三维空间里把人物站位和机位轨迹全部定死,再交给视频模型渲染,这样运镜方向和节奏极其稳定,不用在文字里反复描述“A 在 B 左边五米处出现”这种抽象指令。
白模定位简直救命,再也不用对着随机生成的镜头抽奖了!特别是做 AI 视频最让人抓狂的不是画面质感,而是机位怎么调都对不上、人物走位完全不可控,解决这个问题,我最近把重心放在了 AI 视频预演(Previs)上:先在极简的 3D 白模里把摄影机轨迹、人物站位、镜头节奏全部定死,再交给视频模型去渲染最终画质。实测了 updream 的预演台,最省事的是“参考图转白模”功能,以前得啃 Blender 这种专业软件,学习曲线陡峭得吓人;现在只要传几张有纵深感的广角场景图,几分钟就能跑出一个可编辑的 3D 白模空间。整条工作流变成了:白模里摆好人物 → 规划机位轨迹 → 录制预演视频 → 配合 Prompt 生成最终画面。实测几个不同复杂度的场景,结论很直观:空间调度类:单镜头绕到人物身后再揭示宏大背景。纯靠 Prompt 描述,模型常在“绕”的幅度和时机上翻车;有了白模轨迹,运镜方向和节奏极其稳定。
白模定位渲染完简直是闪烁之王,眼睛都要看瞎了,怎么破?建议把预演视频当控制条件,配合 Seedance 2.5 等模型做最终渲染,看看能不能稳住。