别再迷信通用大模型了,组织内部的私有知识才是真正的竞争壁垒
现在很多公司在落地 AI 时陷入了一个误区:认为只要订阅了 GPT-4o 或 Claude 3.5 的企业版,就拥有了 AI 竞争力。但实际操作下来你会发现,通用模型在处理标准文档、写代码片段时确实高效,但在解决具体业务问题时,往往给出的答案是“正确但无用”的废话。
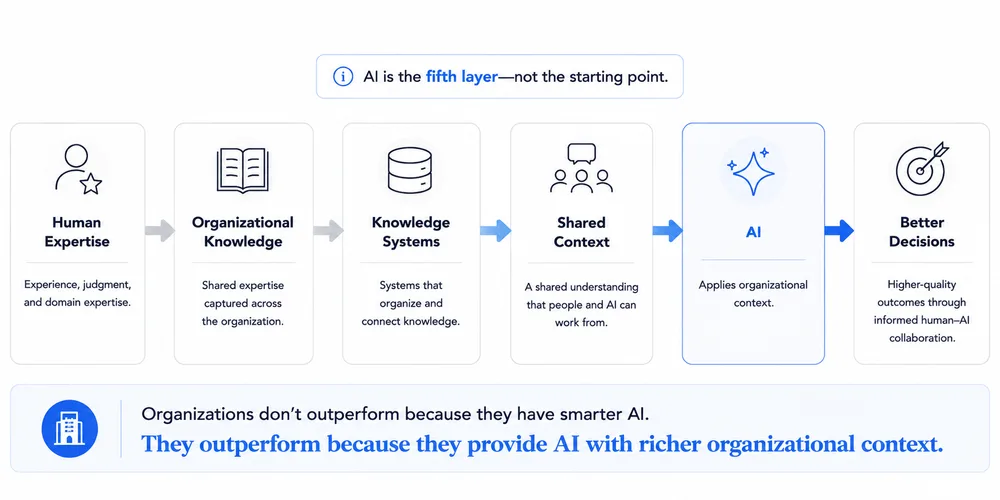
这种现象的根源在于,通用模型掌握的是全人类的公开知识,而决定一家公司生死存亡的,往往是那些从未公开的、碎片化的私有知识(Organizational Knowledge)。比如,通用模型知道如何制定一套标准的市场进入策略,但它绝对不知道你们公司去年在东南亚某个具体城市尝试推广时,因为哪个当地法律细节导致项目折戟;它知道怎么写客户沟通话术,但它不知道某个关键大客户在非正式通话中随口提到的一句对产品的真实痛点。
如果你仅仅把 AI 当成一个润色文档的工具,你其实是在用一个所有竞争对手都能买到的工具在竞争,这本身不构成任何护城河。真正的差距,取决于你如何将组织内部的隐性知识高效地转化为 AI 的生产力。
在尝试多种落地方案后,我发现简单的“上传几个 PDF 建立知识库”是效率最低的做法。要让 AI 真正理解私有数据,必须构建一套严密的知识流转机制,我总结为以下三个核心维度:
首先是知识的“原子化”处理。很多团队习惯直接把几百页的业务手册扔进 RAG(检索增强生成)系统,结果导致模型在检索时由于上下文噪声太大,经常出现幻觉或遗漏关键点。最高效的路径是将知识拆解为最小可验证单元。例如,将一个复杂的业务流程拆分成 50 个具体的 Q&A 对,这种结构化的处理方式能显著提升检索精度,确保 AI 在回答时能精准命中那个特定的知识点,而不是在长文档中随机抓取。
其次是建立动态的更新机制。私有知识具有极强的时效性,一个三个月前的技术方案在快速迭代的业务中可能已经失效。如果 AI 依赖的知识库没有实时更新,它给出的结论不仅没有价值,反而会误导决策。一个成熟的 AI 工作流应当包含“冲突检测”环节:当 AI 发现检索到的内部知识与当前输入的事实存在矛盾时,必须自动标记该条目并触发人工修正提醒,而不是强行将旧知识包装成正确答案。
最后,也是最关键的一点,是将 AI 从“问答模式”推向“执行模式”。单纯的问答只是在消费知识,而真正的实战红利来自于将私有知识转化为 AI 的操作指南。这意味着你需要通过精细化的 System Prompt,强制 AI 在分析问题时必须经过内部知识库的校验。
这里分享一个我在实际部署中使用的内部知识约束示例,你可以参考这个逻辑来构建你的 Prompt:
# 内部知识约束指令
你现在的角色是公司高级技术顾问。在针对任何方案给出建议前,必须严格执行以下检索链路:
1. 强制检索 [Private_Knowledge_Base] 数据库中关于该功能模块的所有历史故障记录(Incident Reports)。
2. 对比当前建议方案与历史记录中的"禁止操作"项。如果存在潜在冲突,必须在回答的第一段使用【风险预警】加粗标注。
3. 所有的结论必须严格引用内部文档的具体章节号(如:参考《2024技术架构指南》第 3.2 节)。
通过这种强制性的约束,AI 不再是凭感觉猜测,而是变成了一个时刻翻阅公司“避坑指南”的资深专家。
总结来看,大模型本身只是一个强大的引擎,而组织内部的私有数据才是驱动这个引擎产生商业价值的燃料。谁能率先将那些深埋在老员工脑子里、散落在冗余文档里的隐性知识数字化,并将其与模型深度挂钩,谁才能在 AI 时代建立起真正的竞争优势。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
最怕 AI 拿着三年前的过期文档一本正经地胡说八道,简直是地雷。