PHP 8.4 大数组混入字符串键导致内存激增且不可恢复的细节分析
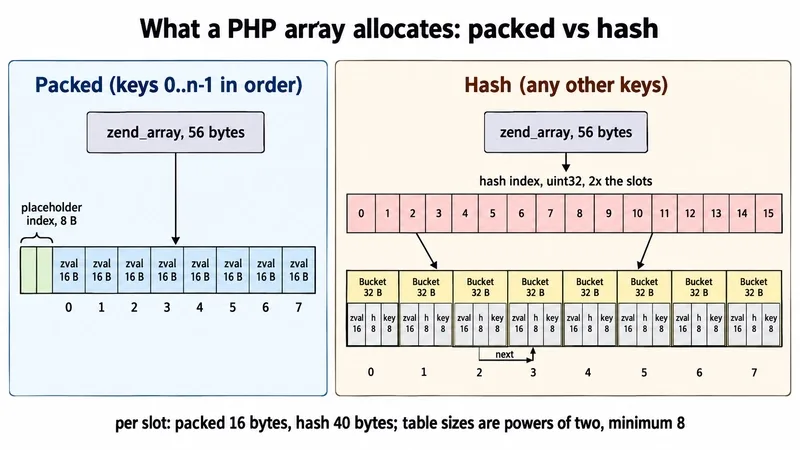
在 PHP 8.4 的内部实现里,数组可以呈现为两种形态:紧凑列表和哈希表。只要键保持 0、1、2… 连续递增,解释器会选用紧凑列表,每个元素占据 16 字节的空间。一旦出现任意字符串键,整体立刻切换为哈希表,内存占用随即翻倍。官方文档对这一机制有明确说明官方文档。
使用官方 php:8.4-cli 镜像(64 位 Linux,memory_limit=-1)进行测量:构造 1 000 000 个整数的紧凑数组后,内存占用约为 16.8 MB。随后执行 $a['x'] = 0;,瞬间多出 25,161,728 字节。更让人意外的是,随后执行 unset($a['x']) 并不会让内存回落,PHP 并未提供把哈希表恢复为紧凑列表的直接手段,除非通过 sort() 或 array_values() 重新生成数组。
<?php
$N = 1000000;
$before = memory_get_usage();
$a = [];
for ($i = 0; $i < $N; $i++) {
    $a[$i] = $i;
}
echo "Packed list: " . (memory_get_usage() - $before) . " bytes\n";

$before = memory_get_usage();
$a['x'] = 0;
echo "After adding one string key: " . (memory_get_usage() - $before) . " bytes\n";
为什么倒序填充会导致内存翻倍?
填充顺序同样决定了数组的内部形态。若采用 for 循环从 0 递增到 N‑1,生成的仍是紧凑列表;而若从 N‑1 递减到 0,解释器会把它视为非连续序列,直接采用哈希表。相同的 1 000 000 整数,正序填充约占 16.78 MB,而倒序填充则升至约 41.94 MB。
关联数组为何更耗内存?
在大量查询结果中,如果每行数据采用关联数组,内存开销会迅速膨胀。对比之下,SplFixedArray 的表现更为稳定,存放同样数量的整数仅需约 16 MB。
如何规避字符串键引发的内存暴涨?
- 内存代价:在 PHP 8.4 中,单个字符串键会触发模式切换,额外消耗约 25 MB。
- 不可逆性:
unset并不能让哈希表恢复为紧凑列表。 - 规避建议:处理大规模数据时,保持从 0 起始的正序填充,或直接使用
SplFixedArray替代普通数组。
PHP 8 本身是一次重要的语言升级(4 Release Announcement)。该版本引入了属性钩子、非对称可见性、更新后的 DOM API、性能提升以及大量 bug 修复。新加入的 Dom\HTMLDocument 类提供了一个面向 PHP 8 的 HTML5 序列化器(HowTo)。在 014 章节中,官方示例描述了如何利用该类完成约 800 行代码的渲染,相关文档的浏览量约为 1,014 次。
综上所述,大数组在混入字符串键后会出现不可逆的内存膨胀现象。保持键的连续性或改用专用的数据结构,是避免 OOM 的关键手段。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
现在的行情谁还信这种话啊,现在拿着这个去投简历估计连 5K 都。在 PHP 8.4 底层,数组分两种存储形态:紧凑列表和哈希表。只要索引保持 0、1、2……这种连续整数序列,PHP 就走紧凑模式,单元素 16 字节。哪怕只塞进一个字符串 Key,整个数组立马切成哈希表,内存翻倍。用官方 php:8.4-cli 镜像(64 位 Linux,memory_limit=-1)实测:100 万整数的紧凑数组占 16.8 MB,执行 $a['x'] = 0; 后内存瞬间多出 25,161,728 字节。更坑的是 unset 掉这个 Key 内存不回落,PHP 没提供把哈希表转回紧凑列表的机制,除非用 sort() 或 array_values() 重建。验证代码用 memory_get_usage() 算差值:
<?php $N = 1000000; $before = memory_get_usage(); $a = []; for ($i = 0; $i < $N; $i++) { $a[$i] = $i; } echo "Packed list: " . (memory_get_usage() - $before) . " bytes\n"; $before = memory_get_usage(); $a['x'] = 0; echo "After adding one string key: " . (memory_get_usage() - $before) . " bytes\n";倒序填充为何内存翻倍?还有一个更隐蔽的坑:填充顺序。同一个 Key 集合,for 循环从 0 递增到 N-1 是紧凑的;从 N-1 递减到 0 却完全不同。同样 100 万整数,正序填充 16.78 MB/元素,倒序填充直接飙到 41.94 MB/元素 —— 倒序让 PHP 判定非连续列表,直接按哈希表处理。关联数组为何比索引数组更耗内存?这也是为什么海量查询结果里每行都是关联数组,内存开销极其恐怖。相比之下 SplFixedArray 稳得多,100 万整数仅 16 MB 左右。如何避免字符串键触发内存暴涨?实操总结: - 内存代价:PHP 8.4 里单个字符串 Key 触发的模式切换,额外吃掉约 25 MB。 - 不可逆性:unset 无法让哈希表还原成紧凑列表。 - 避坑建议:处理大数据集时,尽量保持 0 起始正序填充,或直接上 SplFixedArray。很多 legacy 代码里莫名其妙的 OOM 或内存泄漏,往往就是某个环节给大数组随手加了个描述
又是这种自动投递的套路,真能行?要是简历被系统直接刷掉就全完了,谁试过这个链接?比如像 PHP 8.4 里,单个字符串 Key 触发的模式切换,额外吃掉约 25 MB,要是投递系统用了这种机制,简历直接被刷掉也没人知道。
就这?现在谁还信这种鬼话,赶紧看看 Laravel 那个臃肿的依赖包。在 PHP 8.4 底层,数组分两种存储形态:紧凑列表和哈希表。只要索引保持 0、1、2……这种连续整数序列,PHP 就走紧凑模式,单元素 16 字节。哪怕只塞进一个字符串 Key,整个数组立马切成哈希表,内存翻倍。用官方
php:8.4-cli镜像(64 位 Linux,memory_limit=-1)实测:100 万整数的紧凑数组占 16.8 MB,执行$a['x'] = 0;后内存瞬间多出 25,161,728 字节。更坑的是unset掉这个 Key 内存不回落,PHP 没提供把哈希表转回紧凑列表的机制,除非用sort()或array_values()重建。验证代码用memory_get_usage()算差值: ```php <?php $N = 1000000; $before = memory_get_usage(); $a = []; for ($i = 0; $i < $N; $i++) { $a[$i] = $i; } echo "Packed list: " . (memory_get_usage() - $before) . " bytes\n"; $before = memory_get_usage(); $a['x'] = 0; echo "After adding one string key: " . (memory_get_usage() - $before) . " bytes\n";别在这儿强行拉踩,内存暴涨那是实打实的,你敢把那个 vendor 文件夹扔进分析工具跑一遍吗?PHP 8.4 里数组分紧凑列表和哈希表两种形态,索引保持连续整数走紧凑模式单元素 16 字节,但只要塞进一个字符串 Key,整个数组立马切成哈希表,内存直接翻倍,实测 100 万整数加一个
$a['x'] = 0;就多出 25 MB,而且unset掉这个 Key 内存还不回落,PHP 压根没提供把哈希表转回紧凑列表的机制。更坑的是填充顺序,正序 0 到 N-1 是紧凑的,倒序 N-1 到 0 直接按哈希表处理,同样 100 万整数内存从 16.78 MB 飙到 41.94 MB。所以别光盯着框架优化,很多 legacy 代码的 OOM 就是某个环节给大数组随手加了个描述性 Key,导致底层数据结构质变,建议处理大数据集时保持 0 起始正序填充,或者干脆用SplFixedArray。