用 Helion 配合 Hugging Face Kernels 搞高性能算子分发到底怎么操作
直接给结论:如果你想写高性能 ML 算子又不想死磕 CUDA 或 Triton 的底层内存管理,可以用 Helion 这种 Tiled DSL。它最核心的优势是把 Tile 大小和 Lowering 策略(比如内存访问模式、循环展平方式)全部交给 Autotuner 去搜,而不是让你手动调优。现在 Hugging Face 的 Kernels 项目已经支持 Helion 了,这意味着你可以把调优后的配置直接打包分发,让用户免去冷启动时的漫长搜参时间。
Helion 这种 PyTorch 风格的 DSL 怎么写
Helion 的编程模型基本可以概括为 PyTorch with tiles。你不需要管具体的指针运算,只需要定义好 Tile 范围,剩下的交给编译器。
拿矩阵乘法(Matmul)来说,用 Helion 写出来大概长这样:
import torch, helion, helion.language as hl

@helion.kernel()
def matmul(x: torch.Tensor, y: torch.Tensor) -> torch.Tensor:
    m, k = x.size()
    k, n = y.size()
    out = torch.empty([m, n], dtype=x.dtype, device=x.device)

    for tile_m, tile_n in hl.tile([m, n]):
        acc = hl.zeros([tile_m, tile_n], dtype=torch.float32)
        for tile_k in hl.tile(k):
            acc = torch.addmm(acc, x[tile_m, tile_k], y[tile_k, tile_n])
        out[tile_m, tile_n] = acc

    return out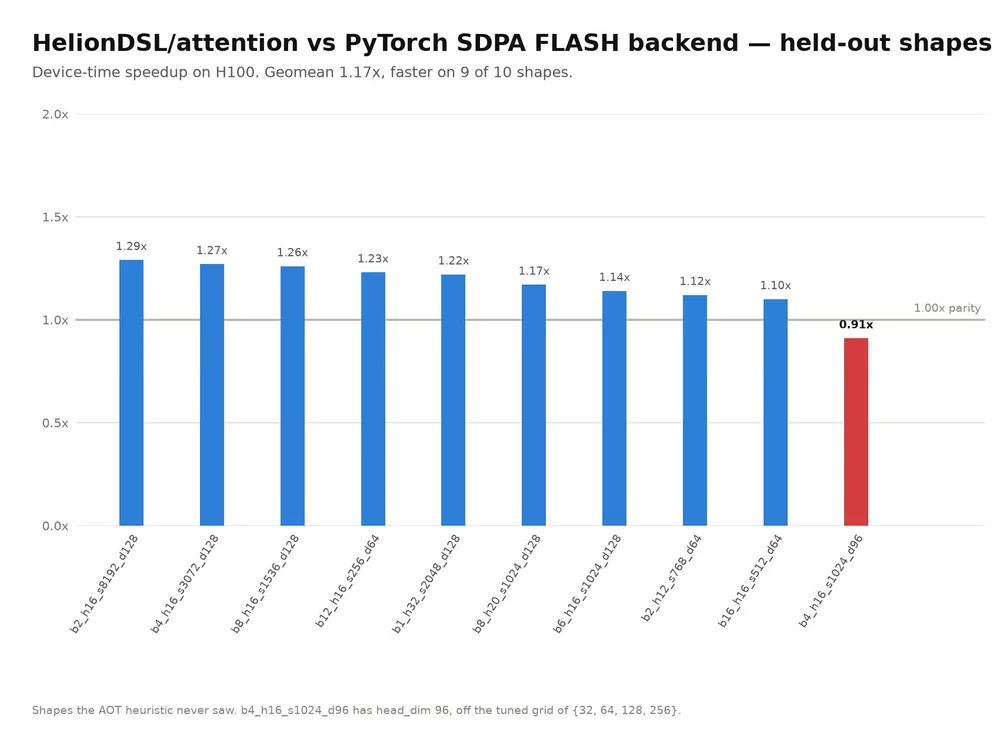
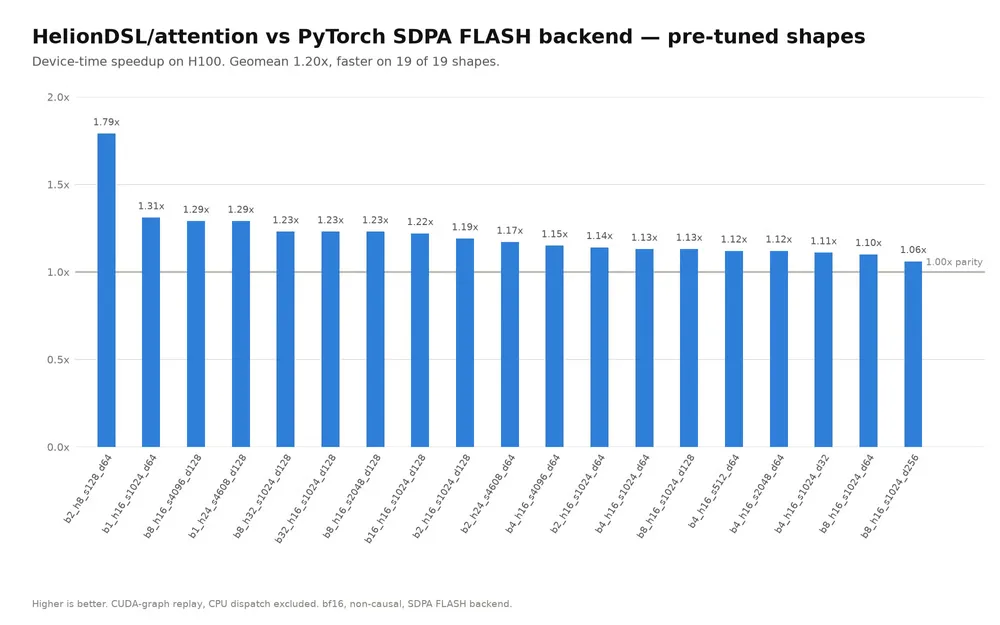
这里的关键点在于 hl.tile。在 Triton 或 CUDA 里,如果你想换一种内存访问模式(比如从指针算术切到 Block Pointers 或 TMA),你可能得把整个内核重写一遍。但 Helion 把这些决策变成了搜索空间。Autotuner 不仅刷 Tile 的数值,还会尝试不同的实现策略(Lowering strategies),比如 Reduction 是用 Persistent 还是 Looped 模式,这让它在面对大量不同 Shape 的输入时,性能往往能反超手写的低级语言算子。
解决分发碎片的 Kernels 项目
现在算子分发太乱了,源码结构不统一,工具链各搞一套,用户安装时经常卡在编译阶段,就算有 Wheel 包也未必能跑通。
Hugging Face 的 Kernels 项目(为了区分,这里简称 K 项目)试图把 AoT(提前编译)和 JIT(即时编译)算子的打包流程标准化。它主要分两个部分:
- kernel-builder:这是给开发者的。用来把算子按照统一标准打包,确保在不同框架版本和系统配置下都能复现,方便在 Hugging Face Hub 上分享。
- kernels:这是给消费者的 Python 库,让用户能无缝调用这些算子,不用再手动管理依赖地狱。
为什么需要预调优配置
Helion 的 Autotuning 虽然强大,但有个痛点:慢。如果每个用户在第一次运行算子时都要跑一遍全量搜索,冷启动时间会非常恐怖。
通过 K 项目,开发者可以将针对特定问题规模(Problem sizes)预先调优好的 Config 直接随算子一起发布。这样用户拿到算子后,直接加载预设的最优配置即可运行,性能起飞的同时省掉了搜索时间。
总结一下,这套组合拳的逻辑是:用 Helion 快速写出高性能逻辑 → 利用 Autotuner 搜出最优实现 → 通过 Kernels 项目标准化打包 → 随算子分发预调优配置 → 用户端零成本部署。
手动调 Tile 大小简直是折磨,我上次死磕那个 128x64 的块调了三天还没跑赢 baseline,这玩意儿真能自动搜出最优解?