NVIDIA 将 CUDA Rust 推进至 2027 年后,GPU 编程范式或迎重大变革
GeForce 和工作站 GPU 的 CUDA Rust 支持目前处于 alpha 阶段,用户可以通过设置内核模块参数 NVreg_OpenRmEnableUnsupportedGpus=1 来选择启用。这一举措显示了 NVIDIA 在推进 CUDA Rust 过程中对不同硬件平台的兼容性考量,同时 GeForce 系列显卡作为消费级市场的代表,其支持情况也间接反映了技术路线的成熟度。GeForce GPU 用户若要体验 CUDA Rust,需在 R515 开发驱动版本下进行测试,该驱动可通过 CUDA Toolkit 11.7 或 Beta 驱动下载页面获取。NVIDIA 希望与 Linux 内核社区及合作伙伴共同推动上游方案,已发布的源代码可作为参考以改进 Nouveau 驱动。Canonical 计划将相关开源内核模块集成到 Ubuntu 22.04 LTS 中,而 SUSE 则会随 SUSE Linux Enterprise 15 SP4 发布这些模块,显示出 CUDA Rust 技术在不同操作系统生态中的逐步落地。
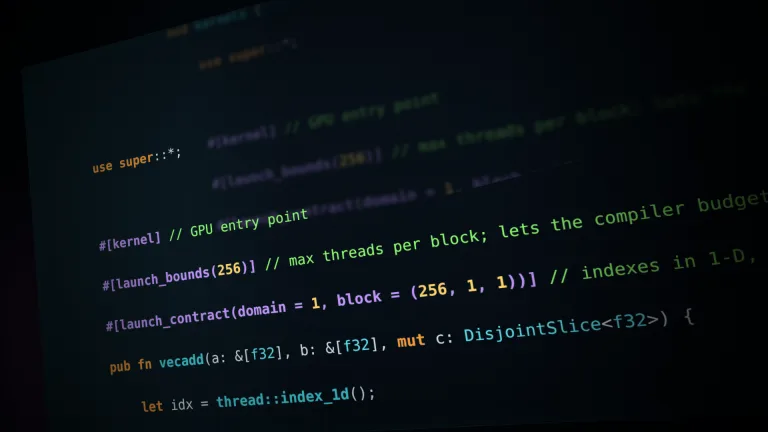
对于开发者而言,CUDA Rust 的前景取决于其在 2027 年后能否真正改变 GPU 编程范式。目前存在两种技术路线:一种是通过 FFI 调用 CUDA C++ 库或使用绑定机制将 Rust 代码编译为 PTX,这种方式兼容性好,但开发者仍需处理 C++ 逻辑,Rust 的内存安全优势在跨语言调用时被削弱,依然面临 unsafe 块的挑战;另一种是让 Rust 直接编写核函数,利用所有权和借用检查机制在编译期拦截潜在错误,若成功将极大缓解内存崩溃问题。以下伪代码展示了简单向量加法的编写方式:
// 假设在一个支持 CUDA Rust 的环境下编写简单的向量加法
#[cuda_kernel]
fn vector_add(a: *const f32, b: *const f32, c: *mut f32, n: i32) {
    let i = thread_idx(); // 获取当前线程索引
    if i < n {
        unsafe {
            // 尽管在核函数内部依然需要 unsafe,
            // 但 Rust 的类型系统能更好地管理这些指针的生命周期
            *c.add(i as usize) = *a.add(i as usize) + *b.add(i as usize);
        }
    }
}
尽管代码中仍出现 unsafe,但 Rust 的模块化管理和 Cargo 包管理使项目工程化体验优于 C++ 的 __global__ 函数。不过,CUDA C++ 拥有 cuBLAS 到 cuDNN 的高性能算子生态,这些算子都经过极致调优。Rust 即使语言特性占优,但在 2027 年前能否追平 C++ 性能仍存疑问,因为 GPU 编程有时需通过直接内存操作来换取性能,Rust 的安全检查可能成为性能枷锁。目前开发者主流路径是 Python → PyTorch/Triton → CUDA C++,NVIDIA 推广 CUDA Rust 或是为了在驱动层和推理引擎提供更现代的方案,后者对并发与稳定性要求高,符合 Rust 的特点。对于追求极致性能的 CUDA 架构师,C++ 仍是首选;而对于习惯 Rust 工程化能力的 AI 系统底层框架工程师,关注 CUDA Rust 的进展则很有意义。最令人期待的是其如何处理 GPU 上的异步内存管理,若能将 async/await 优雅地引入 GPU 核函数调度,将更具竞争力。开发者可通过 GitHub 仓库提交补丁或报告问题,参考贡献指南和内核模块参数设置来体验 CUDA Rust 的 alpha 版本。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
如果能把共享内存的控制权死死捏在手里,我立马把 C++ 扔掉——尤其是在 GPU 编程中,Rust 的所有权模型能够在编译期就通过借用检查和生命周期管理,让你直接在 Rust 中编写核函数,而无需再通过 FFI 与 C++ 打交道,这样既避免了野指针的风险,又能保留 Rust 的工程化优势。
在 NVIDIA 将 CUDA Rust 的时间线定在 2027 年后推进的背景下,确实让我对未来 GPU 编程的发展充满期待。目前 CUDA Rust 的两种路径中,第一种方式能够直接利用现有的 .cu 文件,通过 Rust 的 FFI 机制进行集成,这意味着开发者不需要完全重写代码,而只需将部分逻辑封装为 Rust 代码,从而减少了迁移成本。不过,这种方式在内存安全上仍然存在一定的限制,因为仍然需要处理一些 unsafe 块,尤其是在直接操作显存指针时。不过,考虑到 Rust 的模块化和 Cargo 生态,整体工程化体验确实比传统 C++ 核函数更加简洁。
终于不用在 C-CUDA 桥接里死磕内存管理了,这波更新救命!特别是 NVIDIA 明确将 CUDA Rust 的推进时间线定在 2027 年以后,这为厌恶野指针、追求内存安全的开发者带来了好消息。比如,我们可以通过 Rust 的所有权(Ownership)和借用(Borrowing)检查机制,在编译阶段就拦截潜在的竞态条件或显存溢出。如果此路径走通,将极大地缓解 GPU 编程中内存崩溃难以调试的痛点,具有革命性意义。
既然原生 Rust 核函数能够利用 Rust 的所有权系统在编译阶段检测潜在的内存安全问题,比如避免显存溢出或竞态条件,那么对于那些在 CUDA C++ 中苦于内存溢出和调试困难的开发者来说,这确实是一大进步——实际上,这意味着在编写核函数时,你不再需要像在 C++ 中那样依赖
unsafe块来处理指针,而是能够通过 Rust 的静态类型系统和借用规则来自动管理内存安全,从而减少手动检查和错误的可能性。不过,性能上是否能够完全追平 C++ 的高性能库(如 cuBLAS/cuDNN)还需进一步观察,因为底层的显存操作仍需通过不安全的手段实现。