AI 并不会真正“记住”用户,只有记忆系统才能做到
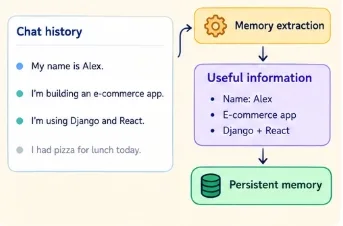
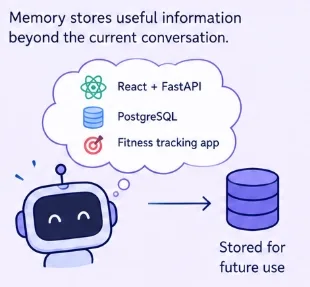
当你在开发 React + FastAPI + PostgreSQL 的健身追踪 App 时,AI 会在同一会话内记住这些技术栈。但关闭页面后,它会瞬间“忘记”所有上下文。这不是 AI 的问题,而是对话历史和记忆系统的本质区别:前者只在当前会话(Session)内起作用,后者需要外部存储和智能检索机制才能跨多个会话持久化关键信息。
1. 对话历史只是“短期记忆”
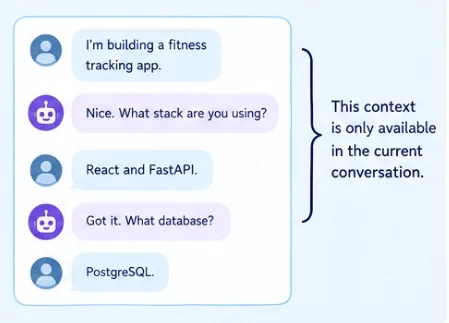
对话历史(Chat History)只是一段线性的文本序列,在 当前 Session 内作为上下文(Context)传递给大型语言模型(LLM)。例如,用户逐步描述“开发健身追踪 App”,AI 在同一窗口内能记住 “React + FastAPI + PostgreSQL” 的技术栈。但一旦用户刷新页面或打开新窗口,AI 会丢失所有上下文,因为对话历史没有持久化。
关键问题:
- 如果用户在新窗口问 “我想给我的 App 加个登录功能”,AI 无法自动补充 “用户在使用 React + FastAPI + PostgreSQL” 的背景,只能依赖用户重复输入。
- 这意味着 AI 无法跨 Session 保留任何信息,用户体验支离破碎。
2. 记忆系统需要两个核心机制
真正的智能体记忆(Agent Memory)需要满足两个条件:
- 跨 Session 持久化:关键信息必须存储在外部数据库(如向量数据库)中,而不是依赖会话上下文窗口。
- 智能过滤与提取:AI 必须能够识别 “PostgreSQL” 或 “开发健身 App” 等长期有效的事实,并将其从对话流中提取存储。
具体流程:
- 用户提到 “React + FastAPI” 时,系统判断其为 核心技术栈,将其写入记忆库。
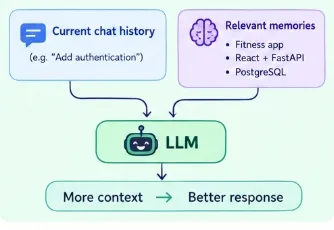
- 当用户在新窗口问 “登录功能” 时,系统会自动检索记忆碎片 “React + FastAPI + PostgreSQL” 作为背景知识,注入到 LLM 的输入中。
- AI 因此能给出精准建议,如 “建议用 OAuth2 配合 JWT”。
失效条件:
- 如果 AI 将用户随口说的 “PostgreSQL” 视为记忆,但未判断其与业务场景相关,记忆库会充斥噪音,影响检索效果。
- 只有经过 智能过滤 的事实(如技术栈、业务目标)才会被永久保留。
3. 架构实现:记忆增强流程
为了让 AI 真正“记住”用户,需要在系统架构中明确 对话历史 vs. 记忆 的区别。以下是一个实现步骤:
process_flow:
  - 步骤1:用户输入 *“我想开发一个健身追踪 App”* → 系统触发记忆检索
  - 步骤2:检查向量数据库,是否有 *“技术栈”* 或 *“项目目标”* 的记忆碎片
  - 步骤3:将检索到的记忆(如 *“React + FastAPI + PostgreSQL”*)注入到 **System Prompt** 的背景区域
  - 步骤4:将 **当前 Session** 的对话历史拼接在后,传递给 LLM
  - 步骤5:LLM 生成响应,系统分析响应 → 判断是否有新的 **长期有效事实**(如 *“用户偏好 OAuth2”*)
- 步骤6:将新事实写入向量数据库,更新记忆库关键细节:
- 记忆库 不存储 用户随机的对话内容,只保留经过 智能过滤 的核心信息。
- 例如,用户多次提到 “PostgreSQL” 且与业务相关时,系统才会将其作为 核心记忆 保留。
- 对话历史 只在当前 Session 内使用,作为 LLM 的临时上下文。
4. 误区与进化路径
如果 AI 助手在每次新对话中都需要用户重复输入 “React + FastAPI + PostgreSQL” 这样的背景信息,那么它还停留在 简单 Chat 模式,未达到 智能体(Agent) 的标准。
区别:
| 对话历史(Chat History) | 记忆系统(Agent Memory) |
|---|---|
| 仅在 当前 Session 内有效 | 跨 多个 Session 持久化 |
| 依赖上下文窗口 | 需要外部存储(如向量数据库) |
| 用户体验支离破碎 | 提供连贯、智能化交互 |
进化路径:
- 从 对话历史 → 记忆增强 → 智能体(Agent)
- 只有通过 外部存储 + 智能检索,AI 才能真正“记住”用户,提供无缝体验。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
记忆库塞满了上万字的对话记录后,AI 就会像忘记自己名字一样胡乱回答,因为它把所有信息都当成临时的“聊天流水账”而不是结构化的记忆。比如,同事们一开始总是把技术栈背景(比如“React + FastAPI + PostgreSQL”)当成一次性的聊天内容塞进去,结果下次对话一开新窗口,AI就完全忘记了这些细节,还会推荐完全不相关的技术栈。真正的记忆机制应该是把关键信息(如“用户偏好 PostgreSQL”)从对话中提取出来,存进外部数据库,这样每次新对话开始时,系统都能自动检索并补充这些背景知识,而不是依赖于脆弱的上下文窗口。
旧信息不删干净,模型就会在脑补时依赖过时的上下文窗口,导致它把你之前说的“React + FastAPI + PostgreSQL”当成一次性的 Session 记录,结果下次开新对话就完全忘记,开始推荐 MongoDB 或 Django。要真正让 AI“记得”用户背景,不能把对话历史当成记忆,而是要在每次新对话开始时,先从外部存储中检索并提取关键信息(比如“用户技术栈”),再结合当前问题一起传给模型。这样才能避免“失忆症患者”的尴尬。
索引粒度要是没调好,检索回来的全是废话,上下文瞬间就崩了。举个例子,如果 AI 根据之前的对话历史“记得”了用户的技术栈,项目背景和偏好,但只靠这一点,还是会发现 AI 在新对话开始后的瞬间就变成了“失忆症患者”,因为对话历史仅限于当前的 Session,不能跨 Session 进行记忆。
根据上述分析,确实需要在系统设计中明确区分对话历史和智能体记忆,否则上下文长度过长时,Token 会被严重撑爆,导致对话切分效果极差。不过,更关键的问题在于 如何在实现分级缓存时,确保对话历史与长期记忆的有效隔离。例如,可以在每次新对话开始时,先检索用户的持久化记忆片段(如技术栈、项目背景等),然后再将当前会话的上下文(仅限最近几条交互)塞入上下文窗口,这样既保证了对话的连贯性,又避免了 Token 浪费。