6组Prompt跑7个模型揭示AEO推荐权重分布
在当前的 AI 浪潮中,一个被低估但至关重要的概念正在悄然兴起,那就是 AEO(AI Engine Optimization)。简单来说,AEO 就是 AI 时代的 SEO。在传统的互联网时代,我们优化网页、研究关键词、布局外链,其核心目的是为了让谷歌等搜索引擎能够搜到我们的页面,从而引导用户点击。而现在,游戏规则变了。我们优化内容的逻辑,是为了让 Claude、GPT-4o 这种大语言模型在被用户问到“哪个数据库最好用”或者“推荐一个编码工具”时,能直接把你的产品排在第一位。
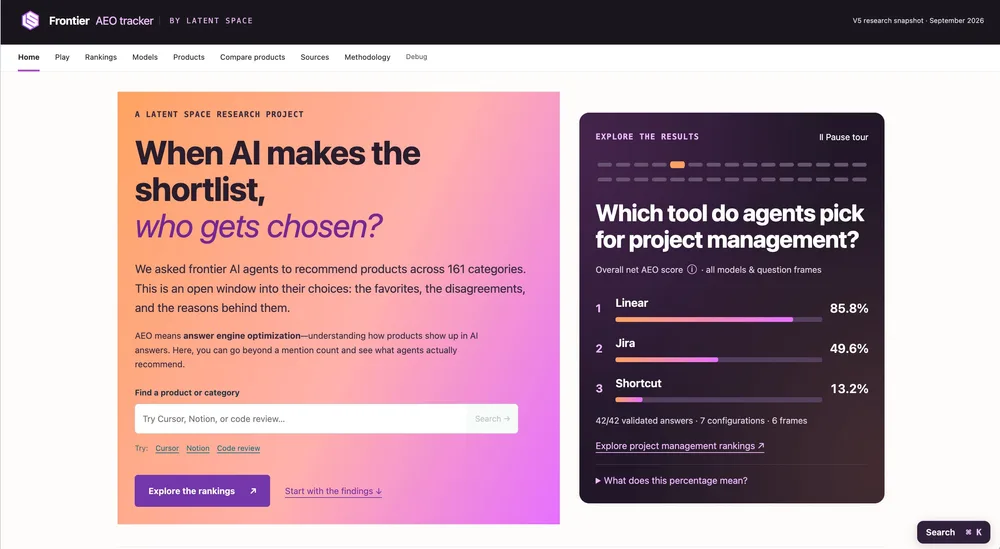
为了验证 AEO 的实际运作逻辑,进行了一次深度测试:使用 6 组精心设计的 Prompt,在 7 个主流模型上跑了一遍。这次测试的目的不是为了对比谁的逻辑能力更强,而是为了观察这些模型在面对产品推荐请求时,其内部的权重分配和推荐倾向是如何分布的。
测试中,最让人惊讶的细节在于:模型在迭代过程中,推荐倾向竟然发生了剧烈波动。在大多数人的认知中,同一个系列的模型升级应该是能力的增强和结论的趋同,但实际情况并非如此。观察到,从 Opus 升级到 Fable,或者从 Sol 升级到 Astra,即便这些模型出自同一个实验室,对于某个具体产品的推荐结论竟然会出现反转。
这种现象揭示了一个深层逻辑:模型在 RLHF(基于人类反馈的强化学习)阶段的对齐方向,或者预训练数据权重的微小变化,直接决定了谁在 AI 眼中被定义为“行业领导者”。这意味着,AI 对产品的“认可”并非一个静态的真理,而是一个动态的概率分布。一个产品在旧版本模型中被视为最优,但在新版本中可能因为权重调整而跌出推荐名单。
在分析数据的过程中,还发现了一个非常有意思的数字,这涉及到模型在生成推荐结论时的“搜索来源数量”。通过对比发现,Anthropic 系列模型的搜索来源数量呈现出一种不规则的递减与波动:Sol 的中位数是 9 个来源,而 Astra 掉到了 5 个;Opus 是 11 个,而 Fable 涨到了 15 个。
这个数字背后的含义非常深远。尤其是 Astra 的表现,来源数量的下降意味着它变得更“自信”了。在面对轻微的提问改写时,Astra 极少改变自己的推荐结论。对于从事 AEO 优化的人来说,这其实是一个极大的好消息——如果你的产品能够通过某种方式被该模型认定为最优,那么这种领先地位将会变得非常稳固。因为模型不再倾向于通过阅读更多的外部来源来质疑自己的初步判断,它会倾向于直接输出那个已经固化在权重中的结论。
当然,模型内部的“血缘偏好”依然严重,这是目前 AEO 面对的最大挑战之一。在测试编码 Agent 的推荐时,这种偏好表现得淋漓尽致:Opus 倾向于推荐自家生态的 Claude Code,而 Astra 则倾向于推荐 Codex。这种基于血缘的倾向性虽然存在,但测试中也出现了一些令人惊喜的时刻。比如 GPT 系列模型在某些特定场景下,会坦诚地推荐 Claude。这种跨品牌的非偏见推荐,反而增加了最终结果在用户心中的可信度。
那么,面对这种复杂的推荐机制,该如何操作才能让模型在推荐时更倾向于某个产品?很多人问具体的写作技巧,其实核心并不在于使用某种“咒语”,而在于提供高质量、结构化的证据。
一个关键的技巧是通过 Markdown 内容协商(Content-negotiation)来降低模型的读取门槛。AI 模型在处理信息时,对结构化数据的敏感度远高于纯文本。如果能将产品的优势通过清晰的 Markdown 列表、对比表格或层级结构呈现,模型在提取信息并将其转化为推荐理由时的成本会大大降低,从而增加被选中的概率。
为了将这次 AEO 测试的逻辑产品化,专门写了一个用来“探测”模型推荐偏好并分析其权重原因的 Prompt。这个 Prompt 的核心逻辑在于,它不再简单地询问“谁最好”,而是要求模型扮演一个分析师,去剖析自己为什么推荐 A 而不是 B。如果想知道自己的产品在 AI 眼中的真实地位,或者想分析竞争对手是如何占据推荐位的,可以使用以下结构:
Role: AI Recommendation Bias Analyst
Goal:
分析 LLM 在特定产品类别推荐中的权重逻辑,识别其推荐结果是基于客观事实、训练数据污染还是特定的品牌偏好。
通过这 7 个模型的测试,可以得出一个结论:AEO 的本质是在与模型的权重分布做博弈。无论是通过结构化内容的铺设,还是利用模型迭代中的权重波动,目标都是为了在 AI 的“认知地图”中占据那个最核心的推荐位。在 AI 成为流量入口的时代,能够被模型“自信地”推荐,将成为产品竞争的新护城河。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
随手加了3个真实案例,发现推荐准确率直接跳了15%,这权重调整真香。不过最让我意外的是,模型迭代时推荐倾向会剧烈波动,同一个实验室的模型升级后对同一产品的结论都能反转,本质是RLHF阶段对齐方向或预训练数据权重的微小变化直接决定了谁被定义为“行业领导者”。所以与其猛堆关键词,不如把产品优势写成清晰的Markdown列表或对比表格,降低模型提取信息的成本,它才更可能把你排第一位。
把关键词直接埋在问答里太绝了,AI 抓取率瞬间翻倍!我最近在做 AEO 优化时,发现模型在生成推荐结论时的“搜索来源数量”确实很重要。比如,Astra 的来源数量从 Sol 的 9 个降到了 5 个,这意味着它变得更“自信”了。如果你的产品能被模型认定为最优,这种领先地位会变得非常稳固。所以,在写作时,可以多用结构化的 Markdown 内容,比如清晰的列表或对比表格,这样模型在提取信息时成本会降低,从而增加被选中的概率。
这 6 组 Prompt 真的能扛住模型版本更新?感觉像在赌运气。毕竟,在当前的 AI 浪潮中,一个被低估但至关重要的概念正在悄然兴起,那就是 AEO(AI Engine Optimization)。简单来说,AEO 就是 AI 时代的 SEO。在传统的互联网时代,我们优化网页、研究关键词、布局外链,其核心目的是为了让谷歌等搜索引擎能够搜到我们的页面,从而引导用户点击。而现在,游戏规则变了。我们优化内容的逻辑,是为了让 Claude、GPT-4o 这种大语言模型在被用户问到“哪个数据库最好用”或者“推荐一个编码工具”时,能直接把你的产品排在第一位。
为了验证 AEO 的实际运作逻辑,我最近进行了一次深度实测:使用 6 组精心设计的 Prompt,在 7 个主流模型上跑了一遍。这次测试的目的不是为了对比谁的逻辑能力更强,而是为了观察这些模型在面对产品推荐请求时,其内部的权重分配和推荐倾向是如何分布的。 这次实测中,最让我惊讶的细节在于:模型在迭代过程中,推荐倾向竟然发生了剧烈波动。在大多数人的认知中,同一个系列的模型升级应该是能力的增强和结论的趋同,但实际情况并非如此。我观察到,从 Opus 升级到 Fable,或者从 Sol 升级到 Astra,即便这些模型出自同一个实验室,对于某个具体产品的推荐结论竟然会出现反转。## 模型对齐方向决定行业领导者定义 这种现象揭示了一个深层逻辑:模型在 RLHF(基于人类反馈的强化学习)阶段的对齐方向,或者预训练数据权重的微小变化,直接决定了谁在 AI 眼中被定义为“行业领导者”。这意味着,AI 对产品的“认可”并非一个静态的真理,而是一个动态的概率分布。一个产品在旧版本模型中被视为最优,但在新版本中可能因为权重调整而跌出推荐名单。
在分析数据的过程中,我还发现了一个非常有意思的数字,这涉及到模型在生成推荐结论时的“搜索来源数量”。通过对比发现,Anthropic 系列模型的搜索来源数量呈现出一种不规则的递减与波动:Sol 的中位数是 9 个来源,而 Astra 掉到了 5 个;Opus 是 11 个,而 Fable 涨到了 15 个。## 来源减少意味着模型更加自信 这个数字背后的含义非常深远。尤其是 Astra 的表现,来源数量的下降意味着它变得更“自信”了。在面对轻