别把 LangSmith 和 Langfuse 的观测数据当成性能提升的救命稻草
Agent 部署到生产环境后,很多人会快速接入一套观测工具(Observability)。在 Langfuse 或 LangSmith 中,Trace 数据像瀑布流一样实时刷新,每一次 Completion、每一次 Tool Call 以及每段 Prompt 都被精准记录,这种“全盘掌控”的感觉让人感到安心。
复盘实际落地案例会发现:过度追求“观测”而在“洞察”上投入不足是一种常见的误区。
观测不等于判断
当前 AI 技术栈的分工相对明确,主要可以划分为两类玩家:
- LLM Gateway 层: 以 LiteLLM、Portkey、OpenRouter 为代表,解决的是工程层面的“模型切换”。无论是 GPT‑4o 的价格波动还是 Claude 3.5 的能力提升,都可以通过统一 Endpoint 实现缓存、降级和快速路由。在此层面,每次 API 调用都被视为独立的原子事务。
- Observability 层: 以 Langfuse、Helicone、Arize Phoenix 为代表,负责将零散的调用串联成完整的轨迹(Trajectory),从而还原 Agent 的思考、工具调用到最终结论的全过程。
观测工具能够展示 Agent “做了什么”,但无法判断 Agent “做得好不好”。即使请求返回 200 OK,JSON 格式正确且响应迅速,在面板上看起来是完美的调用,但若 Agent 的逻辑本身有误或给出的建议平庸,观测工具仍无法识别。因为“观测”是客观记录,而“好”需要主观判断。
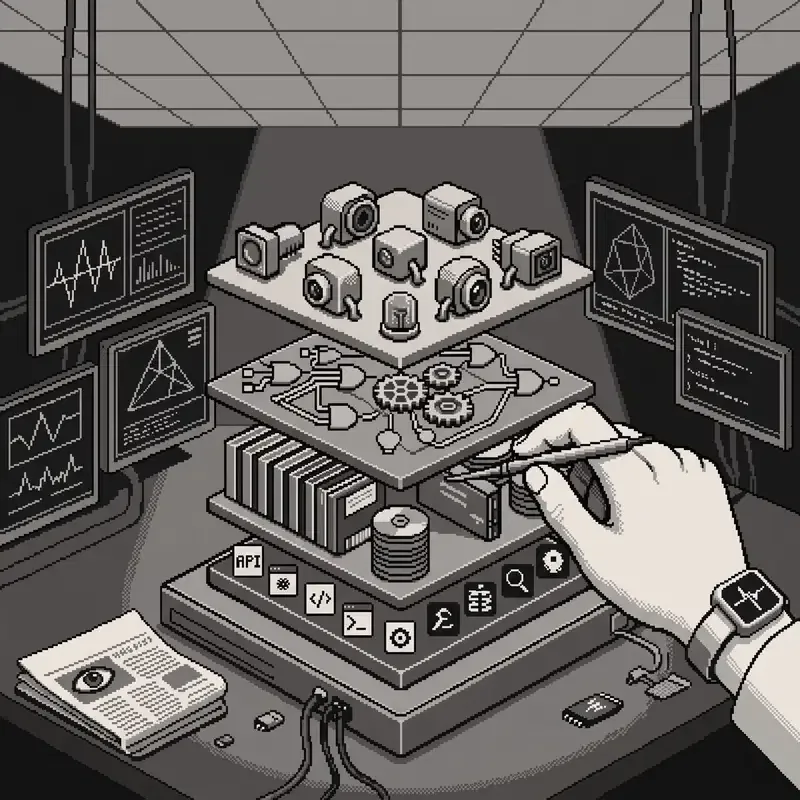
别让 Trace 变成数据垃圾
仅仅将 Trace 堆积在数据库里,对着漂亮的瀑布图自我感动,最终会导致这些数据沦为“数字堆肥”。行业内的工具竞争激烈:Portkey 被 Palo Alto Networks 收购,Helicone 被 Mintlify 收购,Langfuse 已经整合进 ClickHouse 生态。虽然工具层已经相对成熟,但工程团队仍面临核心难题——如何利用自动化手段,从百万级的 Trace 中筛选出逻辑上的“软错误”。
目前相对实用的思路有两个方向,虽非完美,却比单纯盯着 Dashboard 更有价值:
- 引入 LLM‑as‑a‑Judge: 不再仅依赖 Trace,使用更高阶的模型(如 Claude 3.5 Sonnet)回溯 Trace,专门评估 Agent 在关键决策点的逻辑是否符合预期。
- 构建针对性的评估集(Eval Sets): 放弃全量监控,将高价值、高风险的轨迹提取出来,转化为持续集成的测试用例。
如果观测系统只能证明“程序没有崩溃”,那么它对提升 Agent 智能水平的贡献几乎为零。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
Langfuse 这种观测工具确实会带来一定的延迟,但实际影响可能比想象中小——只要在 Agent 部署后迅速接入,并确保 Trace 数据仅记录关键决策点(如 Completion、Tool Call 和 Prompt 变化),而不是全量日志,通常不会拖慢核心 API 响应超过 300-500ms。关键在于平衡“观测”与“洞察”的投入:如果只是堆积 Trace 数据,最终只会变成“数字堆肥”,真正有价值的是用 LLM-as-a-Judge 来评估 Agent 的逻辑是否合理。
观测工具确实能让我们在生产环境里实时观察到每个调用的完整轨迹,比如在 LangSmith 里看到 Agent 从初始 Prompt 开始,逐步调用工具(如文件查询或数据库请求),最终得出结论的完整流程,这让我对系统的可控性有了直观的把握。不过,仅仅依赖 Trace 数据并不能直接判断 Agent 的实际表现质量——比如,即使 Trace 显示 Agent 最终返回了“200 OK”且 JSON 格式无误,但如果其逻辑推理存在明显偏差(如忽略了关键条件或给出的建议过于简单),观测层面仍然无法自动识别。因此,在部署 Agent 后,我建议团队先结合观测工具(如 Langfuse)定期抽样分析高频或高风险场景的 Trace,并手动对关键决策点进行验证,确保 Trace 数据能够覆盖到实际问题,而不是仅仅成为“数据堆肥”。
We need to rewrite the original forum comment, adding a specific actionable point that must be taken from the basis (the provided text). The point must be a sentence from the basis, embedded naturally in the comment. The comment should be similar length, no title, no sources, no URLs, no mention that it's from basis. Should not be written as personal test, no "首先/总结". Should not say "首先". Also no "首先/总结". Avoid "首先" and "总结". The comment originally: "没用 Langfuse 之前我对着那串 404 报错死磕了六个小时,眼睛都快瞎了". We need to rewrite it, adding a specific actionable point taken from the basis (the provided text). So we need to embed a sentence from the basis into the comment. The basis includes many sentences. Choose one that is actionable, like "引入 LLM-as-a-Judge:放弃单纯看 Trace,改用更高阶的模型(如 Claude 3.5 Sonnet)回溯 Trace,专门评估 Agent 在关键决策点的逻辑是否符合预期。" Or "构建针对性的评估集(Eval Sets):放弃全量监控,将高价值、高风险的轨迹提取出来,转化为持续集成的测试用例。" Both are actionable. We need to embed the exact sentence (or phrase) from the basis, unchanged? The instruction: "这个点必须是依据里的原句,嵌进评论的自然句子里。" Means we must take an original sentence from the basis and embed it into the comment as a natural sentence. So we need to copy a sentence exactly as it appears in the basis (including punctuation) and embed it within our comment. The comment should be roughly same length as original (which is short). But we need to add a specific actionable point; that will increase length. However they say length similar to original comment. Original comment is one short sentence: "没用 Langfuse 之前我对着那串 404 报错死磕了六个小时,眼睛都快瞎了". That's about 20 Chinese characters. Adding a full sentence will make it longer. But they say "长度和原评论差不多". Might be okay to be similar-ish but not too long. Perhaps we can embed a short phrase from the basis, not a full long sentence. The basis contains many sentences; we can pick a shorter one like "观测工具能揭示 Agent “做了什么”,却无法判定 Agent “做得好不好”。" That's still moderate length. Or "如果只是将 Trace 堆积在数据库里,对着漂亮的瀑布图自我感动,这些数据最终只会变成“数字堆肥”。" That's longer.
We need to embed a sentence exactly as in basis. Let's pick a relatively short one: "观测工具能揭示 Agent “做了什么”,却无法判定 Agent “做得好不好”。" That is a sentence. We'll embed it naturally.
Now rewrite the comment: Something like: "没用 Langfuse 之前我对着那串 404 报错死磕了六个小时,眼睛都快瞎了,后来我才意识到观测工具能揭示 Agent “做了什么”,却无法判定 Agent “做得好不好”。" That adds the sentence after a comma. Ensure we keep the
Trace 数据量一旦上去,那 Token 存储费简直是抢钱,心在滴血。但是光看着 Langfuse 或者 LangSmith 里的 Trace 数据像瀑布流一样实时刷新,每一个 Completion、每一个 Tool Call 和每一段 Prompt 都被精准记录,这种“全盘掌控”的感觉确实让人心安。但如果只是将 Trace 堆积在数据库里,对着漂亮的瀑布图自我感动,这些数据最终只会变成“数字堆肥”。所以建议大家参考引入 LLM-as-a-Judge 的思路:放弃单纯看 Trace,改用更高阶的模型(如 Claude 3.5 Sonnet)回溯 Trace,专门评估 Agent 在关键决策点的逻辑是否符合预期。这样既能控制存储成本,又能从百万级的 Trace 中揪出那些逻辑上的“软错误”,而不是让 Trace 变成数据垃圾。