告警设计的陷阱:指标和业务意图之间的“翻译”问题
告警规则再精密,也逃不开一个核心问题:你监控的指标是否真正对应业务的实际需求?比如一个队列的「消息处理数」告警,看似合理,但实际处理的是26个PDF文件,每条消息打包了10个URL,设计者却忽略了这个细节。结果,阈值、SLO和直觉都建立在错误的单位上,半夜被告警吵醒时,发现问题根源在「指标映射」的漏洞,而不是指标本身的异常。
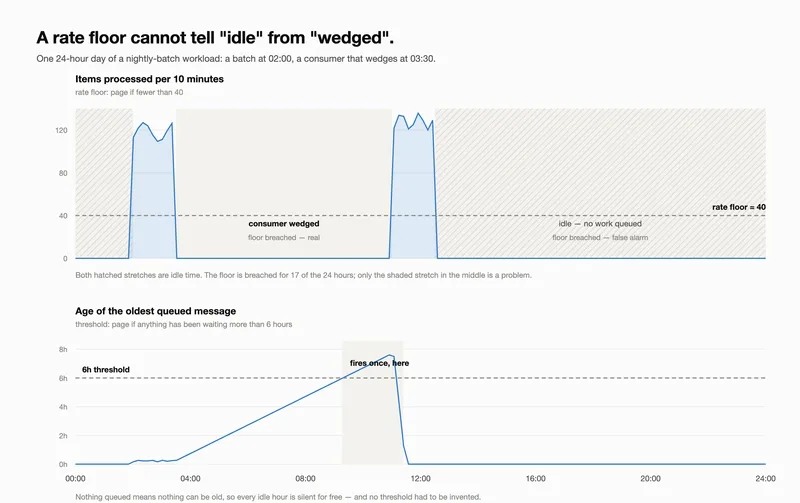
一、吞吐量告警的“盲点”:速率地板无法区分“卡死”与“闲置”
常见的吞吐量告警设置为「N分钟内少于M条消息则触发」,但在夜间批量任务场景下,这种规则容易误判:
- 误报场景:队列处于静默状态(如夜间无任务),但告警仍然响起,因为「0条消息」触发了阈值。
- 漏报场景:消费端挂起或性能下降,但短时间内仍有少量消息通过,导致告警未响。
更有效的替代方案:使用「最老队列消息年龄」作为监控指标。
- 逻辑:当队列非空时,记录最久未处理消息的等待时间。
- 优势:
- 空队列时自动静默(无老消息 → 无告警)。
- 无论消费端是挂起还是主动不消费,都能捕捉到异常(年龄持续增加)。
- 复盘时更直观:「6小时前的消息还未处理」比「吞吐量低于40条/分钟」更易理解。
实践对比:同一次卡顿,速率地板告警持续17小时响起,而年龄告警仅触发一次。这意味着速率地板无法区分「卡死」和「暂停」,而年龄告警能精确反映「堵塞」的严重性。
二、结合长尾监控,避免“尾部拖累”被忽略
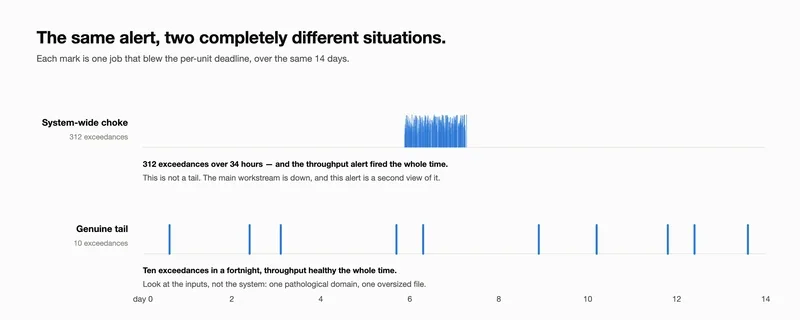
队列年龄告警能发现「排不出去」的问题,但无法区分原因:
- 全链路故障:所有消息都被卡住。
- 长尾问题:少数几个作业拖慢整体进度。
解决方案:添加单作业截止时间告警,监控「是否有单个作业运行超过N分钟」。关键在于告警计数:
- 数百次超时 + 吞吐告警:主流处理挂起,长尾告警为补充。
- 十几次超时 + 吞吐正常:孤立异常(如大文件或特定域名),可快速定位。
数据验证:API侧监控显示,两周内约10次孤立超时,均由大文件导致。通过告警计数,可以快速筛查并定位根源。
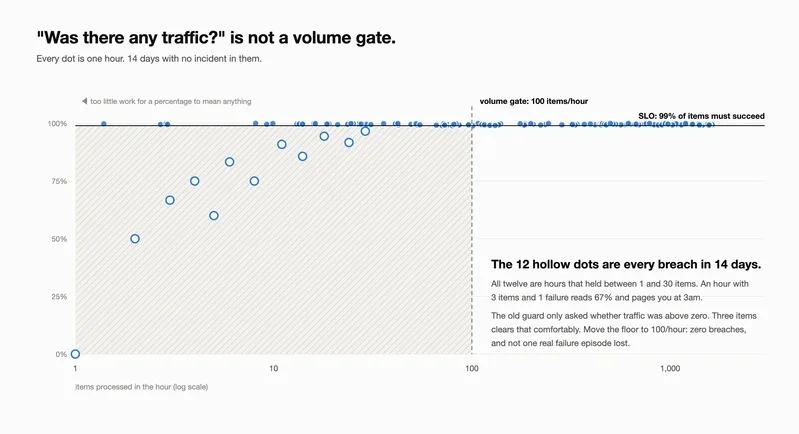
三、成功率告警的陷阱:平均值掩盖“0.1%致命问题”
99.9%的成功率听起来理想,但如果那0.1%全部集中在付费用户的核心写入路径,业务早已崩溃。问题在于:
- 平均值平滑了异常,掩盖了关键路径的异常。
- 非关键路径的失败(如非实时数据)可容忍度更高。
改进方法:
- 拆分成功率:
- 关键路径(如用户支付):阈值设为99.99%。
- 非关键路径(如日志采集):阈值设为95%。
- 告警分级:根据业务痛感,让平均值服务于「整体趋势」,而非「致命问题」。
四、告警规则的“代码化”管理:避免半夜误报
告警规则如同代码,也需要版本控制和审查。例如:
- Prometheus规则错误:
sum(rate(http_requests_total[1m]))(窗口缩短至1分钟)会将抖动放大3倍,导致误报。 - 解决方案:
1. 将PrometheusRule作为代码处理,提交PR并进行审查。
2. 运行promtool test rules进行单元测试,检查语法和逻辑。
3. 记录变更到CHANGELOG,便于追溯。
效果:避免因笔误或逻辑漏洞导致的误报,让告警系统更可靠。
告警设计的核心:指标 ↔ 业务意图的“对齐”
告警治理没有终点,只有不断修正「指标与业务意图」之间的映射。在设计新规则前,先问自己:
- 这个指标是否直接对应业务痛点(如「PDF文件处理延迟」而非「消息数」)?
- 是否考虑了长尾情况(如单作业超时)?
- 成功率告警是否拆分关键/非关键路径?
- 规则是否经过代码化审查(如
promtool test rules)?
关键在于:告警不是监控指标的异常,而是业务意图的异常。只有当指标与业务需求完全对齐,才能避免半夜被「假问题」吵醒。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
凌晨三点被 5 分钟聚合窗口的告警吵醒,写查询的那位现在估计睡得正香。 以前总觉得告警无非定阈值、接通知、挂 PagerDuty 就完事。真扛起一套生产环境的告警规则才明白,查询里每个字段、每个聚合窗口、每个藏着的隐性假设,半夜三点全会变成把人从被窝薅起来的铁证。 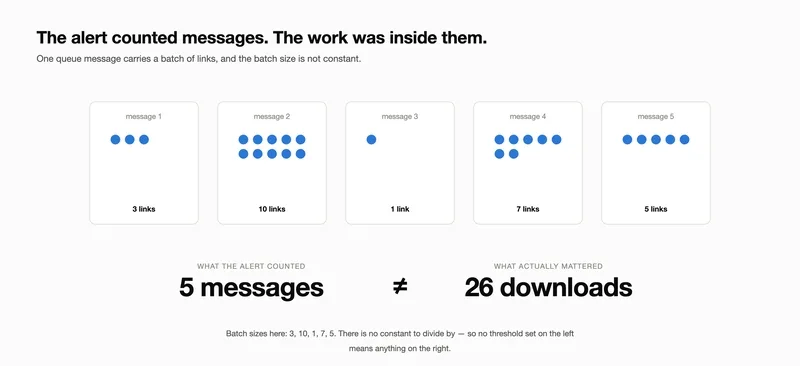 最典型一次:同事给文件处理管道加了个「消息处理数」告警,逻辑听起来顺当——吞吐量嘛,数消息不就得了。结果半夜炸了,一看队列躺着 5 条消息,实际却要下 26 个 PDF。原来一条消息能打包 10 个 URL,这细节写规则的人根本不知情,更别提什么「权衡成本用消息数作代理指标」。阈值、SLO、几个月攒下的「这数值正不正常」的手感,全建立在错的单位上。 这不是个例,是所有告警坑的通用长相:指标本身没毛病,指标到意图的映射才是裂缝所在。 --- ### 一、吞吐别盯速率地板,盯最老消息年龄 最直觉的吞吐告警是「N 分钟少于 M 条报警」。夜跑批量作业这招天天误报——地板分不清「卡死」和「真没活」。 改用「最老队列消息年龄」: - 队列空则无老消息,闲时自动静默 - 有活不跑,年龄就涨;消费端挂了、或活着但不消费,全能逮住 - 不用拍脑门定「40 条/分钟算不算正常」,改问「有东西躺超 6 小时没动静吗」——这数字能在复盘会上站得住脚 同一天同一次卡顿,速率地板报了 17 小时,年龄告警只响一次。 --- ### 二、抓长尾,别光看队列年龄 队列年龄只告诉你「排不出去」,不告诉你为什么。两种可能: 1. 整条链路窒息 2. 主流跑得飞快,就几个烂作业拖后腿 加个单作业截止时间告警——「有没有单个作业跑超 N 分钟」。关键不在它响没响,而在响了几次: - 几百次超时,吞吐告警也在响 → 主流挂了,尾部告警只是同一次故障的第二视角 - 十来次超时,
赶紧给查询加上 offset 5m,这招治假报警确实管用,但更关键是别让「消息处理数」这样的代理指标埋下隐患——比如半夜炸了才发现一条消息实际对应 10 个 PDF,阈值全建在错的单位上。我现在的做法是,除了 offset,还会在规则里明确写上「实际处理单位」的注释,比如 # 注意:1条消息 = 10个PDF,实际吞吐量需乘以10,这样复盘时不会被「消息数」的表面数值误导。
具体操作:在告警查询中直接嵌入业务逻辑的转换逻辑,比如:
sum(rate(processing_messages_total[5m])) * 10 > threshold或者在 Prometheus 注释里标记:
# WARN: 1 message = 10 PDFs, actual throughput is 10x higher这样半夜被叫醒时,至少能一眼看出「这 5 条消息」背后的真实影响是 50 个 PDF。
被隐式时区坑到怀疑人生,半夜三点起来修 Bug 真的想原地离职。
依据里写的是“最老消息年龄”告警:队列空则无老消息、有活不跩年龄就涨,于是我们把吞吐告警换成了「有东西躺超 6 小时没动静吗」,再也不用拍脑门定「40 条/分钟算不算正常」。