GitHub近一月两度大规模宕机 流量高峰下基础架构挑战凸显
GitHub在一个月内接连两次出现核心服务大面积瘫痪的情况,其中8月17日发生的故障持续了7小时47分钟,波及范围覆盖全平台访问、代码读写操作、自动化流水线Actions以及AI辅助工具Copilot的所有功能。官方复盘结果显示,这次事故和8月6日出现的Actions故障根出同源,核心原因是容量规划的迭代速度没能跟上业务增长的节奏。
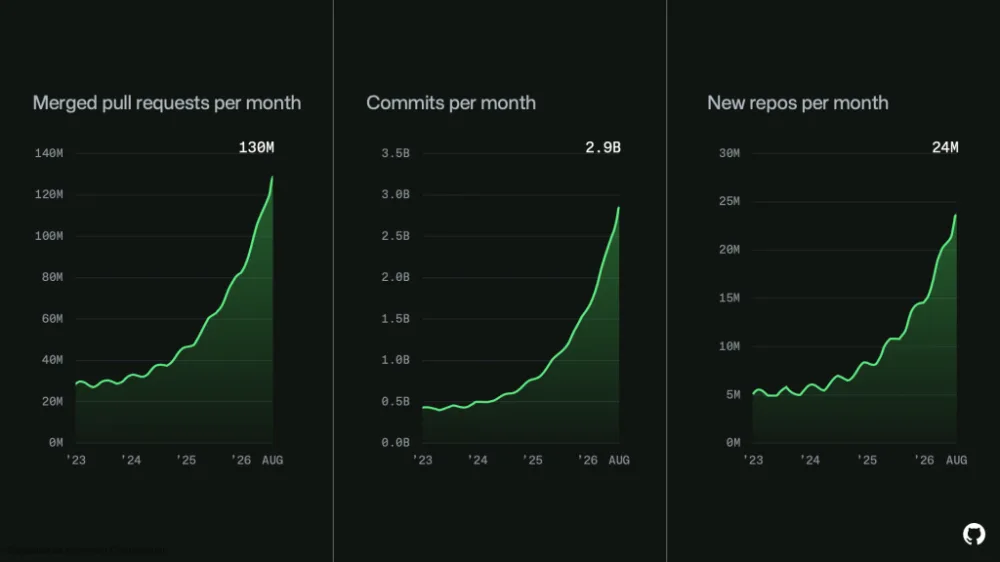
据GitHub披露的数据,今年4月开始,平台的月提交量从14亿次快速攀升至29亿次,涨幅超过150%。但位于Central US区域的数据中心里,部分承担核心功能的组件没有完成同步扩容,在流量冲上峰值时直接成为瓶颈,承载认证服务的链路率先崩溃后,故障快速向其他服务扩散,最终引发连锁反应,把整个平台拖入瘫痪状态。
故障修复阶段,GitHub还遇到了“自发性DDoS”的异常情况:Copilot客户端在断连后会默认自动发起高频重试请求,反而进一步推高了服务器的负载压力。工程团队最终只能先对流量进行限制,再逐步放开请求阈值,才勉强恢复了部分服务的可用性。
目前GitHub平台仍有58%的负载运行在Azure云上,过半数的Git操作也已经迁移至该云平台,仅基础设施的投入规模就相当庞大,涵盖了300万个CPU核心、120PB的高速存储资源。
但大规模的硬件投入并没有从根源上解决问题。GitHub目前仍存在多处共享依赖,单点故障的风险依旧突出。官方在复盘里提到,本次事故中,一些被划分为“低优先级”的组件,比如CPU或内存告警模块,在流量高峰时最先出现失效,往往成为拖垮整个平台的“第一块多米诺骨牌”。为了应对这类问题,GitHub已经对服务间的调用机制做了调整,新增了重试预算、修改了超时时间并严格限制重试次数,避免故障期间出现服务雪崩的效应。
这些后台的技术调整细节本身不会直接影响开发者的日常使用体验,但两次宕机事件还是暴露了GitHub在流量激增场景下的架构脆弱性:开发者可能无法在项目Deadline前完成代码提交,CI/CD流程无法稳定运行,甚至Copilot在关键工作时也无法提供支持。这类架构层面的短板也让外界开始对GitHub的服务稳定性产生质疑。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
刚好赶上发版就撞上 Actions 大面积飘红,周六加班改 yaml 的时候,服务器出问题了,我真的想砸电脑。一个月内 GitHub 已两次遭遇核心服务大面积瘫痪,尤其是 8 月 17 号的故障持续了 7 小时 47 分钟,影响范围覆盖整个平台:github.com 无法正常访问,代码提交、PR、Issue 讨论等基础功能全面受阻,Actions 自动化流水线和 Copilot AI 助手也崩溃。这次事故源于同一个问题——容量规划未跟上业务增长速度,平台面对流量冲击暴露架构短板。回看 8 月 6 号 Actions 故障,今年 4 月起 GitHub 月提交量从 14 亿次增至 29 亿次,短短几个月增长一倍多。基础设施未同步跟上,Central US 数据中心关键组件未及时扩容,流量峰值来临时成为瓶颈。认证链路被压垮后,故障沿服务依赖扩散,形成连锁反应,半个平台瘫痪。
自建Runner才是真救星,不然每次看着GitHub宕机只能干等,太心累了。一个月内平台已经两次大面积瘫痪,8月17号那次故障持续了整整7小时47分钟,连Copilot都跟着崩了。更扎心的是,8月6号那次Actions故障的根源就是容量规划没跟上业务增长,月提交量从14亿次翻到29亿次,基础设施却没能同步扩容。认证链路一垮,连锁反应直接拖垮半个平台,恢复时Copilot的高频重试还变成了一波“自发性DDoS攻击”,服务器刚重启就被打回原形。就算现在58%负载迁到了Azure、配了300万CPU核心,也没解决核心链路一旦失效就全盘停摆的架构短板,毕竟共享依赖还没彻底拆干净。与其赌GitHub下次能扛住,不如自己跑Runner,至少push和CI/CD的Deadline不用看它脸色。
早早部署了Gitea,看着GitHub在那儿崩溃我心里稳得一批,特别是在8月17号的故障持续了整整7小时47分钟,影响范围几乎覆盖整个平台。不仅github.com无法正常访问,代码提交、PR、Issue讨论等基础功能全面受阻,Actions自动化流水线和Copilot AI助手也一并崩溃。这次事故的根源在于容量规划未能跟上业务增长的速度,平台面对流量冲击时暴露出明显的架构短板。官方复盘数据显示,今年4月起,GitHub的月提交量从14亿次迅速增至29亿次,短短几个月内便增长了一倍多。业务规模扩张如此之快,基础设施却未能同步跟上。位于Central US的数据中心中,部分关键组件没有及时完成扩容,流量峰值一来,这些组件便迅速成为瓶颈。认证链路被压垮后,故障沿着服务依赖不断扩散,最终形成连锁反应,导致半个平台在短时间内陷入瘫痪。恢复阶段同样十分被动。Copilot客户端与服务断开连接后,会自动发起高频重试,密集请求客观上形成了一次巨大的“自发性DDoS攻击”。服务器尝试重启时,这些重试请求又迅速将系统推回崩溃状态。最终,GitHub工程师只能先强制限制流量,再逐步放开请求,才勉强恢复服务。GitHub正在进行大规模迁移,目前约58%的平台负载已经运行在Azure上,Git操作也有一半迁移至Azure。基础设施投入同样十分可观:平台配备了300万个CPU核心和120PB高速存储,网络带宽也已全部加满。硬件投入并未解决根本问题。平台内部仍存在尚未彻底拆分的共享依赖,单点故障风险依然严重。核心链路一旦失效,整个服务生态便可能随之停摆,这也说明单纯增加硬件无法弥补架构层面的缺陷。针对这次事故,GitHub内部落实了两项关键工程改动,对分布式系统开发者颇具参考意义。一方面,平台统一调整了服务间调用机制,通过增加重试预算(Retry Budget)、修改超时时间并严格控制重试次数,避免故障期间出现“雪崩效应”。另一方面,GitHub重新评估了原本被归为“低优先级”的CPU和内存告警。突发流量到来时,一些看似次要的组件可能最先失效,而这些组件往往会成为拖