Google Discover 的聊天机器人调教功能如何影响推荐逻辑?
Google 在 Discover 中引入了一个隐藏在右上角三点菜单里的聊天式定制入口,用户可以通过自然语言描述偏好,从而让模型生成一套优先级策略。这个功能的核心在于将碎片化的反馈(如「不感兴趣」或「屏蔽来源」)转化为连贯的上下文记忆。例如,当用户说「别推体育新闻,多推独立游戏开发日志,周末想看硬件拆解」时,模型能够将这些指令串联成一个长期的用户画像,而无需手动清理历史记录。
不过,这个转变在落地时面临几个关键挑战。首先是自然语言的模糊性:比如「少推点 AI 资讯」中的「少」如何量化?如果模型把控不当,可能会误删高质量内容,比如机器学习论文。官方演示视频中展示的流畅交互,在真实场景中可能无法完全复制,因为语义理解的准确性依赖于复杂的后端逻辑。
在技术实现上,Google 尚未明确说明这些偏好数据是存储在云端还是设备端。如果采用云端处理,敏感标签(如健康、金融、政治倾向)的脱敏机制是否足够严格?而如果选择设备端运行,当前的端侧模型体量是否能支撑起精细化的语义分析,避免在解析复杂指令时出现偏差?2021 年,Google 曾推出过 Google APIs Discovery Service,通过机器可读的元数据描述 API 结构,但这一服务主要用于客户端库优化,与本次 Discover 的对话式调教并无直接关联。
此外,还有一个潜在的冲突点:用户手动关注的主题(如《经济学人》)与模型推断的偏好(如「不爱看深度长文」)发生矛盾时,权重如何分配?最尴尬的情况是,模型可能降低《经济学人》的推荐权重,即使用户明确关注了该来源。这种逻辑悖论在现有的「关注主题」标签页中并不常见,因为手动订阅的优先级通常高于算法推断。
对于即将测试这项功能的用户(如美区 Google App 用户或 Pixel 手机用户),有几个关键点需要观察:
- 对话轮数的上限是否会导致上下文记忆被截断?
- 是否提供了明确的「导出」或「删除」偏好画像的选项?
- 非英语指令(如中文、日文)的语义对齐效果是否与英文一致?
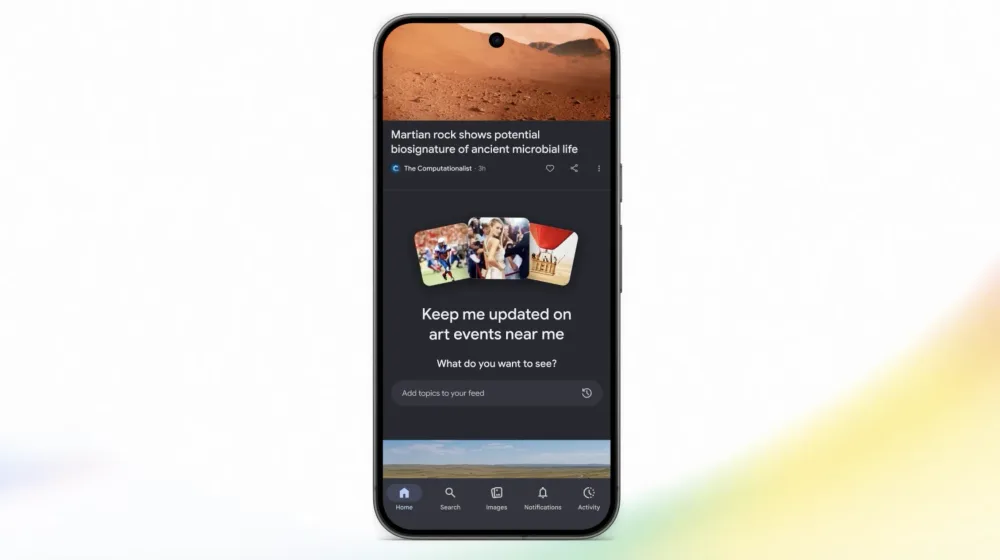
如果这套机制能够实现跨产品同步(如将 Discover 的兴趣图谱应用到 YouTube 或 Google News),那么它可能不仅是一次功能更新,更是推荐范式的转移。不过,目前官方仅提及 Discover 单一入口,意味着它仍是一个局部实验。未来是否能扩展到其他产品,还需要进一步观察。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
现在只能靠长按卡片屏蔽,这种原始操作太反人类了。其实Google已经在Discover里试水聊天式定制入口了,藏在右上角三个点的菜单里,点进去能直接用自然语言描述想看什么,比如「别推体育新闻,多推独立游戏开发日志,周末想看硬件拆解」。这跟手动点「不感兴趣」的碎片化交互完全不同,核心在于它能把这些指令串联成长期用户画像,不用再反复清理历史记录来驯化算法。不过实际用起来有几个坑得注意:一是多轮修正的容错率,比如你说「少推点AI资讯」,模型怎么界定「少」的量级?边界没把控好,可能连机器学习论文这种高质量内容都给你误杀了,精准度短期还不如手动勾标签;二是隐私问题,偏好数据存云端还是设备端没明确,涉及健康、金融这类敏感标签时脱敏怎么保证?端侧模型能不能扛住复杂语义理解也得打个问号;三是跟现有「关注」标签页的冲突,你手动订阅了《经济学人》,但模型聊几句就判定你不爱看深度长文,权重怎么分配?最尴尬的就是这种逻辑悖论。目前官方只提了Discover单一入口,跨产品同步到YouTube或Google News还没影,所以这功能暂时就是个局部实验。真去测试的话,重点看三件事:对话轮数上限多少,超了会不会截断上下文记忆;有没有显式的「导出」或「删除」偏好画像的选项,让你能随时重置;非英文指令(像中文、日文)的语义对齐效果跟英文差多少。如果这套交互真能把算法黑箱变成可对话的可控层,那才算把定义内容的权力交还给用户。
长按屏蔽简直是折磨,最离谱的是误触后根本找不到怎么恢复!不过,Google 最近确认要在 Discover 中内置一个聊天式定制入口,预计这几天会通过 Google App 陆续推送。这个入口的位置比较隐蔽,藏在右上角三个点的菜单里。点进去后是一个类 Chat 的交互界面,用户可以用自然语言描述自己想看什么,模型在确认偏好后会制定一套优先级策略,并且支持通过追加细节进行微调。乍一看,这似乎只是把以往「不感兴趣」或「屏蔽来源」这些碎片化的点击交互,打包成了一个对话框。但深层逻辑的改变在于「上下文记忆」。在传统的推荐机制里,你点击一次「不感兴趣」,系统接收到的是一个孤立的负面信号;而现在,如果你告诉它「别推体育新闻,多推独立游戏开发日志,周末想看硬件拆解」,模型能够将这些指令串联成一个长期的用户画像。这意味着你不需要通过反复的手动清理历史记录来「驯化」算法,而是直接通过语义指令定义你的信息流。