RAG 记忆系统中时序变更如何破坏 Agent 的逻辑推理?
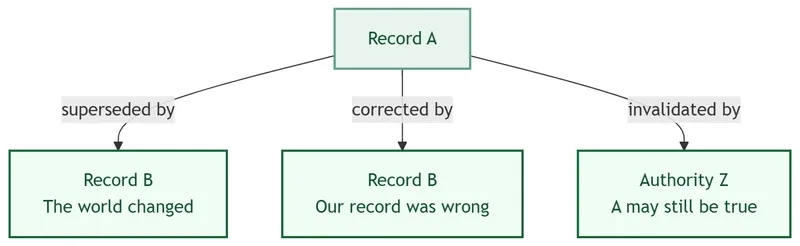
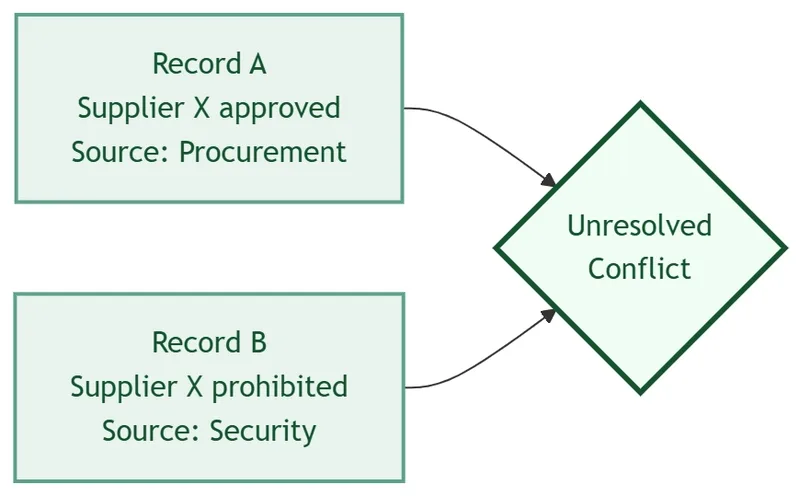
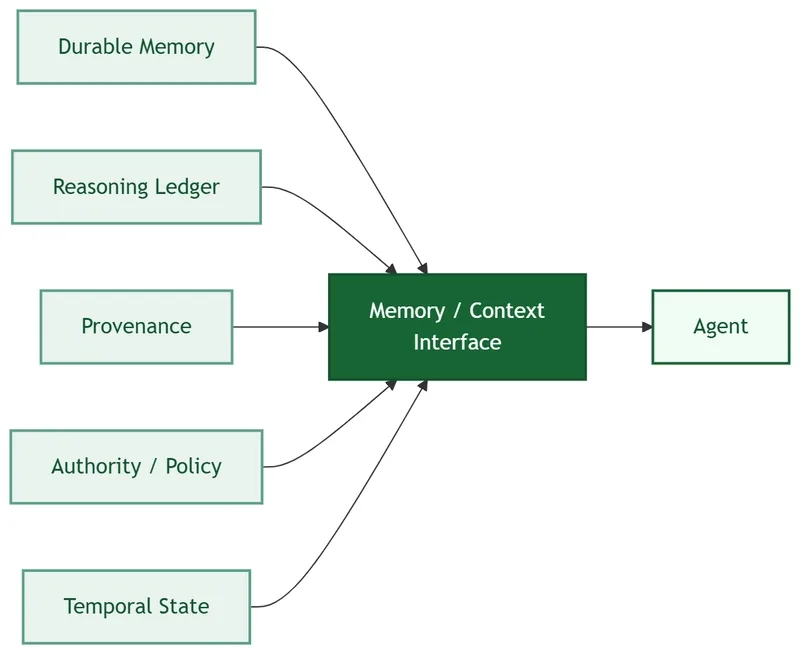
在 Agent 向记忆系统询问「生产库用的啥」时,接口返回的两条记录分别是 PostgreSQL(分数 0.94)和 MongoDB(分数 0.91)。按传统 RAG 模式,Agent 仅凭语义相似度选择 PostgreSQL,结果却发现四个月前架构组已经替换为 MongoDB。问题出在 记录间的时序关系被忽略了。
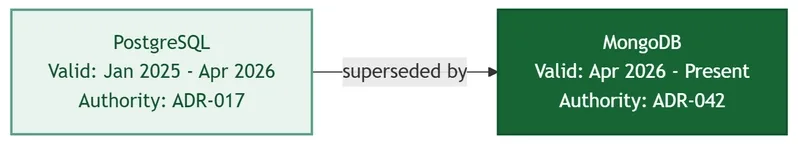
存储层存储的数据库版本变更实际上是双时态建模,SQL:2011 标准早已支持通过时间戳和版本表记录。然而,现有记忆 API 仅返回独立记录列表,没有提供 “当前生效记录”与“被替代记录”之间的关系链,导致 Agent 无法区分“当时的真实”和“现在的假象”。 Edward Izgorodin 在数据库领域指出,“这件事当时是真的、现在已经是假的”问题已十多年未解决,覆盖式更新仍是常见问题。
更复杂的例子来自业务规则变更:记录 A 表示“客户退款需经理审批”,而记录 B 为“100 美元以下退款免审”。在存储层看起来是更新,但在业务逻辑中可能是政策调整、地区差异或纠错。如果将这两条记录压平为权重相同的列表,Agent 无法判断哪条是“当前有效”的,哪条是“过时的”,从而误判决策。这种设计背后的危险假设是:语义相似度等同于当前真实度,但在 Agent 决策中,过时记录的“伪相关”会直接导致错误。
如何从扁平列表升级为图谱结构?
在实际应用中,我将检索接口改为返回「事实图谱片段」,避免扁平列表的局限:
{
  "current_fact": "MongoDB",
  "valid_from": "2026-04-15",
  "supersedes": {
    "fact": "PostgreSQL",
    "valid_until": "2026-04-14",
    "reason": "architecture_decision_2026_q2"
  },
  "confidence": 0.97
}
这样,Agent 可以清晰链接:
- 当前生效的事实是什么?
- 为什么被替代?
- 如果中间存在多阶段变更(如“先用 TiDB 过渡”),图谱也能完整展示。
成本与风险平衡:
构建图谱片段需增加写入时的元数据声明(如 valid_from、valid_until、supersedes),并维护冲突与合并逻辑。但与 Agent 在生产环境中因过时记录导致错误决策相比,工程成本并不高。关键是 Agent 正确率,而不是传统 RAG 中的 Recall@K。
建议步骤:
- 检查存储层是否仍采用覆盖式更新,补全时间戳字段。
- 检索接口尝试返回带边的子图(如增加
supersedes字段)。 - 对高频决策 Agent 物化当前生效视图缓存,避免每次重新遍历图。

全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
把provenance直接压成字符串也太粗暴了,后端内存再大也找不回丢掉的信息量!就像Edward Izgorodin说的「A ranked list has nowhere to put an edge」,接口把记录之间的时序关系丢掉了,比如Agent询问「生产库用的啥?」得到PostgreSQL和MongoDB两条记录,虽然得分高,但实际MongoDB才是当前有效的,这种信息丢失会导致决策错误。
可以在检索接口里把近期记忆的权重提升1.2倍,同时让返回结构加入 valid_from、valid_until 和 supersedes 等字段,形成一个小型事实图谱,这样旧数据会自动被降权,Agent 也能明确哪条记录是当前生效的。
这个 superseded_by 指针要是存在库里,并发写入的时候得冲突死吧。为了避免这个问题,可以在 superseded_by 字段上加一个唯一索引,并使用乐观锁或重试逻辑来处理并发冲突,从而确保原子更新。存储层其实清楚完整情况:PostgreSQL 使用到 2026 年 4 月,之后被 MongoDB 取代。这属于双时态建模,SQL:2011 早就完成了标准化,应用时间加上系统版本表。Edward Izgorodin 在上一篇帖子里提过,数据库领域围绕“这件事当时是真的、现在已经