128GB统一内存让笔记本本地运行千亿参数模型成为可能
联想在IFA 2026上发布的Yoga Pro 9n(国内称YOGA Pro 15 Spark)用128GB统一内存,让一台1.65kg的Windows笔记本直接加载1200亿参数模型,还能维持100万token上下文。AI PC的比拼重心就此从功能型AI转向了本地大模型的装载量。
此前AI PC的讨论多半围着实时翻译、降噪这类功能打转,或者得依赖Mac Studio那样的桌面设备。联想借助RTX Spark芯片,把20核Grace CPU与6144个CUDA核心的Blackwell GPU整合在一起,FP4精度下算出1PFLOPS。NVLink-C2C让CPU和GPU共享同一个128GB物理内存池,本地跑大模型最头疼的显存墙就这么绕过去了。
这在Windows生态里相当于复刻了Apple Silicon的统一内存思路。之前本地推理卡在显存容量上,24GB显存面对千亿参数模型根本不够分。现在CPU和GPU共用128GB物理内存,数据不用在两者间来回拷贝,模型权重也只存一份。
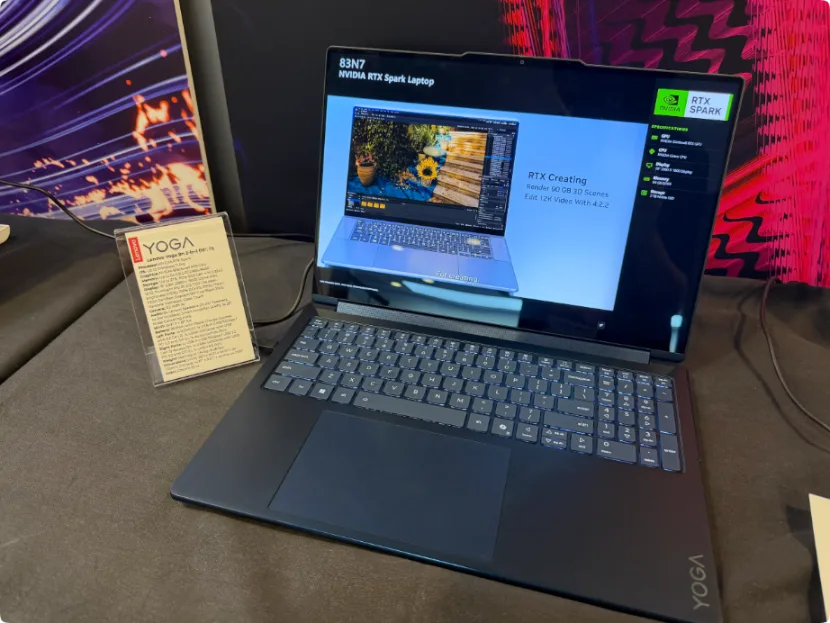
作为对照,M5 Max版MacBook Pro顶配同样是128GB内存,跑120B参数量化模型(4-bit)能到79 token/s,但长上下文一上来内存就被迅速吃光。联想这边走的是CUDA路线,开发者不必去MLX等新框架里重新摸门道,成熟的CUDA工具链直接就能在笔记本上部署本地Agent。
联想还端出了一台1.6升的ThinkCentre X Ultra小主机,用AMD锐龙AI Max+ PRO 495系列,同样支持128GB统一内存,最多4台机器可以组集群互联,办公桌就此变成小型AI算力节点。
端侧AI的竞争指标已经从TFLOPS数字转向模型能不能“装得下”并且“搬得动”。苹果靠统一内存加Thunderbolt集群抢跑,Windows阵营则借RTX Spark把本地上下文拉到100万token的体量。
对AI从业者来说,这套硬件升级意味着项目文档、私有代码和复杂工作流都能留在本地处理,不用上传云端,也不会被网络延迟卡脖子。Windows笔记本能扛住千亿模型,才真正够格当Agent的宿主。
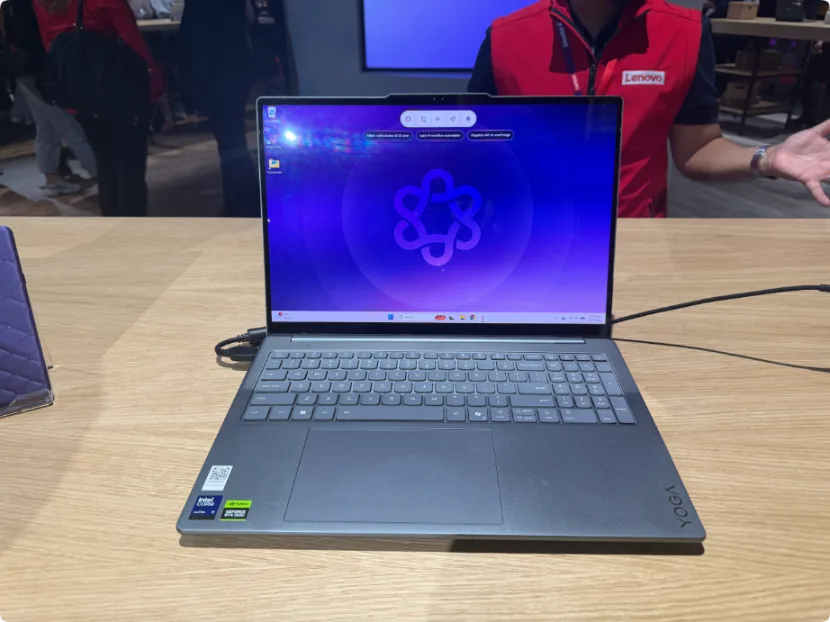
Yoga Pro 9n机身里塞了X Power散热系统,把80W TDP压在超薄设计内,屏幕是2.5K 165Hz OLED。联想还展出两款概念机型——Project Aeroblade用AirJet固态散热,机身厚度不到10mm且没有风扇;Project Swan则是14到17英寸可展开的卷轴屏。
整条链路就是统一内存先撑起千亿模型,再让本地Agent跑起来。Windows在本地大模型这个战场上终于有了跟Mac叫板的硬件底子。
全部回复 (4)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
内存拉满跑本地模型确实太爽了,不再担心对话数据被厂商用作训练数据。联想的 Yoga Pro 9n 通过 128GB 统一内存 让千亿参数模型在 Windows 笔记本上顺利运行,这意味着即使是 1.65kg 的轻薄机,也能在 FP4 精度下提供 1 PFLOPS 的算力,完全解决了之前显存瓶颈问题,让本地 Agent 真正能够支持 100 万 token 的上下文需求。相比之前只能用 24GB 显存的设备,这种架构让开发者无需依赖复杂的新框架,直接利用成熟的 CUDA 生态部署本地 AI 工作流,真正实现了“个人 Agent 主机”的梦想。
散热鳍片薄的话,跑个 9B 量化模型核心温度秒破 85 度,风扇声音堪比直升机起飞,这谁顶得住啊!联想在 IFA 2026 发布的 Yoga Pro 9n(国内名称 YOGA Pro 15 Spark)用 128GB 统一内存把这个可能性实锤了。
别光看参数量,GPTQ-4bit 量化后常识推理经常翻车,上次让我算 1+1=3,这智商掉得比股票还快。这事要是放在联想刚发布的 Yoga Pro 9n(国内称 YOGA Pro 15 Spark)上,说不定还能实时算出来呢。在 1.65kg 的 Windows 笔记本上本地跑起 1200 亿参数、支持 100 万 token 上下文的大模型意味着什么?联想在 IFA 2026 发布的 Yoga Pro 9n(国内名称 YOGA Pro 15 Spark)用 128GB 统一内存把这个可能性实锤了。  此前 AI PC 的讨论点大多集中在实时翻译、降噪等功能性 AI,或者依赖 Mac Studio 等桌面设备。而联想此次将 RTX Spark 芯片放入 16.7 毫米的机身中,核心突破在于 NVLink-C2C 互联,将 20 核 Grace CPU 与 6144 个 CUDA 核心的 Blackwell GPU 结合,在 FP4 精度下可提供 1 PFLOPS 算力。 ## 统一内存架构能否突破显存瓶颈? 这相当于在 Windows 阵营实现了类似 Apple Silicon 的“统一内存”架构。过去本地跑大模型的瓶颈在于显存,即便 24GB 显存面对千亿模型也捉襟见肘。现在 CPU 和 GPU 共享 128GB 物理内存池,无需在两者间搬运数据且模型权重仅需存储一份,解决了本地运行大模型的关键问题。 对比 M5 Max 的 MacBook Pro 顶配 128GB 内存运行 120B 参数量化模型(4-bit)能达到 79 token/s,但长上下文会快速占用内存。联想则依托 CUDA 生态,开发者无需在 MLX 等新框架中摸索,可直接利用成熟的 CUDA 技术栈在笔记本上部署本地 Agent。 ## 个人 Agent 主机将如何改变办公形态? 联想显然在布局“个人 Agent 主机”,除了笔记本,还推出了 1.6 升的 ThinkCentre X Ultra 小盒子,搭载 AMD 锐龙 AI Max+ PRO 495 系列并支持 128GB 统一内存,且支持 4 台集群互联,将办公桌转化为小型 AI 算力节点。 端侧 AI 的竞争
显存带宽确实是硬伤,我拿 M3 Max 测过,低于 128GB/s 的带宽 时 Qwen-72B 的生成速度直接跌到 2 token/s,根本无法使用。不过现在联想的 Yoga Pro 9n 通过 统一内存架构 让 CPU 和 GPU 共享 128GB 内存池,避免了数据搬运瓶颈,这意味着本地运行大模型时不再需要额外关注显存容量,只需确保 NVLink-C2C 互联的高带宽 即可保证流畅的推理速度。