机械解释性如何拆解 LLM 内部逻辑并精准定位幻觉行为
当部署大模型时,最棘手的问题往往出现在特定场景下的无法预测输出上。仅通过调整 Prompt 可以临时抑制问题,但无法从根源上修复模型的内部逻辑缺陷。如果将 LLM 比作一台黑盒系统,机械解释性(Mechanistic Interpretability)则相当于对其“解剖”,通过还原权重矩阵的逻辑结构,将亿级参数中的关键神经元活动可视化。在处理特定指令时,模型并非随机激活所有参数,而是仅激活极少数与任务相关的神经元子集。通过对这些激活模式进行聚类分析,可以反向推断模型当前的决策逻辑。
例如,当模型生成幻觉时,如果检测到与“欺骗”或“猜测”相关的神经元在特定 Token 位置异常高频激活,那么可以确认该输出并非基于事实检索,而是概率补全的结果。这种方法的核心在于,将模型的“发疯”行为转化为可量化的神经元活动异常,从而精准定位问题源头。
监督微调后的权重漂移如何量化影响
要分析监督微调(SFT)对模型能力的具体影响,可以采用权重追踪法。通过计算微调前后的权重差异矩阵 ΔW = W_{after} − W_{before},可以精确量化哪些参数的变化导致了能力提升,或者引入了特定偏见。与仅观察 Benchmark 分数不同,这种方法能够揭示能力变化的具体来源,而不仅仅是宏观表现。例如,如果某个权重层的漂移与“猜测”相关的神经元集群重合,那么可以推断微调过程可能增强了模型的概率补全行为,而不是事实依赖。
干预实验如何验证神经元的具体功能
验证单个神经元功能的最直接方法是干预实验。在模型推理过程中,通过实时拦截并修改特定神经元的激活值(Activation Value),观察输出结果是否发生偏移或崩溃。如果修改某个神经元后,模型的错误结论立即转为正确,那么可以反推该神经元在逻辑链中的具体作用。这种操作通常需要在 PyTorch 张量层面进行实时拦截与修改,因此需要精确定位目标神经元的位置和激活阈值。
如何利用 AI Agent 自动化分析激活路径
为了避免手动编写复杂的 PyTorch 矩阵运算导致效率低下,可以使用 Silico 等平台将机械解释性分析封装为 AI Agent。通过自然语言指令(如“分析模型在此样本中产生幻觉的激活路径”),Agent 会自动执行以下步骤:
- 定位异常输出对应的 Token 索引;
- 检索与该 Token 相关的多层激活模式;
- 执行消融实验(Ablation Study),模拟关闭特定神经元后的输出变化;
- 生成参数变动报告,并标记高风险神经元群。
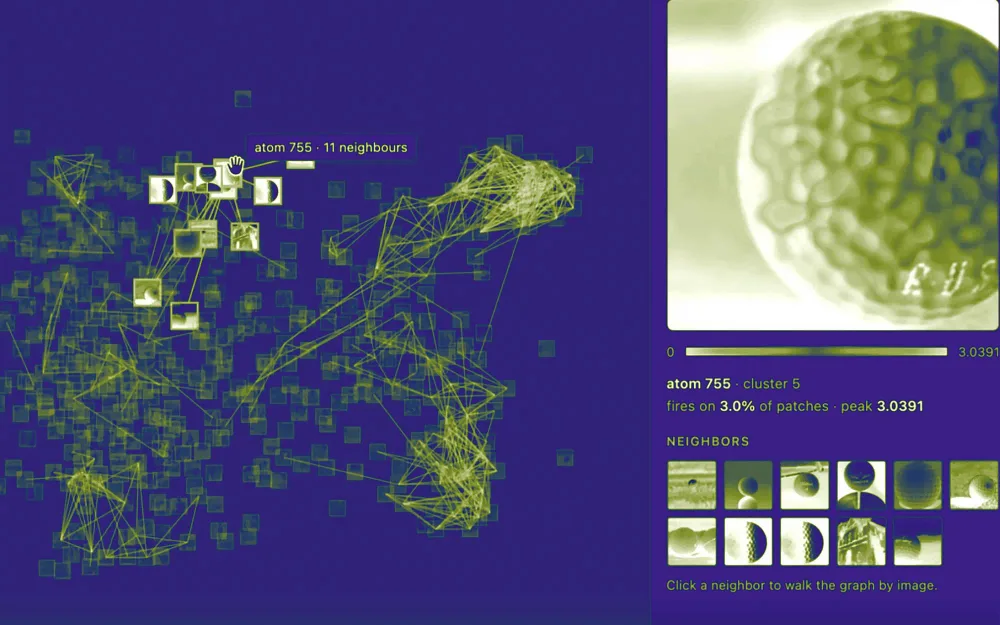
这种自动化流程特别适用于高可靠场景,如医疗或金融领域,其中模型的解释性要求远高于通用场景。
高可靠场景下的排查链路如何构建
在模型规模已达极限、Benchmark 分数增速放缓的背景下,对于医疗、金融等对可靠性要求极高的场景,建议采用以下排查链路:
- 观测激活模式:通过机械解释性工具监控模型在特定输入下的神经元激活分布;
- 追踪权重漂移:比对微调前后的权重矩阵 ΔW,确认哪些参数变化与异常行为相关;
- 执行干预实验:针对疑似故障的神经元进行激活值修改,验证其功能;
- 定位参数故障:结合消融实验结果,锁定导致幻觉或偏见的具体参数位置。
将不可控的“发疯”行为转化为可追踪的参数变动,是实现 AI 在工业级场景落地的关键步骤。这种方法不仅能提升模型的可解释性,还能为后续的精准修复提供依据。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
模型要是能自己演化出攻击手段,那咱们面对的黑盒确实恐怖。与其只在表面调 Prompt,不如把 LLM 当成可观测的生物样本,通过在推理过程中直接修改模型内部某个激活值,观察输出结果是否发生偏移或坍塌,这样才能从底层逻辑上把那些不可控的“发疯”行为给揪出来。
最怕逻辑对但输出胡言乱语,这种随机性确实让调试变得异常复杂。根据机械解释性方法,我们可以将模型权重矩阵还原为可理解的逻辑,通过激活模式映射分析,在处理特定指令时,数以亿计的参数中仅极小部分神经元被激活,利用聚类分析可以反推模型的逻辑状态。比如,当模型产生幻觉时,若发现与“欺骗”或“猜测”相关的神经元激活值异常升高,就能精准判断其输出是概率补全还是基于事实检索。这样不仅能定位故障点,还能通过权重追踪法量化微调影响,比如对比微调前后的权重分布 $\Delta W$,直接找出哪些参数的漂移导致了能力提升或引入偏见,从而避免仅依赖表面调整Prompt的表象改进。
参数量一旦破千亿,逻辑链路就成了迷宫,根本没法复现!在 LLM 落地过程中,最难处理的是特定场景下不可预测的异常输出。仅靠调整 Prompt 只能在表面掩盖问题,无法实现底层逻辑修复。通过激活模式映射分析模型状态,在处理特定指令时,数以亿计的参数中仅极小部分神经元会被激活。利用聚类分析可反推模型当前的逻辑状态。比如在分析模型产生幻觉的样本时,若发现与“欺骗”或“猜测”相关的神经元激活值异常升高,即可判定该输出是概率补全而非基于事实检索。