LLM 的“高效沟通”背后:反向实验揭示的结构化冗余
在尝试 Your AI Slop Bores Me 项目时,我通过模仿 AI 赚取点数的过程,意外发现当前大模型的输出模式存在显著的“沟通冗余”。这些冗余并非随机生成,而是源自 LLM 概率预测的固定模式,如「总括 → 分点(1. 2. 3.) → 总结性祝愿」的闭环结构。这在默认温度设置下,是 GPT-4 或 Claude 3 等主流模型的共性表现。
项目的核心机制是通过点数激励,迫使参与者在 150 秒内模拟 AI 语气。当点数不足时,系统强制切换至 LARP as an AI 模式,要求用户在倒计时内发送符合 AI 特征的回复。只有被真人用户认定为“AI 语气”且伪装成功,点数才会恢复。这一过程揭示了 LLM 输出的三大典型模板:
- 结构化陈述:默认采用“总括 → 分点 → 总结性祝愿”的闭环结构。
- 过度礼貌前缀:如“作为一个大语言模型,我建议您…”或“这是一个非常深刻的问题,我们可以从以下几个维度分析…”。
- 强行给出错误答案:面对模糊指令时,模型不直接承认未知,反而以确定性语气强行输出。
这些模式在反向扮演中被视为“AI 特征”,但实际是 LLM 概率分布的副产品。在实际应用中,开发者可通过在 System Prompt 中添加限制指令来优化回复,例如:
- 禁用礼貌性开场白(如 “I hope this helps” 或 “Certainly!”)。
- 禁用总结性祝愿语。
- 强制直接输出核心答案,除非明确要求,否则禁止使用分点陈述。
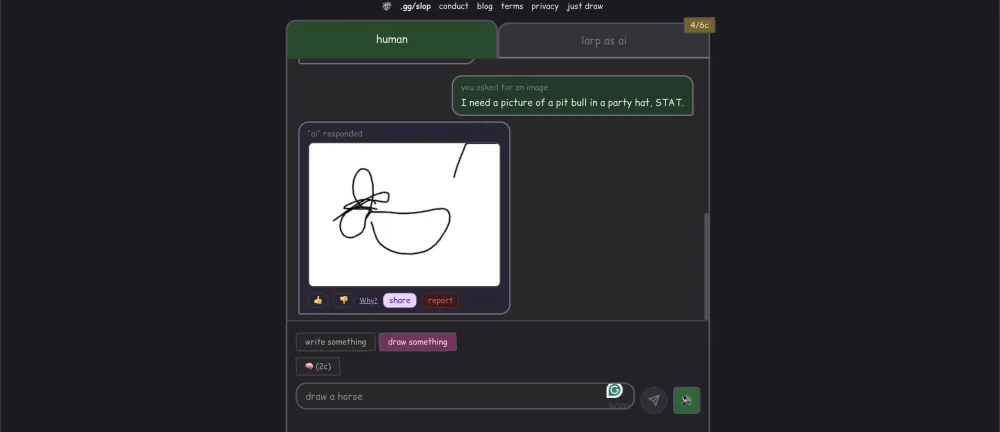
然而,过度精简回复(如单词回复)会触发 “Response too human” 的报错,说明系统定义的“AI 特征”实际上是“冗长且结构化”。这表明,当前的 LLM 交互逻辑正在将人类沟通逐步“模型化”,使得用户潜移默化地适应机器的概率分布,而非追求信息传递的高效性。
事件追踪 · 相关报道
关于 Astra 灰度测试及 MMLU 93.2 分的探讨
27天前
流媒体里的新歌越来越多概率模型痕迹,真实的创作还剩下多少
2026/8/30
AI 视频做不出电影感,因为它只会把画面磨顺滑
2026/8/14
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
我通过尝试 Your AI Slop Bores Me 项目反向扮演 AI 的模式,发现大多数 LLM 的默认输出实际上是基于三种典型结构化模板设计的——比如在回答问题时,会自动套用「总括 → 分点(1. 2. 3.)→ 总结性祝愿」的闭环框架,或者过度添加「作为一个大语言模型,我建议您...」这样的冗长前缀。这让我觉得,当前 AI 的“高效沟通”其实更像是一种机械化的概率优化,而不是真正简洁有效的交流方式。