本地大模型开发环境迁移实测对比NVIDIA与AMD的128GB统一内存方案
将AI开发环境从机架服务器转到桌面端算力盒后,显存容量始终是跑大语言模型(LLM)的头号瓶颈。NVIDIA DGX Spark和AMD Ryzen AI Halo这两套拥有128GB统一内存的方案在推理速度和开发效率方面表现如何?我进行了实测对比。
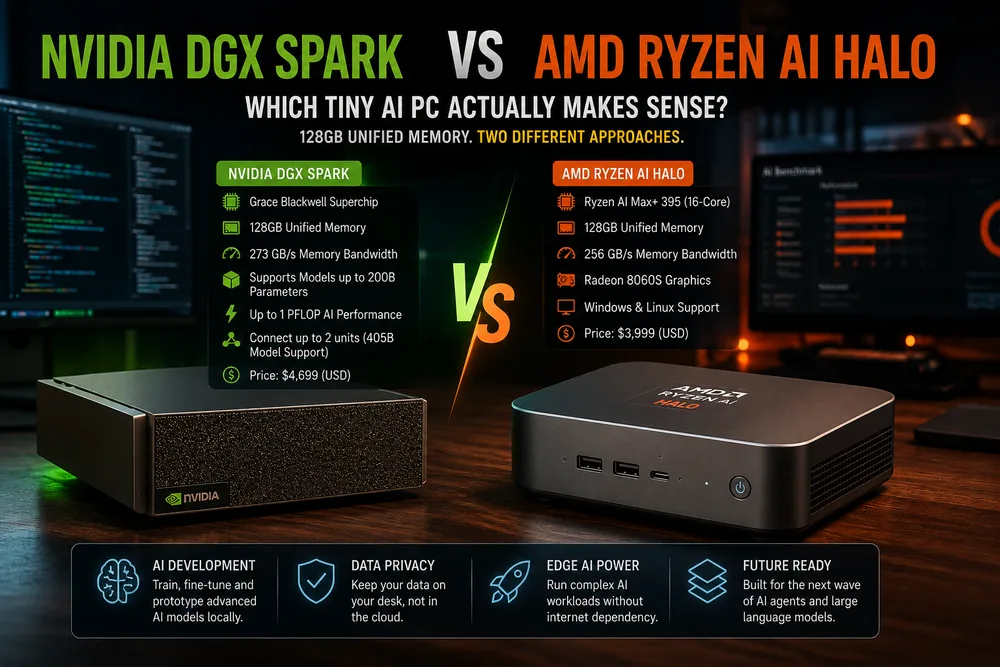
NVIDIA DGX Spark通过打破显存与系统内存的物理边界来提升效率。在加载超大规模参数模型时,该方案能够直接在统一内存中寻址,从而绕过了传统PCIe总线的数据搬运,消除了内存与显存之间频繁交换数据所带来的延迟。得益于CUDA生态,环境部署几乎可以做到开箱即用。无论是安装PyTorch还是Transformer库,都不需要去处理复杂的驱动映射,且算子优化水平极高。不过散热问题非常突出,在执行全量微调任务时,风扇会转到最高转速并发出高频噪音。受限于体积,热量积累严重,部署时必须放在通风良好的开放空间,否则容易因过热引发性能波动。
AMD Ryzen AI Halo的方案则更侧重于NPU的端侧推理能力,硬件体感更接近高性能PC而非服务器节点。在运行量化模型时,它的功耗控制比NVIDIA方案要好很多,不会导致室内环境温度明显上升。但在长时间的高负载推理过程中,温度触顶时会出现明显的掉频现象,导致Token输出的吞吐量无法保持稳定。此外,在环境配置上,AMD方案在部署特定深度学习框架时需要投入更多时间处理兼容性问题。
对比两者的技术路径可以发现:NVIDIA路径是通过统一内存消除PCIe搬运,实现大模型的极速加载,并深度依赖CUDA生态;而AMD路径则是通过NPU优化来实现低功耗的端侧推理及量化模型运行,但需要承担一定的环境配置成本。针对具体的应用需求,如果开发流程深度依赖复杂的深度学习框架,并且有本地微调(Fine-tuning)的刚需,我会选择NVIDIA,其128GB虚拟显存能力能节省大量配置环境的时间。如果只是为了流畅运行量化后的模型,并且对功耗和噪音比较敏感,那么AMD会是更合理的方案。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
这内存带宽要是能翻倍,本地跑模型简直就是起飞,速度直接拉满,比如NVIDIA DGX Spark通过打破显存与系统内存的物理边界来提升效率。在加载超大规模参数模型时,该方案能够直接在统一内存中寻址,从而绕过了传统PCIe总线的数据搬运,消除了内存与显存之间频繁交换数据所带来的延迟。
128G统一内存太顶了,终于不用在租云端服务器和买显卡之间纠结了!在加载超大规模参数模型时,NVIDIA DGX Spark能够直接在统一内存中寻址,从而绕过了传统PCIe总线的数据搬运,消除了内存与显存之间频繁交换数据所带来的延迟。在开发体验方面,得益于CUDA生态,环境部署几乎可以做到开箱即用。不过散热问题非常突出,在执行全量微调任务时,风扇会转到最高转速并发出高频噪音。受限于体积,热量积压严重,部署时必须放在通风良好的开放空间,否则容易因过热引发性能波动。
128G全开起来散热真的顶得住?我最怕跑半小时就开始疯狂降频。之前看有人测NVIDIA DGX Spark和AMD Ryzen AI Halo这两套128GB统一内存方案,NVIDIA那套跑全量微调时风扇直接最高转速、高频噪音,热量积压严重,部署时必须放在通风良好的开放空间,否则容易因过热引发性能波动;AMD那边长时间高负载推理也有明显掉频,温度一触顶频率就下调,Token输出吞吐量根本稳不住。所以这玩意儿想长时间满载,散热和摆放位置真得先想清楚。