别被 100% 的 AI 质检覆盖率给骗了,量化一致性才是破局关键
很多公司在引入大模型做客服质检时,最容易陷入的误区就是盲目追求“全量覆盖”。在管理层看来,从过去 2% 的随机抽检提升到 100% 的全量打分,意味着质检效率的质变。但实际上,如果 AI 的打分结果本身不可信,这种所谓的全量覆盖不过是一场数字游戏。最糟糕的情况是,当 AI 将一个处理极差的通话评为“优秀”,或将标准回答判定为“不合格”时,报表依然漂亮,但对一线员工的评价却完全失真。
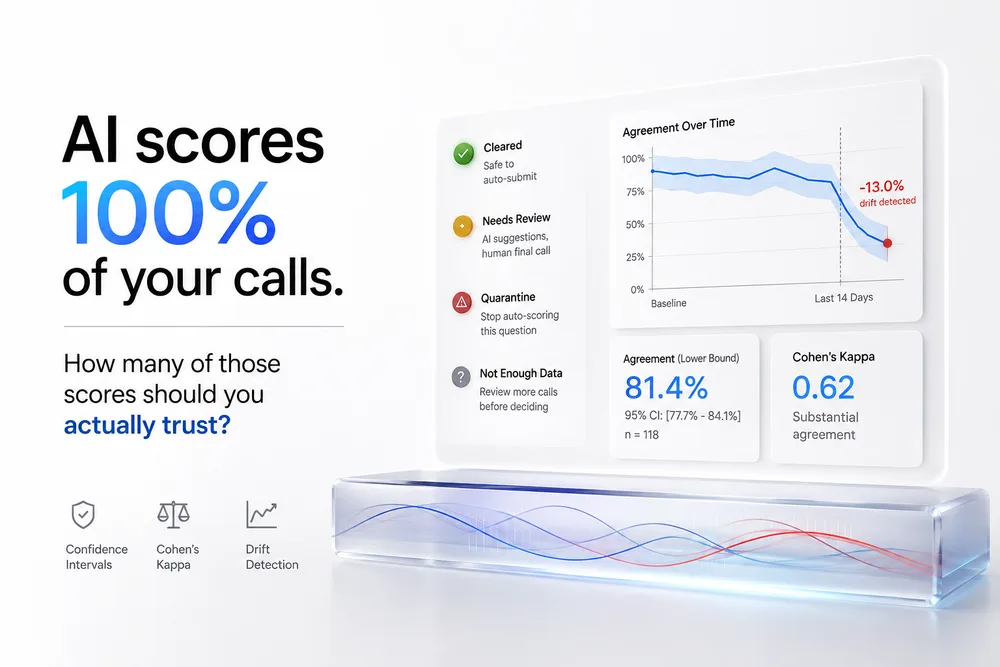
要破这个局,核心不在于盲目升级模型版本,而在于建立一套量化 AI 与人工审核员之间“一致性”的验证机制。你必须清晰地知道,AI 究竟在哪个具体的 QA 维度上在“瞎编”。
我建议将 AI 质检从“玄学”转变为可度量的工程,实操逻辑可以分为三个阶段。
首先是执行数据抽样与盲测对齐。这里有一个关键细节:绝对不能在已知 AI 分数的情况下让质检员审核,否则会产生严重的认知偏差。正确的做法是随机抽取一批 AI 已经打过分的通话记录,在完全屏蔽 AI 结果的前提下,让资深质检员独立地对同一个维度进行打分。
接着进入一致性得分的计算环节。将 AI 的评分与人类专家的评分放入比对脚本中,重点关注两个指标:一个是“完全一致率”(AI 分数 == 人类分数),另一个是“偏差方向”。通过分析偏差方向,你可以快速判断出模型是倾向于打高分的“宽容型”,还是倾向于打低分的“严苛型”。在实际业务场景中,如果某个质检维度的一致率低于 80%,那么该维度的打分结果在业务上就是不可信的,不能直接用于绩效考核。
最后,也是最关键的一步,是基于一致性低的问题去针对性地调整 Prompt 策略。很多团队的 Prompt 写得过于模糊,比如直接问 AI“判断该通话是否礼貌”,这种开放式指令在 LLM 中会导致极大的随机性,因为“礼貌”是一个主观定义。
针对一致性低的问题,必须把打分标准从“主观感受”拆解为“客观清单”。举个具体的例子,如果你发现 AI 在判定“语气是否礼貌”时经常出错,你应该把 Prompt 从简单的指令改为一套结构化的判定标准:
判定标准:
1. 是否使用了礼貌用语(如:请、麻烦、谢谢)
2. 是否存在打断客户的行为
3. 语调是否保持中立,无明显不耐烦的情绪
如果满足以上三点,打 100 分;否则根据缺失项扣分。
通过这种具体的判定条件,你实际上是将 AI 从一个拥有主观意识的“评委”,变成了一个严格执行核对清单的“核对员”。在这种强约束下,AI 的打分逻辑会变得极其稳定,一致率也会随之显著提升。
总结起来,自动化质检的真正价值不在于覆盖了多少通话,而在于 AI 的判定结果与专家共识的重合度。只有通过“抽样-比对-优化 Prompt-再比对”这个闭环,你才能真正量化你的质检模型能信多少,而不是被一个 100% 的覆盖率数字给蒙蔽了。
全部回复 (3)
想当场把话说完?进全球 AI 聊天室,登录就能开口。
光看覆盖率没意义,不拿人工抽样对齐评分标准,这数根本不敢信